
Andersons vinkel
ST-NeRF: Komposition och redigering för videosyntes

 Lägg till Unite.AI bland dina föredragna källor på Google

Ett kinesiskt forskningskonsortium har utvecklat tekniker för att bringa redigerings- och kompositionsförmågor till en av de hetaste bildsyntesforskningssektorerna under det senaste året – Neurala Radiance Fields (NeRF). Systemet kallas ST-NeRF (Spatio-Temporal Coherent Neural Radiance Field).
Vad som verkar vara en fysisk kamerarörelse i bilden nedan är i själva verket bara en användare som “scrollar” genom vypunkter på videoinnehåll som existerar i ett 4D-utrymme. POV är inte låst till prestationen av de avbildade personerna i videon, vars rörelser kan ses från valfri del av en 180-graders radius.
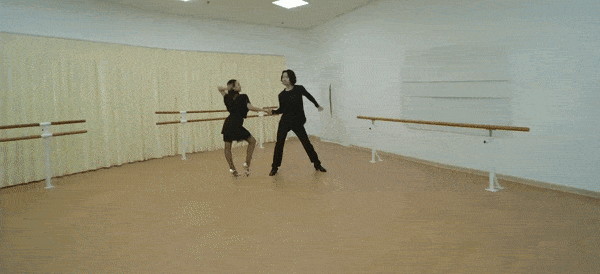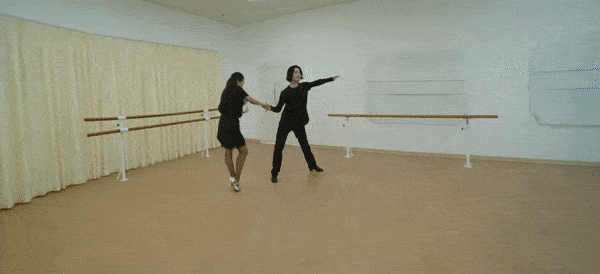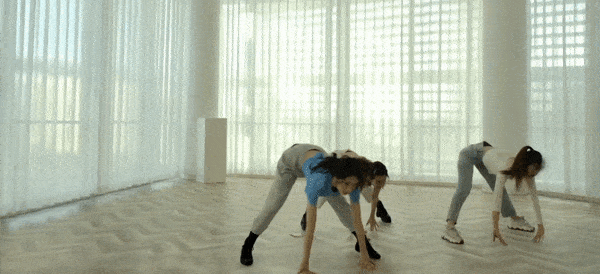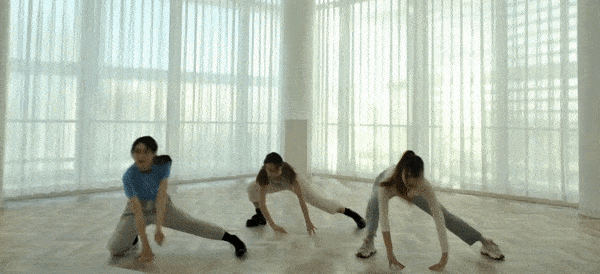
Varje fasett inom videon är ett diskret inspelat element, komponerat ihop till en sammanhängande scen som kan utforskas dynamiskt.
Fasetterna kan fritt dupliceras inom scenen eller ändras i storlek:
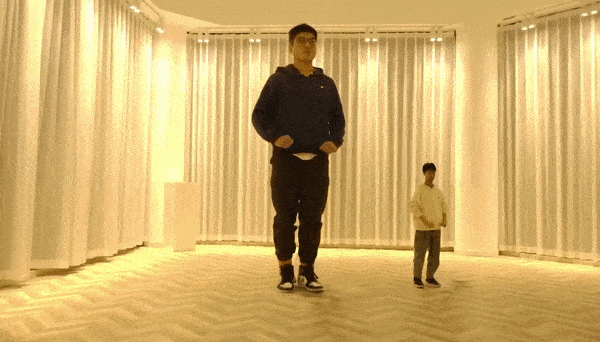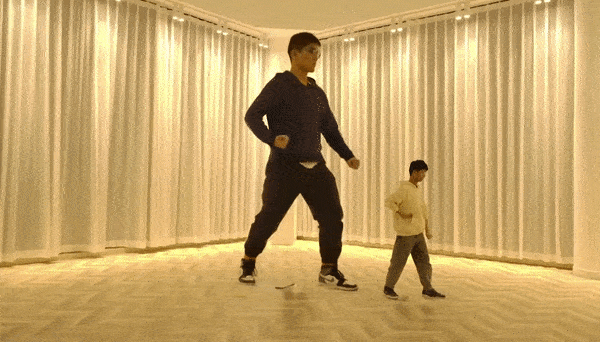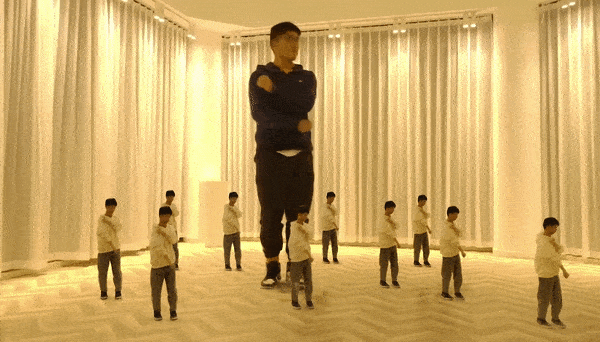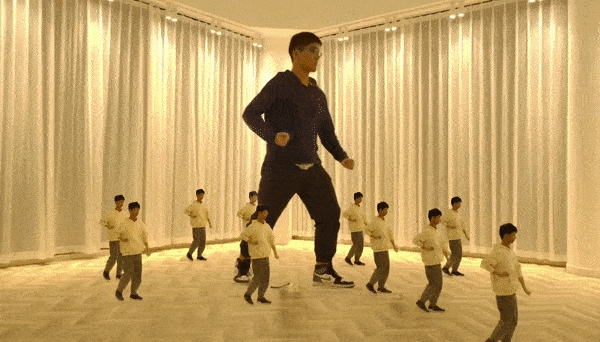
Dessutom kan den temporala beteendet hos varje fasett enkelt ändras, sakta ner, köras baklänges eller manipuleras på något sätt, vilket öppnar vägen för filterarkitekturer och en extremt hög nivå av tolkbarhet.
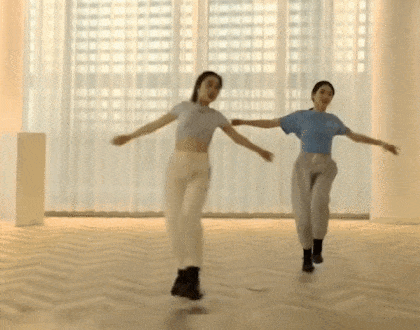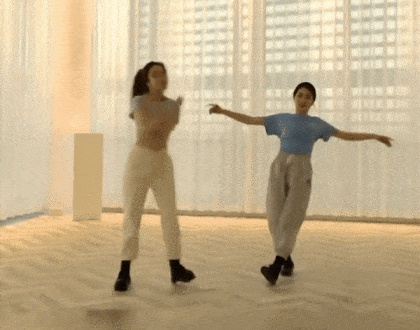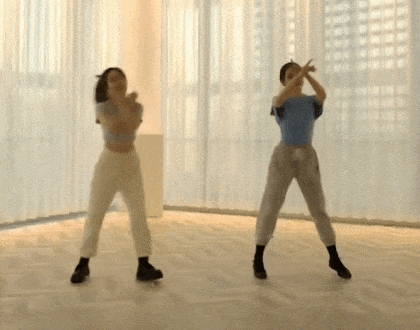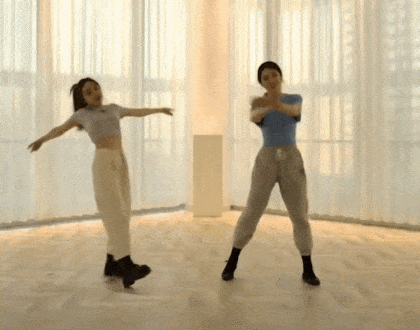
Två separata NeRF-fasetter som körs i olika hastigheter i samma scen. Källa: https://www.youtube.com/watch?v=Wp4HfOwFGP4

Det finns inget behov av att rotoscopera utövare eller miljöer, eller att utövare utför sina rörelser blint och utanför den avsedda scenen. Istället fångas filmen naturligt via en matris av 16 videokameror som täcker 180 grader:


De tre elementen som visas ovan, de två personerna och miljön, är distinkta och konturerade endast för illustrativa ändamål. Var och en kan bytas ut, och var och en kan infogas i scenen vid en tidigare eller senare punkt i deras individuella inspelningstidslinje.
ST-NeRF är en innovation inom forskning om Neurala Radiance Fields (NeRF), ett maskinlärningsramverk där flera vyinspelningar syntetiseras till ett navigerbart virtuellt utrymme genom omfattande träning (även om enstaka vyinspelning också är en undersektor av NeRF-forskning).

Neurala Radiance Fields fungerar genom att samla in flera vyinspelningar till ett enda sammanhängande och navigerbart 3D-utrymme, med luckor mellan täckningen uppskattade och renderade av ett neuronnät. När video (i stället för stillbilder) används, är de renderingsresurser som behövs ofta betydande. Källa: https://www.matthewtancik.com/nerf
Intresset för NeRF har blivit intensivt under de senaste nio månaderna, och en Reddit-underhållen lista över derivativa eller utforskande NeRF-papper listar för närvarande sextio projekt.

Bara några av de många grenarna av det ursprungliga NeRF-papperet. Källa: https://crossminds.ai/graphlist/nerf-neural-radiance-fields-ai-research-graph-60708936c8663c4cfa875fc2/
Billig träning
Papperet är ett samarbete mellan forskare vid Shanghai Tech University och DGene Digital Technology, och har accepterats med viss entusiasm på Open Review.
ST-NeRF erbjuder ett antal innovationer jämfört med tidigare initiativ inom ML-derivata navigerbara videosytor. Inte minst uppnår det en hög nivå av realism med endast 16 kameror. Även om Facebooks DyNeRF använder endast två kameror mer än detta, erbjuder det en betydligt mer begränsad navigerbar båge.
Ett exempel på Facebooks DyNeRF-miljö, med en mer begränsad rörelsefrihet, och fler kameror per kvadratfot behövs för att rekonstruera scenen. Källa: https://neural-3d-video.github.io
Förutom att sakna förmågan att redigera och komponera individuella fasetter, är DyNeRF särskilt dyrt i termer av beräkningsresurser. I kontrast hävdar de kinesiska forskarna att träningskostnaden för deras data ligger någonstans mellan $900-$3,000, jämfört med $30,000 för den state-of-the-art-videogenereringsmodellen DVDGAN, och intensiva system som DyNeRF.
Granskare har också noterat att ST-NeRF gör en stor innovation i att koppla loss processen att lära sig rörelse från processen att syntetisera bilder. Denna separation är vad som möjliggör redigering och komposition, med tidigare tillvägagångssätt som är begränsade och linjära i jämförelse.
Även om 16 kameror är en mycket begränsad matris för en sådan full halvcirkel av vy, hoppas forskarna att kunna minska detta antal ytterligare i senare arbete genom att använda proxy-förinspelade statiska bakgrunder och mer data-drivna scenmodelleringstillvägagångssätt. De hoppas också att införa om-belysningsförmågor, en senaste innovation inom NeRF-forskning.
Att hantera begränsningarna i ST-NeRF
I sammanhanget av akademiska CS-papper som tenderar att förstöra den faktiska användbarheten av ett nytt system i en slängande avslutande paragraf, är till och med de begränsningar som forskarna erkänner för ST-NeRF ovanliga.
De observerar att systemet för närvarande inte kan individuera och separat rendera ut särskilda objekt i en scen, eftersom personerna i filmen segmenteras i individuella enheter via ett system som är utformat för att känna igen människor och inte objekt – ett problem som verkar lätt att lösa med YOLO och liknande ramverk, med det svårare arbetet att extrahera mänsklig video redan utfört.
Även om forskarna noterar att det för närvarande inte är möjligt att generera slow-motion, verkar det finnas lite som förhindrar implementeringen av detta med hjälp av befintliga innovationer inom raminterpolation som DAIN och RIFE.
Som med alla NeRF-implementationer, och i många andra sektorer av datorseende-forskning, kan ST-NeRF misslyckas i fall av svår ocklusion, där ämnet är tillfälligt dolt av en annan person eller ett föremål, och kan vara svårt att kontinuerligt spåra eller att återvinna med precision efteråt. Som annars kan denna svårighet behöva vänta på uppströmslösningar. Under tiden medger forskarna att manuell ingripande är nödvändigt i dessa ockluderade ramar.
Slutligen observerar forskarna att de mänskliga segmenteringsförfarandena för närvarande förlitar sig på färgskillnader, vilket kan leda till oavsiktlig sammanfogning av två personer till en segmenteringsblock – en stötesten som inte är begränsad till ST-NeRF, men är intrinsic till den bibliotek som används, och som kanske kan lösas med optisk flödesanalys och andra framväxande tekniker.
Publicerad första gången 7 maj 2021.


