
AI-modeller och plattformar
Innanför OpenAI:s o3 och o4-mini: Låser upp nya möjligheter genom multimodalt resonemang och integrerade verktygssatser

 Lägg till Unite.AI bland dina föredragna källor på Google
Den 16 april 2025 släppte OpenAI uppgraderade versioner av sina avancerade resonemodeller. Dessa nya modeller, som heter o3 och o4-mini, erbjuder förbättringar jämfört med deras föregångare, o1 och o3-mini. De senaste modellerna levererar förbättrad prestanda, nya funktioner och större tillgänglighet. Den här artikeln undersöker de primära fördelarna med o3 och o4-mini, beskriver deras huvudsakliga funktioner och diskuterar hur de kan påverka framtiden för AI-tillämpningar. Men innan vi dyker in i vad som gör o3 och o4-mini distinkta, är det viktigt att förstå hur OpenAI:s modeller har utvecklats över tid. Låt oss börja med en kort översikt av OpenAI:s resa i att utveckla alltmer kraftfulla språk- och resonemodeller.
OpenAI:s utveckling av stora språkmodeller
OpenAI:s utveckling av stora språkmodeller började med GPT-2 och GPT-3, som förde ChatGPT till mainstream-användning på grund av deras förmåga att producera flytande och sammanhangsriktig text. Dessa modeller antogs i stor utsträckning för uppgifter som sammanfattning, översättning och frågesvar. Men när användare tillämpade dem på mer komplexa scenarier, blev deras brister uppenbara. Dessa modeller kämpade ofta med uppgifter som krävde djupt resonemang, logisk konsekvens och flerstegsproblemlösning. För att hantera dessa utmaningar introducerade OpenAI GPT-4 och skiftade sin fokus mot att förbättra resonemangsförmågan hos sina modeller. Detta skifte ledde till utvecklingen av o1 och o3-mini. Båda modellerna använde en metod som kallades chain-of-thought-prompting, som tillät dem att generera mer logiska och precisa svar genom att resonera steg för steg. Medan o1 är utformat för avancerade problemlösningsbehov, är o3-mini byggt för att leverera liknande funktioner på ett mer effektivt och kostnadseffektivt sätt. Utifrån denna grund har OpenAI nu introducerat o3 och o4-mini, som ytterligare förbättrar resonemangsförmågan hos deras LLM. Dessa modeller är konstruerade för att producera mer precisa och välgenomtänkta svar, särskilt inom tekniska områden som programmering, matematik och vetenskaplig analys – områden där logisk precision är avgörande. I följande avsnitt kommer vi att undersöka hur o3 och o4-mini förbättrar sina föregångare.
Nyckelförbättringar i o3 och o4-mini
Förbättrade resonemangsförmågor
En av de viktigaste förbättringarna i o3 och o4-mini är deras förbättrade resonemangsförmåga för komplexa uppgifter. Till skillnad från tidigare modeller som levererade snabba svar, tar o3- och o4-mini-modellerna mer tid att bearbeta varje prompt. Denna extra bearbetning tillåter dem att resonera mer grundligt och producera mer precisa svar, vilket leder till förbättrade resultat på benchmark. Till exempel överträffar o3 o1 med 9% på LiveBench.ai, en benchmark som utvärderar prestanda över flera komplexa uppgifter som logik, matematik och kod. På SWE-bench, som testar resonemang i programvaruutvecklingsuppgifter, uppnådde o3 en poäng på 69,1%, och överträffade till och med konkurrerande modeller som Gemini 2.5 Pro, som fick 63,8%. Samtidigt fick o4-mini en poäng på 68,1% på samma benchmark, och erbjöd nästan samma resonemangsdjup till en mycket lägre kostnad.
Multimodalt integrerande: Tänkande med bilder
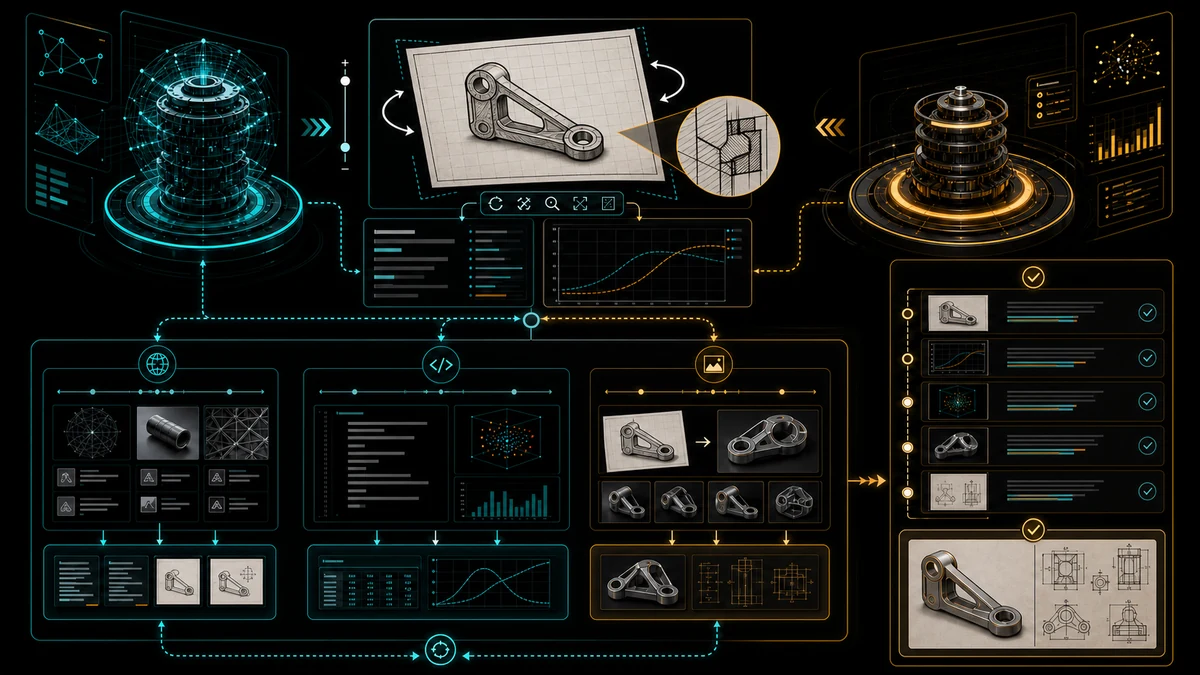
En av de mest innovativa funktionerna i o3 och o4-mini är deras förmåga att “tänka med bilder”. Detta innebär att de inte bara kan bearbeta textuell information, utan också integrera visuell data direkt i sin resonansprocess. De kan förstå och analysera bilder, även om de är av låg kvalitet – som handskrivna anteckningar, skisser eller diagram. Till exempel kunde en användare ladda upp ett diagram över ett komplext system, och modellen kunde analysera det, identifiera potentiella problem eller till och med föreslå förbättringar. Denna funktion brottar klyftan mellan textuell och visuell data, och möjliggör mer intuitiva och omfattande interaktioner med AI. Båda modellerna kan utföra åtgärder som att zooma in på detaljer eller rotera bilder för att bättre förstå dem. Detta multimodala resonemang är en betydande förbättring jämfört med föregångare som o1, som främst var textbaserade. Det öppnar nya möjligheter för tillämpningar inom områden som utbildning, där visuella hjälpmedel är avgörande, och forskning, där diagram och grafer ofta är centrala för förståelse.
Avancerad verktygsanvändning
o3 och o4-mini är de första OpenAI-modellerna som använder alla verktyg som finns tillgängliga i ChatGPT samtidigt. Dessa verktyg inkluderar:
- Webbläsningsfunktion: Tillåter modellerna att hämta den senaste informationen för tidskänsliga frågor.
- Pythonkodexekvering: Möjliggör att de kan utföra komplexa beräkningar eller dataanalys.
- Bildbearbetning och generering: Förbättrar deras förmåga att arbeta med visuell data.
Genom att använda dessa verktyg kan o3 och o4-mini lösa komplexa, flerstegsproblem mer effektivt. Till exempel, om en användare ställer en fråga som kräver aktuell data, kan modellen utföra en webbsökning för att hämta den senaste informationen. Likaså, för uppgifter som involverar dataanalys, kan den köra Pythonkod för att bearbeta data. Denna integration är ett betydande steg mot mer autonoma AI-agenter som kan hantera en bredare range av uppgifter utan mänskligt ingripande. Införandet av Codex CLI, en lätt, öppen källkodskodagent som fungerar med o3 och o4-mini, förbättrar ytterligare deras användbarhet för utvecklare.
Konsekvenser och nya möjligheter
Släppandet av o3 och o4-mini har långtgående konsekvenser över hela branschen:
- Utbildning: Dessa modeller kan hjälpa studenter och lärare genom att tillhandahålla detaljerade förklaringar och visuella hjälpmedel, vilket gör lärandet mer interaktivt och effektivt. Till exempel kunde en student ladda upp en skiss av ett matematikproblem, och modellen kunde tillhandahålla en steg-för-steg-lösning.
- Forskning: De kan påskynda upptäckter genom att analysera komplexa datamängder, generera hypoteser och tolka visuell data som diagram och grafer, vilket är ovärderligt för områden som fysik eller biologi.
- Industri: De kan optimera processer, förbättra beslutsfattandet och förbättra kundinteraktioner genom att hantera både textuell och visuell information, som att analysera produktutformningar eller felsöka tekniska problem.
- Kreativitet och media: Författare kan använda dessa modeller för att omvandla kapitelutkast till enkla storyboard. Musiker kan matcha visuella element till en melodi. Filmredigerare kan få förslag på tempo. Arkitekter kan omvandla handritade golvytor till detaljerade 3D-ritningar som inkluderar struktur- och hållbarhetsanteckningar.
- Tillgänglighet och inkludering: För blinda användare beskriver modellerna bilder i detalj. För döva användare kan de omvandla diagram till visuella sekvenser eller undertext. Deras översättning av både ord och visuella element hjälper till att brottas klyftan mellan språk och kulturella skillnader.
- Mot autonoma agenter: Eftersom modellerna kan bläddra i webben, köra kod och bearbeta bilder i en arbetsflöde, utgör de grunden för autonoma agenter. Utvecklare beskriver en funktion; modellen skriver, testar och distribuerar koden. Kunskapsarbetare kan delegera datainsamling, analys, visualisering och rapportskrivning till en enda AI-assistent.
Begränsningar och vad som kommer härnäst
Trots dessa framsteg har o3 och o4-mini fortfarande en kunskapsgräns på augusti 2023, vilket begränsar deras förmåga att svara på de senaste händelserna eller teknologierna om de inte kompletteras med webbläsningsfunktion. Framtida iterationer kommer sannolikt att hantera denna lucka genom att förbättra realtidsdatainmatning.
Vi kan också förvänta oss ytterligare framsteg inom autonoma AI-agenter – system som kan planera, resonera, agera och lära sig kontinuerligt med minimal övervakning. OpenAI:s integration av verktyg, resonemodeller och realtidsdataåtkomst signalerar att vi rör oss mot sådana system.
Sammanfattning
OpenAI:s nya modeller, o3 och o4-mini, erbjuder förbättringar inom resonemang, multimodalt förstående och verktygsintegration. De är mer precisa, mångsidiga och användbara över en bred range av uppgifter – från att analysera komplexa data och generera kod till att tolka bilder. Dessa framsteg har potentialen att signifikant förbättra produktivitet och påskynda innovation över olika branscher.





