
Andersons vinkel
Hur Stable Diffusion kan utvecklas till en konsumentprodukt för den breda marknaden

 Lägg till Unite.AI bland dina föredragna källor på Google
Viktiga punkterEn mainstream Stable Diffusion-app måste lösa sina komplexa kommandoradsinstallations…
Visa mer
- En mainstream Stable Diffusion-app måste lösa sina komplexa kommandoradsinstallations- och beroendeproblem.
- Kommersiella utvecklare står inför juridiska risker från deepfake-generering och NSFW-innehållsfilter.
- Avancerade funktioner som temporal konsistens och textual inversion kräver molnbaserad bearbetning för konsumentanvändning.
Ironiskt nog är Stable Diffusion, det nya ramverket för AI-bildsyntes som tagit världen med storm, varken stabilt eller särskilt utspritt — åtminstone inte ännu.
Systemets hela kapacitet är fördelad över en brokig samling ständigt föränderliga erbjudanden från en handfull utvecklare som febrilt utbyter de senaste rönen och teorierna i olika diskussioner på Discord. De allra flesta installationsförfaranden för paketen de skapar eller modifierar är långt ifrån plug-and-play.
I stället krävs ofta installation via kommandoraden eller BAT-filer med GIT, Conda, Python, Miniconda och andra utvecklingsmiljöer i teknikens framkant. Programvarupaketen är så ovanliga bland vanliga konsumenter att installationen ofta flaggas av antivirus- och antiskadeprogram som ett tecken på att datorn har komprometterats.

Bara ett litet urval av alla steg som en vanlig installation av Stable Diffusion för närvarande kräver. Många distributioner kräver också särskilda Python-versioner, som kan krocka med befintliga versioner på användarens dator. Det går att undvika med Docker-baserade installationer och, i viss mån, med Conda-miljöer.
Meddelandetrådarna i både SFW- och NSFW-grupper för Stable Diffusion är fyllda med tips om att ändra Python-skript och standardinstallationer för att förbättra funktionerna eller lösa vanliga beroendefel och andra problem.
Det gör att vanliga konsumenter som vill skapa fantastiska bilder från textprompter i stort sett är utlämnade åt ett växande antal avgiftsbelagda API-baserade webbgränssnitt. De flesta erbjuder bara några få gratis bilder innan användaren måste köpa token.
Nästan alla dessa webbtjänster vägrar dessutom att skapa NSFW-innehåll. Mycket av detta kan gälla icke-pornografiska ämnen av allmänt intresse, såsom krig, och det är just denna möjlighet som skiljer Stable Diffusion från OpenAI:s censurerade DALL-E 2-tjänster.
Photoshop för Stable Diffusion
De fantastiska, vågade eller utomvärldsliga bilder som dagligen fyller Twitters hashtag #stablediffusion lockar många. Vad den breda publiken förmodligen väntar på är Photoshop för Stable Diffusion — ett installerbart program för flera plattformar som förenar de bästa och kraftfullaste funktionerna i Stability.ai:s arkitektur med SD-utvecklarnas uppfinningsrika innovationer, utan svävande kommandofönster, svårbegripliga och ständigt föränderliga installations- och uppdateringsrutiner eller saknade funktioner.
I de mer kapabla installationerna har vi i dag i stället en mer eller mindre elegant webbsida kopplad till ett separat kommandofönster, med en URL som pekar på en localhost-port:

Liksom kommandoradsstyrda syntesprogram som FaceSwap och det BAT-baserade DeepFaceLab visar den färdigpaketerade installationen av Stable Diffusion sina kommandoradsrötter. Gränssnittet nås via en localhost-port, se bildens överkant, som kommunicerar med funktionerna i kommandoradsversionen.
En smidigare applikation är utan tvivel på väg. Det finns redan flera sammanhållna Patreon-baserade program att ladda ned, såsom GRisk och NMKD (se bilden nedan), men inget förenar ännu alla funktioner som vissa mer avancerade och svåråtkomliga implementationer av Stable Diffusion erbjuder.

Tidiga Patreon-baserade paket av Stable Diffusion, försiktigt omformade till appar. NMKD är först med att integrera kommandoradens utdata direkt i det grafiska gränssnittet.
Låt oss se hur en mer genomarbetad och sammanhållen implementation av detta häpnadsväckande projekt med öppen källkod skulle kunna se ut, och vilka utmaningar den kan möta.
Juridiska överväganden för en välfinansierad kommersiell Stable Diffusion-applikation
NSFW-faktorn
Källkoden till Stable Diffusion har släppts med en mycket tillåtande licens som inte förbjuder kommersiella nyimplementationer eller härledda verk som bygger omfattande på källkoden.
Utöver de tidigare nämnda och allt fler Patreon-baserade versionerna utvecklas många insticksprogram för Figma, Krita, Photoshop, GIMP och Blender med flera. Det finns inget praktiskt skäl till att ett välfinansierat programvaruföretag inte skulle kunna utveckla en betydligt mer sofistikerad och kapabel Stable Diffusion-applikation. Ur marknadsperspektiv finns all anledning att tro att flera sådana initiativ redan kommit långt.
Dessa projekt ställs omedelbart inför frågan om programmet, liksom flertalet webb-API:er för Stable Diffusion, ska tillåta att systemets inbyggda NSFW-filter, ett kodfragment, stängs av.
Att gömma NSFW-reglaget
Stability.ai:s licens för Stable Diffusion innehåller visserligen en brett tolkningsbar lista över användningar där programmet inte får användas, vilket kan anses omfatta pornografiskt innehåll och deepfakes. Men det enda effektiva sättet för en leverantör att förbjuda sådan användning vore att kompilera NSFW-filtret till en ogenomskinlig körbar fil i stället för en parameter i en Python-fil, eller kräva en kontrollsummejämförelse för Python-filen eller DLL-filen som innehåller NSFW-inställningen. Då skulle inga bilder kunna genereras om användaren ändrade inställningen.
Det skulle göra applikationen begränsad på ungefär samma sätt som DALL-E 2 är i dag, vilket skulle minska dess kommersiella attraktionskraft. Dekompilerade och modifierade versioner av komponenterna skulle sannolikt ändå dyka upp i torrent- och hackningskretsar. Det kan röra sig om ursprungliga Python-körningskomponenter eller kompilerade DLL-filer, såsom i Topaz AI-verktyg för bildförbättring. Restriktionerna kunde låsas upp genom att ersätta hindrande delar och kringgå kontrollsummekraven.
Leverantören kan i slutänden välja att bara upprepa Stability.ai:s varning mot missbruk, som visas vid första starten i många nuvarande distributioner av Stable Diffusion.
De små utvecklare med öppen källkod som nu använder sådana informella friskrivningar har dock mindre att förlora än ett företag som satsat mycket tid och pengar på att göra Stable Diffusion komplett och tillgängligt. Det kräver mer eftertanke.
Ansvar för deepfakes
Som vi nyligen noterade innehåller databasen LAION-aesthetics, en del av de 4,2 miljarder bilder som Stable Diffusions pågående modeller tränats på, mängder av kändisbilder. Det gör det möjligt att skapa deepfakes, inklusive deepfake-pornografi med kändisar.

Från vår senaste artikel: Jennifer Connelly i fyra stadier under fyra årtionden av sin karriär, framtagna med Stable Diffusion.
Detta är en separat och mer omstridd fråga än generering av vanligtvis laglig, abstrakt pornografi som inte föreställer verkliga människor, även om bilderna härleds från flera verkliga fotografier i träningsmaterialet.
Allt fler amerikanska delstater och länder utvecklar eller har infört lagar mot deepfake-pornografi. Därför kan Stable Diffusions förmåga att skapa kändispornografi innebära att en kommersiell applikation som inte är helt censurerad, och alltså kan skapa pornografiskt material, ändå måste kunna filtrera identifierade kändisansikten.
En metod vore en inbyggd spärrlista med ord som inte accepteras i användarens prompt, kopplade till kändisnamn och fiktiva figurer de förknippas med. Inställningarna skulle sannolikt behövas på fler språk än engelska, eftersom ursprungsdata innehåller andra språk. Ett annat alternativ vore kändisigenkänning, såsom de system Clarifai utvecklat.
Programvarutillverkare kan behöva lägga till sådana metoder, kanske avstängda från början, för att hindra en fullständig fristående Stable Diffusion-applikation från att skapa kändisansikten i väntan på lagstiftning som kan göra funktionen olaglig.
Även sådana funktioner skulle dock kunna dekompileras och kringgås. Tillverkaren kunde då hävda att det rör sig om otillåtet sabotage, så länge denna baklängeskonstruktion inte görs alltför lätt.
Funktioner som skulle kunna ingå
Grundfunktionerna i varje distribution av Stable Diffusion borde finnas i alla välfinansierade kommersiella program. Det omfattar textprompter för att skapa passande bilder (text till bild); skisser eller andra bilder som vägledning för nya bilder (bild till bild); inställningar för hur fantasifullt systemet ska vara; en avvägning mellan renderingstid och kvalitet; och andra grundfunktioner som valfri automatisk arkivering av bilder och prompter, valfri rutinmässig uppskalning med RealESRGAN och åtminstone grundläggande ansiktskorrektion med GFPGAN eller CodeFormer.
Detta är en ganska enkel standardinstallation. Låt oss se på mer avancerade funktioner som nu utvecklas eller byggs ut och som skulle kunna ingå i en fullständig, traditionell Stable Diffusion-applikation.
Stokastisk frysning
Även om du återanvänder ett seed från en tidigare lyckad rendering är det mycket svårt att få Stable Diffusion att upprepa en omvandling exakt om någon del av prompten eller ursprungsbilden, eller båda, ändras vid nästa rendering.
Detta är ett problem om du vill använda EbSynth för att överföra Stable Diffusions omvandlingar till verklig video med tidsmässig kontinuitet. Tekniken kan dock vara mycket effektiv för enkla bilder av huvud och axlar:
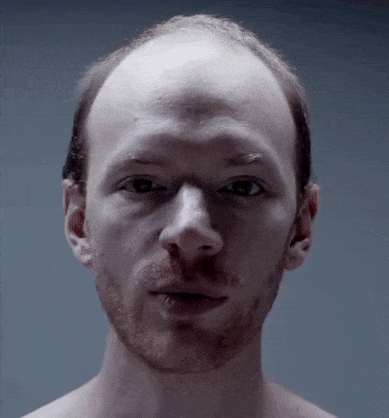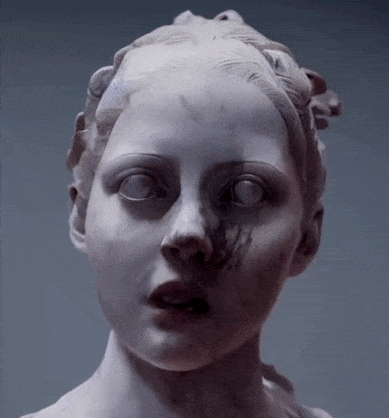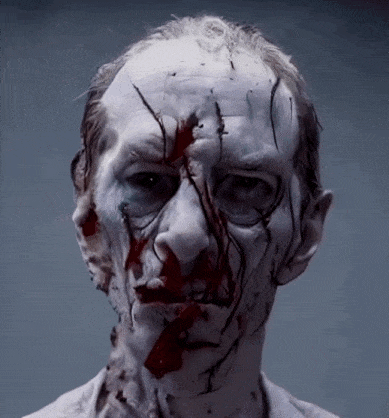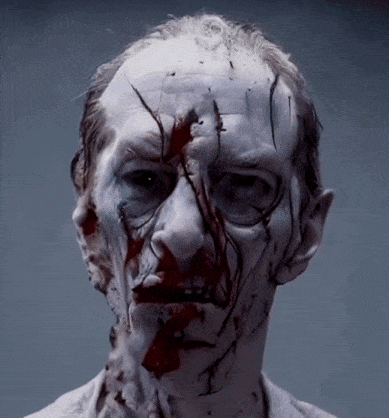
Begränsad rörelse kan göra EbSynth till ett effektivt sätt att omvandla Stable Diffusion-bilder till realistisk video. Källa: https://streamable.com/u0pgzd
EbSynth extrapolerar ett litet urval modifierade nyckelbilder till en video som först har exporterats som en serie bildfiler, vilka senare kan sättas ihop till video igen.

I detta exempel från EbSynths webbplats har en handfull bildrutor målats konstnärligt. EbSynth använder dessa som stilguider och ändrar resten av videon så att den får samma målade stil. Källa: https://www.youtube.com/embed/eghGQtQhY38
I exemplet nedan rör sig den verkliga blonda yogainstruktören till vänster nästan inte alls. Ändå har Stable Diffusion svårt att hålla ansiktet konsekvent, eftersom de tre bilder som omvandlas till nyckelbilder inte är helt identiska trots samma numeriska seed.

Även med samma prompt och seed i alla tre omvandlingar och mycket små ändringar mellan källbilderna varierar musklernas storlek och form. Framför allt är ansiktet inkonsekvent, vilket hindrar tidsmässig kontinuitet i en möjlig EbSynth-rendering.
SD/EbSynth-videon nedan är mycket uppfinningsrik: användarens fingrar blir ett par gående byxklädda ben respektive en anka. De varierande byxorna illustrerar dock Stable Diffusions problem med kontinuitet mellan nyckelbilder, även när källbilderna liknar varandra och samma seed används.
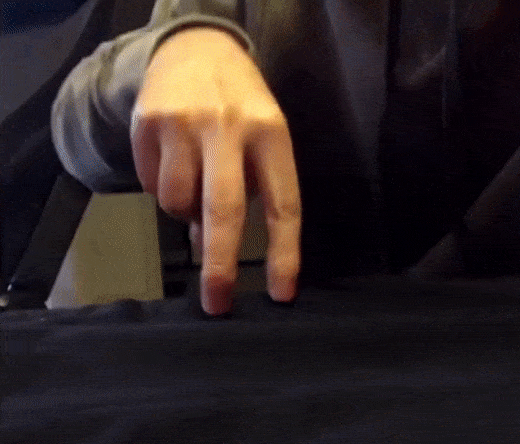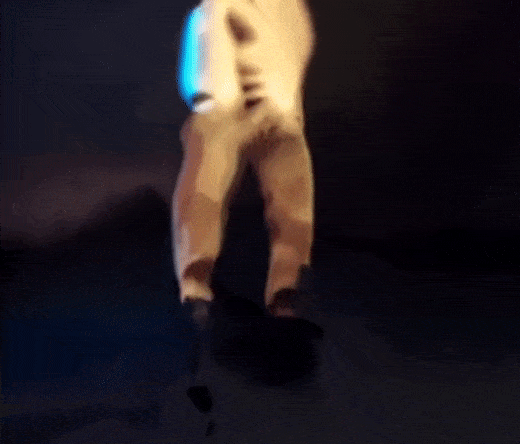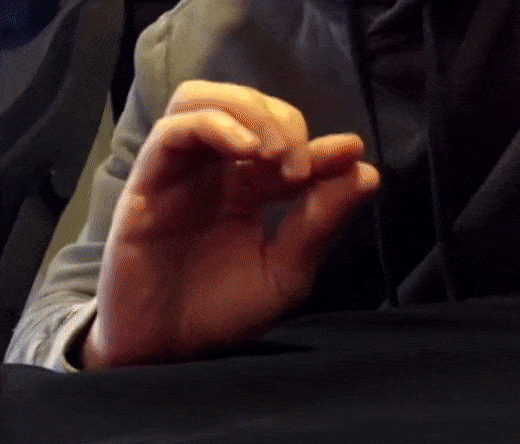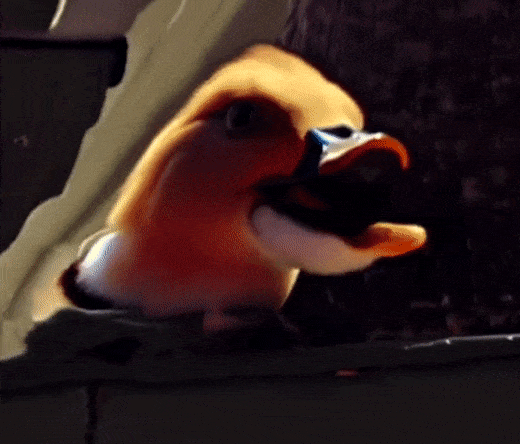
En mans fingrar blir en gående man och en anka med Stable Diffusion och EbSynth. Källa: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
Användaren som skapade videon kommenterade att ankomvandlingen, kanske den mer lyckade men mindre slående och originella, bara krävde en enda omvandlad nyckelbild. De gående byxorna krävde däremot 50 Stable Diffusion-bilder och uppvisar större tidsmässig inkonsekvens. Det krävdes också fem försök för att uppnå kontinuitet för var och en av de 50 nyckelbilderna.
En verkligt heltäckande Stable Diffusion-applikation skulle därför ha stor nytta av en funktion som bevarar egenskaper så väl som möjligt mellan nyckelbilder.
En möjlighet vore att låta användaren frysa den stokastiska kodningen för varje bildrutas omvandling. I dag kräver detta manuell ändring av källkoden. Som exemplet nedan visar förbättrar det kontinuiteten, men löser inte problemet helt:
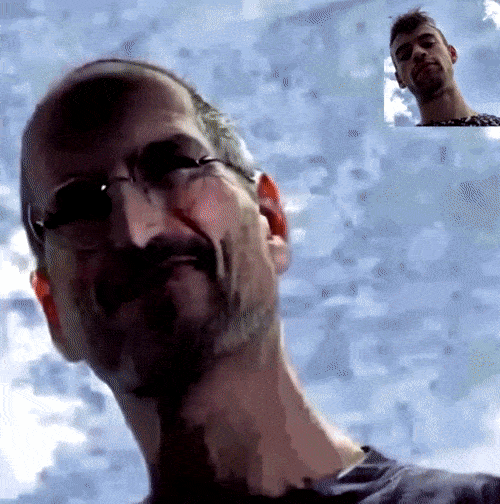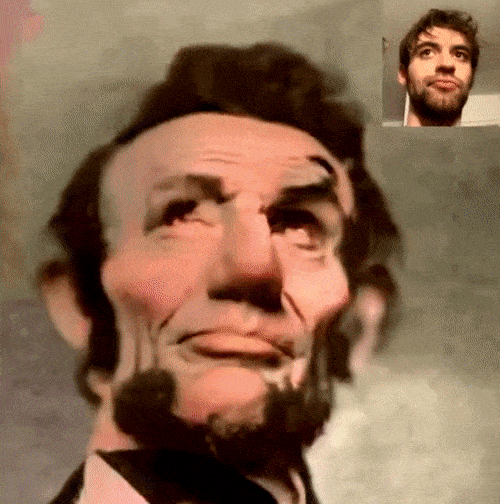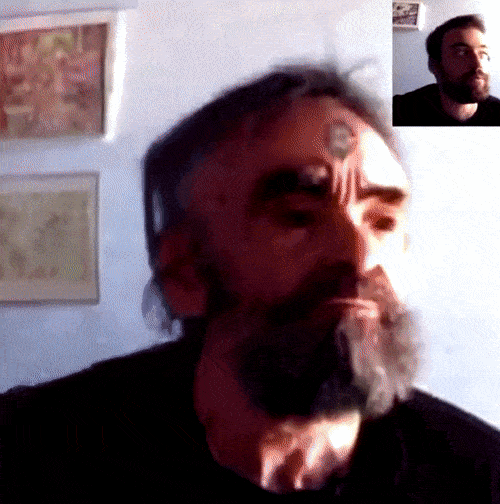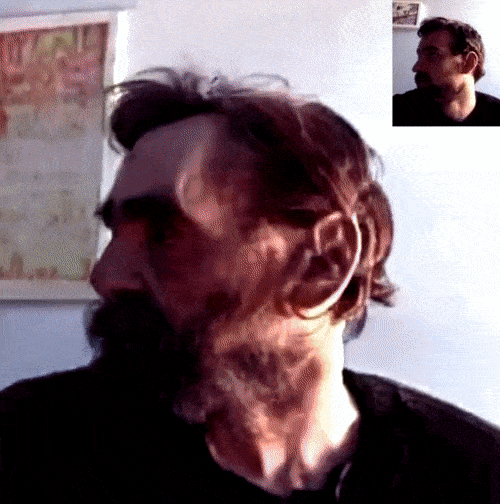
En Reddit-användare gjorde om webbkamerabilder av sig själv till olika kändisar genom att inte bara behålla samma seed, vilket alla Stable Diffusion-implementationer klarar, utan även samma stochastic_encode()-parameter i varje omvandling. Det gjordes genom kodändringar, men skulle lätt kunna bli ett användarreglage. Alla tidsmässiga problem löses dock uppenbarligen inte. Källa: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
Molnbaserad textuell inversion
En bättre lösning för tidsmässigt konsekventa figurer och föremål är att baka in dem i en textuell inversion — en fil på 5 KB som kan tränas på några timmar med bara fem annoterade bilder och sedan anropas med en särskild *-prompt. På så vis kan till exempel nya figurer behålla samma utseende genom en berättelse.

Bilder med lämpliga taggar kan omvandlas till separata enheter genom textuell inversion och framkallas entydigt, i rätt sammanhang och stil, med särskilda tokenord. Källa: https://huggingface.co/docs/diffusers/training/text_inversion
Textuella inversioner är tilläggsfiler till den mycket stora, färdigtränade modell som Stable Diffusion använder. De förs in i bildframkallnings- eller promptprocessen så att de kan medverka i scener som modellen skapar och dra nytta av dess enorma kunskapsbas om objekt, stilar, miljöer och samspel.
Trots att träningen av en textuell inversion inte tar lång tid kräver den mycket grafikminne. Enligt olika aktuella guider behövs någonstans mellan 12, 20 och till och med 40 GB VRAM.
De flesta vanliga användare har troligen inte den GPU-kapaciteten. Därför växer molntjänster fram som kan sköta arbetet, inklusive en version från Hugging Face. Det finns visserligen Google Colab-implementationer som kan skapa textuella inversioner för Stable Diffusion, men kraven på grafikminne och tid kan bli besvärliga för Colab-användare på gratisnivån.
För en framtida välfinansierad, komplett installerad Stable Diffusion-applikation är det en uppenbar intäktsmodell att låta företagets molnservrar sköta denna tunga uppgift. Det förutsätter att ett billigt eller kostnadsfritt program innehåller sådana avgiftsbelagda funktioner, vilket verkar troligt för många applikationer som kan växa fram ur tekniken under de närmaste 6–9 månaderna.
Den ganska komplicerade annoteringen och formateringen av inskickade bilder och texter skulle också kunna automatiseras i en integrerad miljö. Möjligheten att skapa unika inslag som kan utforska och samspela med Stable Diffusions vidsträckta världar kan bli starkt beroendeframkallande, både för entusiaster och yngre användare.
Mångsidig promptviktning
Många nuvarande implementationer låter användaren betona en del av en lång textprompt, men verktygen varierar mycket och är ofta klumpiga eller svårbegripliga.
Den mycket populära Stable Diffusion-förgreningen från AUTOMATIC1111 kan till exempel sänka eller höja ett promptords vikt genom att omge det med en eller flera parenteser för mindre betoning, eller hakparenteser för större betoning.

Hakparenteser och vanliga parenteser kan förändra din frukost i den här versionen av Stable Diffusions promptviktning, men resultatet är en kolesterolmardröm i båda fallen.
Andra versioner av Stable Diffusion använder utropstecken för betoning. De mest mångsidiga låter användaren ange en vikt för varje ord i prompten genom det grafiska gränssnittet.
Systemet borde också tillåta negativa promptvikter — inte bara för skräckfantaster, utan eftersom det kan finnas mindre oroande och mer lärorika mysterier i Stable Diffusions latenta rum än vad vår begränsade språkanvändning kan framkalla.
Bildutvidgning, outpainting
Kort efter det sensationella offentliggörandet av Stable Diffusions källkod försökte OpenAI, till stor del förgäves, återta en del av uppmärksamheten kring DALL-E 2 genom att presentera outpainting. Det låter användaren utvidga en bild utanför dess gränser med semantisk logik och visuell sammanhållning.
Det har naturligtvis sedan dess implementerats i flera former för Stable Diffusion, liksom i Krita, och borde självklart ingå i en heltäckande version av Stable Diffusion i Photoshop-stil.
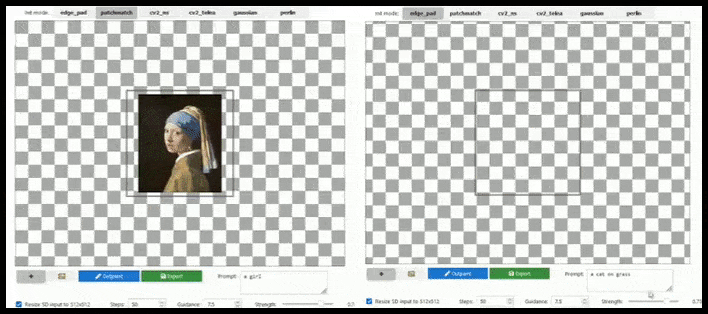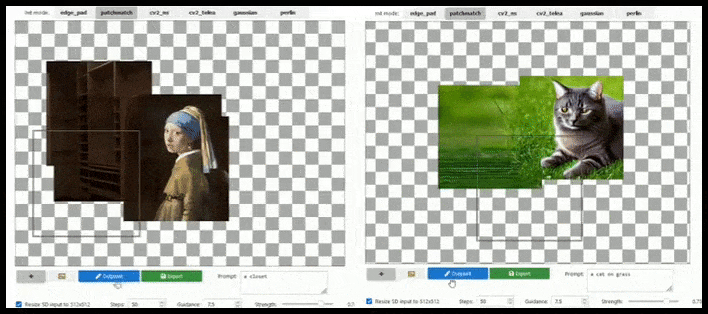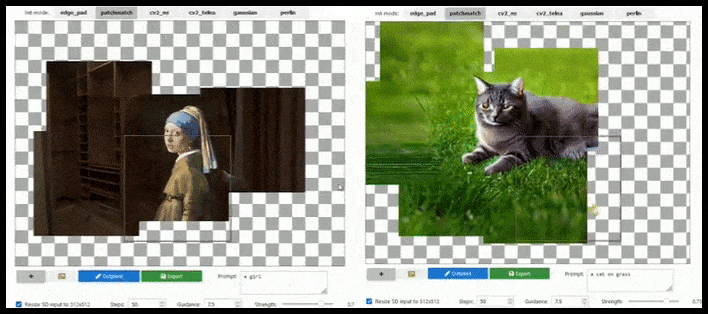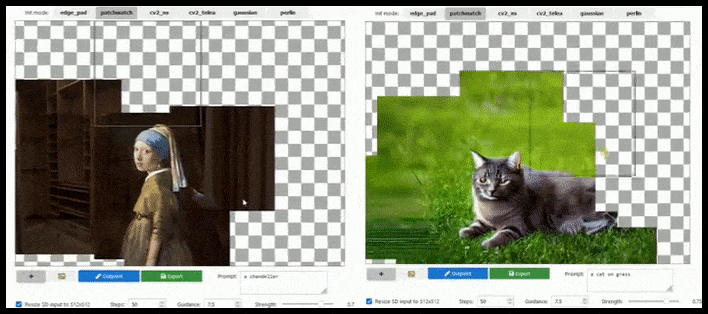
Utvidgning med bildplattor kan förlänga en vanlig rendering på 512 × 512 pixlar nästan obegränsat, så länge prompterna, den befintliga bilden och den semantiska logiken medger det. Källa: https://github.com/lkwq007/stablediffusion-infinity
Eftersom Stable Diffusion tränats på bilder om 512 × 512 pixlar, och av flera andra orsaker, kapar det ofta huvuden eller andra viktiga kroppsdelar på människor, även om prompten uttryckligen anger att huvudet ska betonas.

Typiska exempel på Stable Diffusions halshuggningar, men outpainting skulle kunna få tillbaka George i bilden.
En outpainting-implementation som den i den animerade bilden ovan borde också erbjuda en lösning med ett klick eller en prompt för detta. Den bygger uteslutande på Unix-bibliotek men borde kunna återskapas i Windows.
I dag utvidgar många användare bildytan uppåt på bilder med avhuggna huvuden, fyller grovt i huvudområdet och använder img2img för att slutföra den misslyckade renderingen.
Effektiv maskning som förstår sammanhanget
Maskning kan vara mycket opålitlig i Stable Diffusion, beroende på förgrening eller version. Även när det går att rita en sammanhängande mask fylls området ofta med innehåll som inte tar hänsyn till bildens hela sammanhang.
En gång maskerade jag hornhinnorna i ett ansikte och gav prompten blå ögon för att fylla masken. Resultatet såg ut som om jag tittade genom två utklippta människoögon på en avlägsen bild av en överjordisk varg. Jag får väl vara glad att det inte blev Frank Sinatra.
Semantisk redigering är också möjlig genom att identifiera bruset som ursprungligen skapade bilden. Då kan användaren bearbeta särskilda strukturella element i en rendering utan att påverka resten av bilden:

Ett element i bilden ändras utan traditionell maskning och utan att angränsande innehåll förändras. Det görs genom att identifiera bruset som skapade bilden och bearbeta de delar som bidrog till målområdet. Källa: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
Metoden bygger på K-Diffusion-samplern.
Semantiska filter för anatomiska missar
Som vi tidigare nämnt lägger Stable Diffusion ofta till eller tar bort lemmar, till stor del på grund av dataproblem och brister i annoteringarna till träningsbilderna.

Likt barnet som räckte ut tungan på skolans gruppfoto är Stable Diffusions biologiska missöden inte alltid uppenbara. Du kan redan ha lagt ut ditt senaste AI-mästerverk på Instagram innan du ser de extra händerna eller smälta lemmarna.
Dessa fel är så svåra att rätta att ett komplett Stable Diffusion-program skulle ha nytta av anatomisk igenkänning. Med semantisk segmentering kunde det avgöra om bilden innehåller allvarliga anatomiska brister, som ovan, och kasta den till förmån för en ny rendering innan den visas för användaren.

Om användarna accepterade telemetrin kunde sådana fel även skickas anonymt som en gemensam insats för federerad inlärning, så att framtida modeller kan förbättra sin förståelse av anatomisk logik.
Automatisk ansiktsförbättring baserad på LAION
Som jag noterade i min tidigare genomgång av tre saker som Stable Diffusion kan förbättra framöver bör man inte överlåta åt enbart någon version av GFPGAN att förbättra ansikten i den första renderingen.
GFPGAN:s förbättringar är mycket generiska, undergräver ofta den avbildade personens identitet och arbetar enbart med ett ansikte som vanligtvis redan är dåligt renderat, eftersom det inte fått mer bearbetningstid eller uppmärksamhet än resten av bilden.
Ett professionellt Stable Diffusion-program borde därför känna igen ett ansikte med ett vanligt och relativt lätt bibliotek som YOLO, använda hela den tillgängliga GPU-kraften för att rendera det på nytt och antingen blanda in det förbättrade ansiktet i den ursprungliga bilden eller spara det separat för manuell sammansättning. I dag kräver detta ganska mycket handpåläggning.
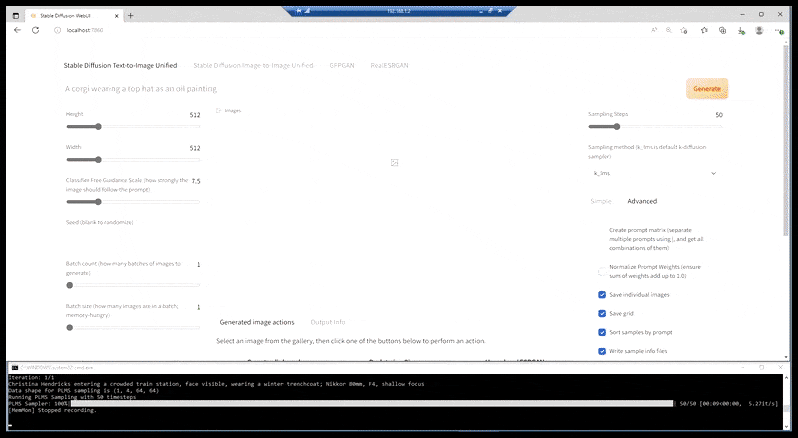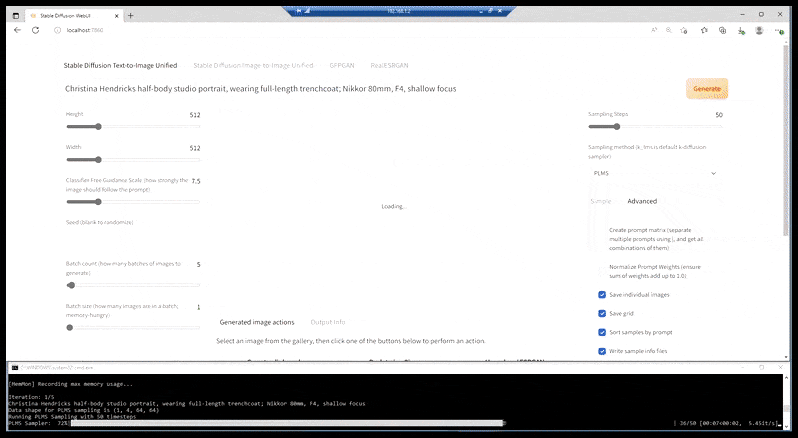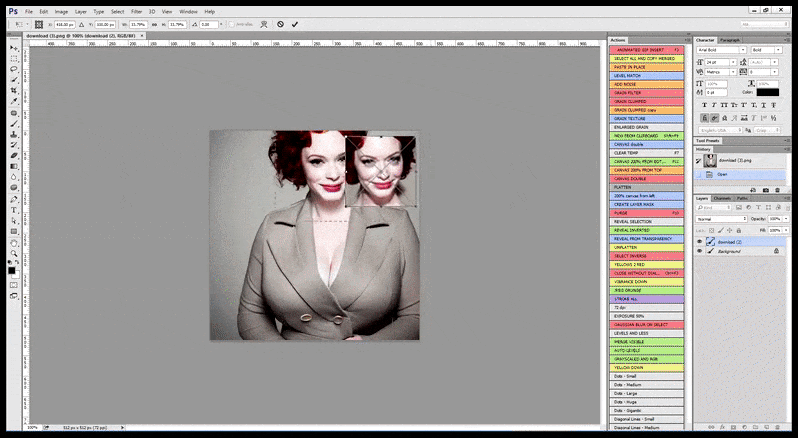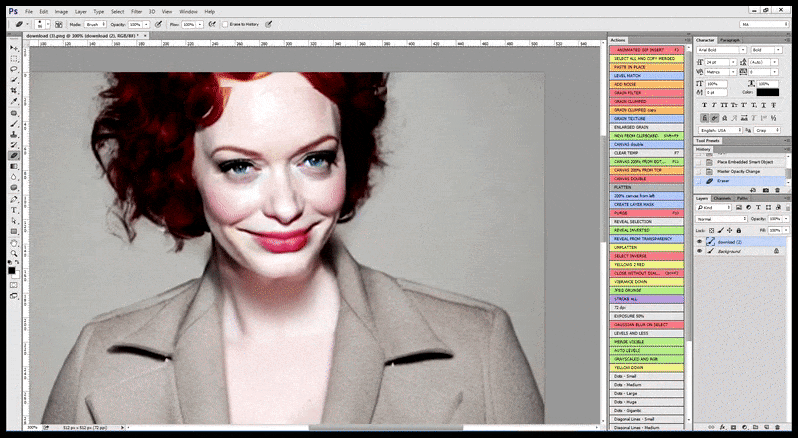
När Stable Diffusion har tränats på tillräckligt många kändisbilder går det att koncentrera hela GPU-kapaciteten på en efterföljande rendering av enbart ansiktet. Det ger vanligtvis en tydlig förbättring och använder, till skillnad från GFPGAN, information från LAION-tränade data i stället för att bara justera de renderade pixlarna.
LAION-sökningar i appen
Sedan användarna upptäckte att sökningar efter begrepp, personer och teman i LAION-databasen kan hjälpa dem att använda Stable Diffusion bättre har flera LAION-söktjänster skapats, däribland haveibeentrained.com.

Sökfunktionen på haveibeentrained.com låter användaren utforska bilderna bakom Stable Diffusion och upptäcka om objekt, personer eller idéer som de vill framkalla sannolikt ingick i träningen. Sådana system hjälper också till att hitta närliggande begrepp, till exempel hur kändisar grupperas eller nästa idé som följer av den nuvarande. Källa: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
Webbdatabaserna visar ofta vissa av bildernas taggar. Men den generalisering som sker under modellträningen innebär att en viss bild sannolikt inte kan framkallas bara genom att använda dess tagg som prompt.
Dessutom innebär borttagningen av stoppord samt stamning och lemmatisering i språkteknik att många av de visade fraserna delades upp eller utelämnades innan träningen i Stable Diffusion.
Hur estetiska grupperingar binds samman i dessa gränssnitt kan ändå lära slutanvändaren mycket om Stable Diffusions logik, eller kanske personlighet, och hjälpa till att skapa bättre bilder.
Slutsats
Det finns många andra funktioner jag skulle vilja se i en komplett skrivbordsversion av Stable Diffusion. Ett exempel är inbyggd CLIP-baserad bildanalys som vänder på standardprocessen och låter användaren få fram fraser och ord som systemet naturligt förknippar med ursprungsbilden eller renderingen.
Äkta uppskalning med bildplattor vore också välkommen, eftersom ESRGAN är nästan lika trubbigt som GFPGAN. Planer på att integrera txt2imghd-implementationen av GOBIG gör lyckligtvis snabbt detta möjligt i distributionerna, och det verkar vara ett självklart val för en skrivbordsversion.
Andra vanliga önskemål från Discord-grupperna intresserar mig mindre, exempelvis inbyggda promptordböcker och listor över konstnärer och stilar. En anteckningsbok i appen eller ett anpassningsbart fraslexikon vore dock ett logiskt tillägg.
Människocentrerad animation i Stable Diffusion är fortfarande i ett mycket tidigt skede, trots den inledande skjutsen från CogVideo och andra projekt. Utvecklingen är beroende av grundforskning om tidsmässiga förkunskaper kopplade till äkta mänsklig rörelse.
För tillfället är Stable Diffusion-video strikt psykedelisk, men den närmaste framtiden kan vara ljusare för deepfake-dockanimation via EbSynth och andra relativt nya text-till-video-initiativ. Det är också värt att notera frånvaron av syntetiska eller förändrade människor i Runways senaste reklamvideo.
En annan värdefull funktion vore smidig överföring till Photoshop och tillbaka, vilket länge funnits i bland annat Cinema4D:s texturredigerare. Då kunde bilder enkelt skickas mellan program, så att varje program används för de ändringar det är bäst på.
Sist och kanske viktigast bör ett komplett Stable Diffusion-program inte bara låta användaren växla enkelt mellan checkpoints, alltså versioner av den underliggande modellen. Det bör också kunna uppdatera specialtränade textuella inversioner som fungerade med tidigare officiella modellversioner men annars kan sluta fungera med senare versioner, vilket utvecklarna på den officiella Discord-servern har sagt kan bli fallet.
Ironiskt nog har Adobe, organisationen med bäst förutsättningar att skapa en så kraftfull och integrerad uppsättning Stable Diffusion-verktyg, knutit sig så starkt till Content Authenticity Initiative att detta kan framstå som ett bakåtsteg för företagets PR. Undantaget vore om Adobe begränsade Stable Diffusions generativa förmåga lika genomgripande som OpenAI gjort med DALL-E 2 och i stället presenterade det som en naturlig utveckling av sin omfattande bildbanksverksamhet.
Först publicerad den 15 september 2022.


