
Intervjuer
Gil Elbaz, medgrundare och CTO på Datagen – Intervjuserie

 Lägg till Unite.AI bland dina föredragna källor på Google
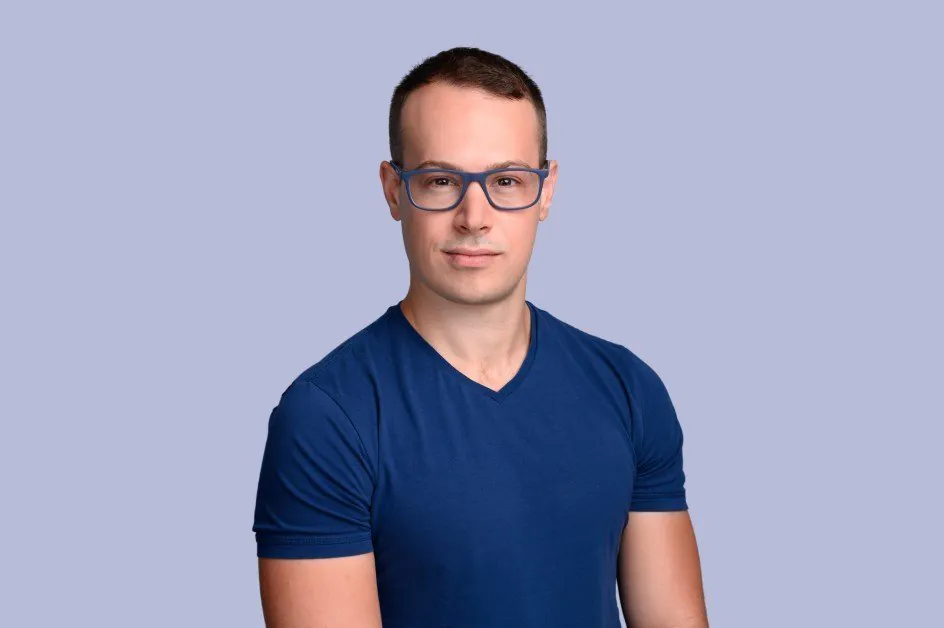
Gil Elbaz är Datagens CTO och medgrundare, med säte i Tel Aviv. Han har en kandidatexamen och en masterexamen från Technion. Gil’s avhandlingsforskning fokuserade på 3D-datorseende och har publicerats på CVPR, världens ledande konferens för datorseende. Datagen är en pionjär inom det nya området Simulerad Data, en undergrupp till syntetisk data, som koncentrerar sig på att återskapa världen runt om oss på ett fotorealistiskt sätt. Företaget lanserades från stealth-läge med över 18 miljoner dollar i finansiering i mars 2021 och arbetar nu med ett antal Fortune 100-företag inom förstärkt och virtuell verklighet, robotik och fordonsindustri, inklusive de flesta av de ledande amerikanska teknikjättarna.
Vad var det som initialt drog dig till robotik och maskinlärning?
Sci-Fi-böcker, som Isaac Asimovs Foundation Series och iRobot, fick mig att tänka på en framtid där robotar var en integrerad del av våra dagliga liv. Det finns så många tråkiga, repetitiva uppgifter som människor utför; jag visste att jag inte ville göra dem, och jag kunde inte föreställa mig att någon annan ville göra det heller. Eftersom robotik är en teknisk oundviklighet, tyckte jag att det var ett smart, “framtidsbevisat” karriärval.
Så, jag närmade mig initialt området med fokus på de fysiska aspekterna av ämnet och tog min examen i maskinteknik från Technion i Haifa, Israel. Mot slutet av min examen började jag dyka djupt in i världen av CAD-verktyg och funktioner. Dessa verktyg möjliggör för maskintekniker att designa strukturer och mekaniska enheter (allt från en bro till en bil). Jag såg en enorm möjlighet att göra en stor inverkan utan att hantera de långsamma iterationerna i den fysiska världen. I praktiken hade dessa program mycket lite, om någon, maskinlärnings- eller datorseendekapacitet integrerad, som hjälpte ingenjörer att skapa enklare, billigare och mer stabila mekaniska system (detta var 2015). Jag satte mig i riktning mot datorseende på 3D-data med djupinlärning (mycket nytt då) med målet att skapa smartare CAD-program. Att arbeta i de tidiga dagarna av modern djupinlärning kändes som att vara en del av något som kunde bli riktigt stort — liknande internet.
I praktiken var min forskning den första som förde den djupa inlärningsrevolutionen till vår fakultet på Technion. Detta resulterade senare i en artikel som accepterades till den främsta datorseende-konferensen i världen, CVPR, och jag flög till Hawaii på CVPR 2017. Att presentera min artikel och möta människorna öppnade mina ögon för omfattningen av datorseendegemenskapen (som idag är minst 10 gånger större), tusentals deltagare som alla passionerat arbetar med forskning inom området. Den händelsen cementerade i princip min riktning, vilket visade mig kraften i datorseende och den potential som väntar på att låsas upp.
Kunde du dela den ursprungliga historien bakom Datagen?
Datagen grundades 2018 med en mission att omvandla hur team får sin data för datorseende-nätverksutbildning. Året innan såg vi en demo av Oculus Rift, som bestod av en VR-huvud enhet och en handhållen fjärrkontroll. Efter demon såg vi oss själva undra, “med avancerade kameror inbyggda i huvud enheten, varför behövdes en handhållen enhet för att ansluta den virtuella rymden till den fysiska rymden (dvs. spåra handrörelse)?” De neurala nätverken var redan tillräckligt avancerade för att hantera det, så vad var problemet?” Och då gick lampan upp — Data! Vi såg omedelbart den enorma möjligheten att lösa 3D- rumsliga närvaroprocesser med hjälp av avancerat datorseende och 3D-metadata. Snarare än att fokusera enbart på VR/AR, tog vi ett mer holistiskt tillvägagångssätt, koncentrerat på det till synes olösliga problemet att generera tillräcklig (och korrekt) utbildningsdata för att möjliggöra verkliga 3D-AI-applikationer.
Med fokus på människor och mänsklig miljöinteraktion är Datagen en pionjär inom det nya området Simulerad Data, en undergrupp till syntetisk data, som koncentrerar sig på att återskapa världen runt om oss på ett fotorealistiskt sätt. Idag arbetar vi med de mest innovativa företagen i världen för att driva och accelerera deras datorseendeutveckling och stöds av några av de mest respekterade investerarna inom området.
För läsare som är ovana vid det, kunde du förklara vad som specifikt är syntetisk data?
Syntetisk data är alla utbildningsdata som — istället för att samlas in via direkt mätning eller observation av den verkliga världen — genereras antingen algoritmiskt eller via simulering. I sammanhanget med datorseende är syntetisk data datorgenererade bilder med associerad metadata som behövs för att träna artificiell intelligens. Med tanke på problemen med integritet och de verkliga fysiska och ekonomiska begränsningarna för data från den verkliga världen, är det svårt att överdriva betydelsen av syntetisk data för maskinlärning och AI. I en nyligen publicerad rapport förutspådde Gartner att, fram till 2024, kommer de flesta av datan som används inom AI-området att vara konstgjord på grund av dessa skäl.
Vilka är några fördelar med syntetisk data jämfört med manuell datainsamling?
Det korta svaret är, tänk på varje aspekt av manuell datainsamling som är önskvärd och ta bort dem från processen — de är fördelarna med syntetisk data.
Att generera diversifierade datamängder i stor skala för datorseendeutbildning är en kostsam och tidskrävande process, och variationen är mycket begränsad av det faktum att att placera människor i specifika platser och fotografera dem är en komplicerad process — mycket mer komplicerad och dyrbar än att göra det i en simulerad miljö. En annan stor fördel är att effektivt eliminera behovet av manuell annotering, som är tråkig, tidskrävande och benägen för mänskliga fel.
Datagen hänvisar till simulerad data som en undergrupp till syntetisk data. Kunde du förklara vad simulerad data är?
Simulerad data är syntetisk data som genereras genom simulering. Vi använder GANs (samt några andra avancerade maskinlärningsmetoder) för att generera 3D-objekt och placera dem i högt realistiska 3D-simulationer av den verkliga världen. Det ser ut som en första persons “virtuell bildtagning”-process, men som fungerar inom ett fotorealistiskt, fysikbaserat system. Dessa simulationer producerar visuell data (som om den samlades in i den verkliga världen), tillsammans med en fullständig uppsättning annoteringar (fysik, belysning etc.). Så, simulerad data är syntetisk data som är fotorealistisk, kontextuellt genererad, 3D-bild, samlad i en simulerad miljö.
Hur genererar Datagen anpassad simulerad data?
Datagens teknik genererar simulerad data som är både skalbar och anpassad för att tillgodose de unika behoven hos varje kunds specifika applikation. Vi gör detta genom att ta hänsyn till varje aspekt av varje projekt — från det datorseendesystem som används till den demografiska sammansättningen av regionen där det kommer att användas. Oavsett om vi arbetar direkt med våra kunder eller bara möjliggör deras egna ingenjörer, börjar Datagens process med att etablera nyckelparametrar för varje specifik användningsfall, såsom objektivspecifikationer, belysning, miljö, demografisk fördelning och så vidare. Datagen använder GANs och andra avancerade verktyg och tekniker för att generera en enorm mängd tillgångar, inklusive allt från mänskliga huvuden med dynamiska ansiktsuttryck för att träna AI i emotionell analys, till fordonsinteriörer för övervakning av passagerare i fordon, och hemmiljöer för videokonferensapplikationer, för att nämna några. För varje tillgångstyp introducerar Datagen variation över otaliga diskreta axlar (från hudton och ögonbryns höjd till storlek, färg och form på hushållsmöbler), med parametrar som är finjusterade för att återspegla den specifika applikationen i fråga.
Tack vare dessa funktioner är Datagens datamängder inte bara stora och varierade, utan också optimerade för att träna ett unikt system för att utföra en unik uppgift (eller en uppsättning uppgifter) i den unika miljön eller inställningen där det kommer att användas — allt utan att kompromissa med förmågan att skala. Vi tar också hänsyn till de specifika annoterings-/metadatakraven för varje applikation.
Vilka är några exempel på lösningar inom robotik där syntetisk och/eller simulerad data används?
En av de största fördelarna med att använda simulerad data i robotik är förmågan att generera bilder av maskinvara som fortfarande är under utveckling. Detta möjliggör att din robots hjärna (AI) och kropp (maskinvara) kan utvecklas sida vid sida. Nu kan utbildningen utvecklas allteftersom specifikationerna utvecklas, snarare än att vänta tills den slutliga produkten är fullständigt prototyperad innan du kan ta bilder av den och börja utveckla AI.
Dessutom, eftersom simulerad data genereras i sammanhang, kan du enklare ta hänsyn till interaktionen mellan din robot och dess miljö. Så, om du föreställer dig en robot som plockar och tar bort defekta produkter från en monteringslinje, skulle simulerad data tillåta dig att inte bara generera data för varje fysisk defekt som är tänkbar i produkten, utan också från robotens perspektiv för att fånga den fulla räckvidden av robotarmens rörelse, dess interaktion med objektet den plockar. Dessutom innebär 3D-metadata att det inte finns något behov av att noggrant annotera bild efter bild för att säkerställa att roboten kan korrekt identifiera produkten, defekterna, sin arm eller något annat i dess synfält.
Vilka är några användningsfall för att använda simulerad data i smarta bilar?
Simulerad data i utvecklingen av smarta bilar gör det oändligt mycket enklare att utveckla datamängder för specifika bilmodeller medan de designas, itererande i samklang med bilen själv allteftersom den utvecklas genom de olika faserna av design och produktion. Med simulerad bilddata kan ingenjörer också använda in-cabin-vision mer effektivt för att identifiera sömniga eller distraherade förare, om en förare har tagit bort sin hand från ratten, eller någon annan typ av kantfall för att säkerställa förarens säkerhet. Det möjliggör också för ingenjörer att ta hänsyn till större variation i förare och passagerare, och introducera variation i form av bildvinkel och belysning — allt utan att kränka den verkliga människans integritet.
Nyligen tillkännagav Datagen ett stort antal spännande nya rekryteringar, vad betyder detta för företagets framtid?
De nyliga tilläggen till vår styrelse och ledning inkluderar några av de mest briljanta och erfarna proffsen inom AI- och datorseendeområdet. Deras kunskap, insikt och erfarenhet kommer att hjälpa till att orientera och accelerera Datagens tillväxt allteftersom vi navigerar i en industri som fortfarande är ung och full av möjligheter. I ett område med så många okända faktorer, är ingenting mer värdefullt än kunskap.
Finns det något annat du vill dela om Datagen?
Baserat i Tel Aviv är Datagen en del av en mycket större ekonomisk och kulturell förändring som har ägt rum i Israel, och vi är stolta över att vara en del av den. På en kort tid har Israel (Tel Aviv i synnerhet) vuxit till en stor global tech-hubb, med en blomstrande startup-ekosystem och en energisk investeringsgemenskap. Även om Israel ofta anses vara ett cybersäkerhetscentrerat tech-hubb, har AI- och datacentrerad teknik växt exponentiellt under de senaste åren här. Idag finns det mer än 680 artificiella intelligensföretag i Israel, som har samlat in 4,5 miljarder dollar. Denna tillväxtexplosion under de senaste åren beror till stor del på den höga koncentrationen av ingenjörer och Israels världsberömda universitet. Dessa akademiska institutioner ger tillgång till talang och den senaste tekniken inom området. Under de senaste två månaderna har Datagen anställt mer än 20 anställda och planerar att ta in ytterligare teammedlemmar över försäljning och marknadsföring, programvara och DevOps, och produktavdelningar. Tack för den underbara intervjun, läsare som vill veta mer bör besöka Datagen.


