
Intervjuer
Zaid Al Hamani, VD och grundare av Boost Security – Intervjuerien

 Lägg till Unite.AI bland dina föredragna källor på Google
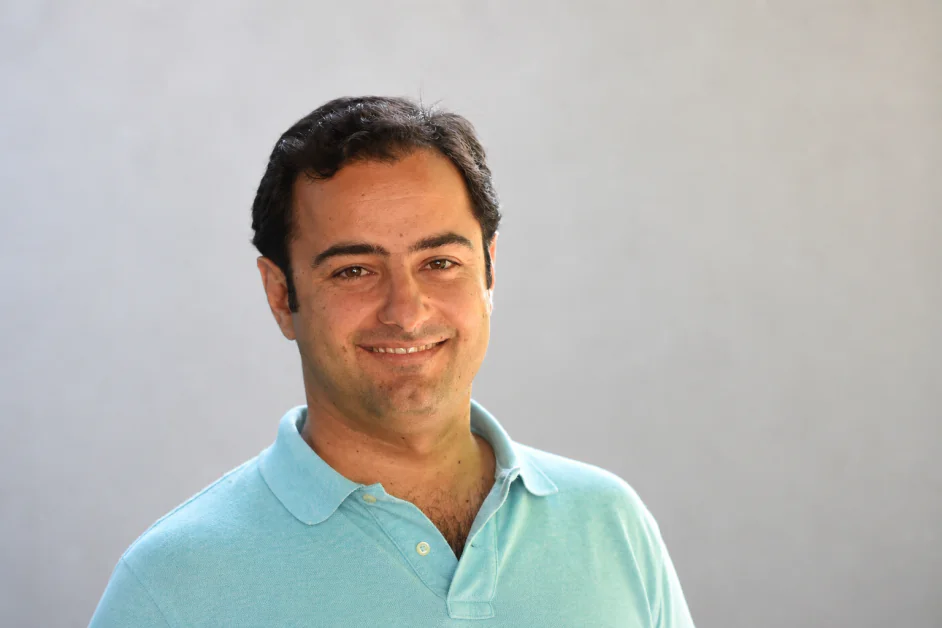
Zaid Al Hamani, VD och grundare av Boost Security, är en ledande expert inom cybersäkerhet och DevSecOps med över två decenniers erfarenhet av att bygga och skala globala tekniska operationer. Sedan han grundade Boost Security 2020 har han fokuserat på att modernisera hur organisationer säkrar programvaruutveckling, med stöd av tidigare roller som VP för Application Security på Trend Micro och medgrundare/VD för IMMUNIO. Tidigare har han haft seniora ledningspositioner på Canonical, där han ledde produkt-, teknik- och globala supportinitiativ, och på SITA, där han hanterade storskaliga, kritiska IT-operationer. Hans karriär visar en stark meritlista av att bygga team, optimera system och främja moderna säkerhetspraxis.
Boost Security är ett cybersäkerhetsföretag som fokuserar på att säkra den moderna programvaruleverantörskedjan genom en utvecklarcentrerad DevSecOps-plattform. Dess teknik integreras direkt i CI/CD-pipelines för att automatiskt upptäcka, prioritera och åtgärda sårbarheter, minska manuell belastning samtidigt som utvecklingshastigheten upprätthålls. Genom att förena programsäkerhet och leverantörskedjesäkerhet i ett system ger plattformen fullständig insyn i kod, beroenden och infrastruktur, vilket hjälper organisationer att stärka motståndskraften i komplexa, molnbaserade miljöer.
Tidigare ledde du programsäkerhet på Trend Micro och var med och grundade IMMUNIO. Vad ledde dig till att grunda Boost Security, och vilket gap i marknaden var du unikt positionerad att identifiera tidigt?
IMMUN.IO var ett av de första RASP-företagen som grundades – och vår erfarenhet fram till den punkten var att WAF som en runtime-säkerhetsteknik var omöjlig att underhålla och inte särskilt effektiv. Vi föreställde oss en lösning där WAF skulle ersättas med en mer exakt och lättare underhållsbar lösning – genom att instrumentera programmet.
Det var 2012, DevOps var fortfarande i sin linda, och de flesta team var inte agila, och Kubernetes var inte en sak ännu.
Trend Micro förvärvade IMMUN.IO 2017. Vid den tidpunkten fanns det många fler DevOps-praxis: CI/CD-pipelines, agila utvecklingspraxis, snabbare iterationer och släppcykler, moln etc. Programvaruteam var bättre på att bygga programvara och skicka ut den snabbare. Säkerheten var fortfarande trasig dock:
- Sökningar är för långsamma eller resultaten anländer för sent
- Resultaten är för komplexa för utvecklare att agera på
- Det fanns en allmänt oacceptabel falsk positiv frekvens
- Många nya typer av artefakter scannades inte: infrastruktur som kod, containrar, API:er till exempel
Att producera programvara snabbt var lättare. Att producera säker programvara snabbt var fortfarande svårt.
Det var det ursprungliga problem vi satte oss att lösa. Få DevSecOps att fungera i den riktiga världen; kan du få ett programvaruteam att enkelt lägga till säkerhet i SDLC, i en hastighet som matchar de nya standarderna för hastighet? Kan du göra täckningen bred – där en plattform är allt du behöver? Kan du göra det så att utvecklare, inte bara antar tekniken, utan omfamnar den och ser fördelarna? Kan du göra det så att det skalar så att du inte behöver arméer av säkerhetsproffs för att hålla jämna steg med mängden kod som skrivs…
Vi hjälpte företag att injicera säkerhet i SDLC under DevOps-eran. Det var att gå från 1 till 10. Vi är nu i eran av agenter som skriver kod – där agenter skriver en enorm mängd kod – men det är i grunden samma problem – hastighet och volym av kod gick från 10 till 100; och vi syftar till att fortsätta samma bana.
Du har hävdat att programvaruutvecklingslivscykeln (SDLC) har förändrats fundamentalt uppströms. Vilket var ögonblicket då du insåg att traditionella DevSecOps-ansatser inte längre var tillräckliga?
Det var att se hur angripare faktiskt fick tillgång. Vi såg hela tiden samma mönster: en utsatt GitHub Actions-arbetsflöde som ingen hade granskat sedan repo var forkad, en token med produktionsmolntillgång inbäddad i en runner-konfiguration, en legitim CI-jobb kapad för att distribuera angriparns last. Dessa blev kända som “leva av pipelinen”-attacker, eftersom motståndaren använder din egen automatisering mot dig, med behörigheter som ditt säkerhetsteam redan godkänt.
DevSecOps-stapeln vi hade byggt upp under ett decennium hade inget svar på det. SAST-scannar programkällkod. SCA-scannar programberoenden. Båda antar att pipelinen som kör dem är pålitlig. Samtidigt är pipelinen i sig en YAML-fil med shell-kommandon, nätverksåtkomst och känsliga behörigheter, och nästan ingen granskar den.
När det blir den lägsta motståndsvägen kan du skicka perfekt ren kod och fortfarande ge angriparna din molntjänst.
Hur bör företag omdefiniera SDLC i en värld där AI-agenter genererar kod kontinuerligt snarare än att utvecklare skriver den steg för steg?
Vi måste alla sluta tänka på SDLC som en sekvens av kontrollpunkter. AI-agenter har kollapsat tiden mellan “någon skrev detta” och “detta är i produktion” från veckor till minuter. Den gamla modellen antog en mänsklig takt mellan kodgranskning, SAST, SCA och distribution, men vi är bortom det nu.
Säkerheten måste bo där agenten opererar: på utvecklarens maskin, inuti promptkontexten, i agentens anslutningar till MCP-servrar och externa modeller. Innan koden når pipelinen har du redan förlorat chansen att forma den. Agenten har redan dragit beroendet. Modellen har redan sett behörigheten. Flytta kontrollerna uppströms, till där arbetet faktiskt sker.
Många organisationer behandlar fortfarande AI-kodningsverktyg som enkla produktivitetslager. Varför tror du att de representerar en helt ny angreppsyta snarare än bara en utvidgning av befintliga arbetsflöden?
Att behandla ett AI-kodningsverktyg som ett produktivitetslager är som att behandla en juniorutvecklare med rotåtkomst som ett produktivitetslager. Etiketten är tekniskt korrekt, men den ger dig ingen användbar ram för att tänka på vad som kan gå fel.
En kodagent läser din filsystem, skrapar miljövariabler för kontext, hämtar beroenden från offentliga register, öppnar utgående anslutningar till externa modellleverantörer och MCP-servrar, och kör shell-kommandon. Var och en av dessa åtgärder krävde tidigare en mänsklig operator. Nu sker de på millisekunder, med samma behörigheter som utvecklaren som startade agenten.
Detta kollapsar förtroendegränser som tidigare var separata: utvecklarens auktoritet, vad ett externt verktyg kan hämta, och vad obehörig kod kan köra. Det skapar nya möjligheter för angripare och blinda fläckar som försvarare inte ens kan se, än mindre försvara.
Boost rammar in utvecklarmaskinen som den nya kontrollplanen. Vilka risker finns det på slutpunkten som säkerhetsteam för närvarande förbiser?
Den största risken är inventering. De flesta säkerhetsteam kan inte säga vilka AI-agenter som körs på vilka bärbara datorer, vilka MCP-servrar dessa agenter är anslutna till, eller vilka IDE-tillägg som skrapar repository-innehåll just nu. EDR har ingen insyn i agentlagret; SIEM kan inte se vad dessa agenter gör lokalt heller. Det är ett problem med skugg-IT med kodkörningsbehörigheter.
Under det ligger behörighetsröran. Vi byggde ett öppen källkodsverktyg som heter Bagel delvis för att göra detta konkret. En typisk utvecklarmaskin innehåller GitHub-token med skrivrättigheter till produktionsrepo, molnbehörigheter som kan skapa infrastruktur, npm- eller PyPI-token som kan publicera till miljontals användare, och AI-tjänstnycklar som angripare säljer. Ingen av dessa är härdad på samma sätt som en CI-körare är härdad. Samma maskin som innehåller dessa behörigheter bläddrar också i webben och installerar slumpmässiga VS Code-tillägg.
Kombinera de två och du har den faktiska angreppsytan. Ett obehörigt tillägg som körs med utvecklarbehörigheter i en miljö full av molnnycklar är det högst belönande målet i det moderna företaget. De flesta team har inte ens börjat titta på det.
Du har betonat “kontextfällan”, där AI-agenter kan komma åt lokala filer, miljövariabler och konfigurationer. Hur utbrett är risken för att känslig data läcker genom prompter, och varför är det så svårt att upptäcka?
Tillräckligt utbrett för att vi betraktar det som standardtillståndet för varje ohanterad utvecklarmiljö. Varje kodagent vi har inspekterat drar lokalt sammanhang aggressivt. De läser dotfiles, miljövariabler, nyligen öppnade filer, ibland hela katalogträd, och skickar det sammanhanget till en fjärrmodell. Verktygen är utformade för att fungera på det sättet; aggressivt sammanhangsdragning är vad som gör dem användbara.
Detektionsproblemet börjar eftersom trafiken från en läcka ser identisk ut med normal produktanvändning. Det är TLS till api.openai.com eller api.anthropic.com. Det kommer från ett godkänt företagsprogram. Standard-DLP ser en utvecklare som använder AI-verktyget som företaget just köpte en licens för. Det ser inte att en av strängarna i den prompten är en AWS-hemlig nyckel som agenten drog från en halvt bortglömd .env-fil i en syskonkatalog.
Du fångar det bara genom att inspektera prompter innan de lämnar bärbar datorn, vilket är exakt där nästan ingen säkerhetsstack för närvarande är positionerad.
Du nämnde maskinhastighetsleverantörskedjattacker. Kan du gå igenom ett realistiskt scenario där en AI-agent introducerar en sårbarhet snabbare än traditionella säkerhetsverktyg kan identifiera den?
Här är ett som vi har sett variationer av upprepade gånger. Utvecklare ber en agent att lägga till en funktion som behöver ett HTTP-återställningsbibliotek. Agenten föreslår ett paketnamn. Paketet låter trovärdigt men existerar inte på npm. Inom en timme registrerar en angripare det, fyller det med fungerande återställningslogik plus ett litet post-installations-skript som läser ~/.aws/credentials och skickar innehållet till en webhook. Agenten kör npm install utan att kontrollera, eftersom agenter inte kontrollerar rykte. Behörigheten är borta innan utvecklaren ens kör koden.
Attacken i sig är inte tekniskt avancerad, men traditionell leverantörskedjesäkerhet byggs kring kända sårbarheter i kända paket: CVE, SBOM, licensscanning. Den ramen har ingenting att säga om ett paket som inte existerade när scannern senast kördes, skapades specifikt för att matcha en AI-hallucination och hämtas innan någon hotfeed uppdateras.
Det fönstret från publicering till kompromiss mäts nu i minuter. Allt som kontrollerar efteråt kontrollerar för sent.
Blir hallucinerade beroenden en av de största riskerna i AI-driven utveckling, och vilka praktiska steg kan organisationer ta för att försvara sig mot dem?
De är redan en av de största. Angripare övervakar aktivt populära AI-verktyg för hallucinationer och registrerar de föreslagna paketnamnen inom minuter. Forskare för ett par år sedan, när det först började hända, kallade det slopsquatting och namnet fastnade. När ett beroendenamn hallucineras tillräckligt ofta, är att sitta på det en passiv leverantörskedjattack med nästan noll ansträngning.
De praktiska försvar ser annorlunda ut än vad de flesta team för närvarande har. Börja med inköp. Blockera förväxlingsbara och nyligen registrerade paket vid den tidpunkt då npm install eller pip install körs, på utvecklarens maskin, innan något hamnar på disk. Postmortem-detektion i CI hjälper inte när ett post-installations-skript redan har exfiltrerat en behörighet. Sedan ger du agenten skyddsräcken att operera inom. Injicera din godkända beroendelista direkt i agentens sammanhang, så att modellen ser vad som är tillåtet innan den genererar ett förslag. Att be utvecklare att skriva “säkra prompter” är inte en strategi. Om du blir strategisk, innebär det att säkerheten sätter gränsen, agenten ärver den. Och börja spåra en AI-materielista. De flesta team kan inte säga vilka agenter, modeller och paket som berör vilka repository.
Du har sagt att säkerhet inte längre kan börja vid CI/CD. Vad ser en modern säkerhetspipeline ut som när skydd behöver börja tidigare i utvecklingsprocessen?
Om säkerheten börjar vid CI/CD, har du gett upp hela för-kommit-fasen till en miljö som du inte kontrollerar. Agenten har redan dragit sammanhang, din behörighet kan redan vara i någon annans loggar. Du scannar en kadaver.
En modern pipeline börjar på bärbar datorn. Det innebär att inventera agenter och tillägg som körs där, validera vilka MCP-servrar och modeller de är tillåtna att prata med, sanera vad som lämnar maskinen och blockera skadliga paket innan de installeras. Därifrån följer principen arbetet in i IDE. Vi injicerar säkerhetsstandarder direkt i agentens sammanhangsfönster så att genererad kod stannar inom skyddsräcken från den första token. Pipelinen körs fortfarande, gör slutlig verifiering av kontroller som redan har påtvingats uppströms.
Pipelinen försvinner inte. Dess roll blir verifiering: att bekräfta att de uppströms kontrollerna hölls.
När organisationer fortsätter att anta AI-kodningsagenter, vad är de mest kritiska förändringarna de måste göra idag för att säkerställa att deras utvecklingsmiljöer förblir säkra under de närmaste åren?
Det största misstaget är att säkra bara det som checkas in. Den intressanta risken bor nu i de åtta timmarna före en check-in sker. Osynlig drama kan utspela sig på bärbar datorn, i prompten eller i paketinstallationen. Om dina verktyg börjar vid PR, skyddar du fel halva arbetsflödet.
Nära relaterat: sluta behandla kodningsagenter som produktivitetsprogram. De är icke-mänskliga användare med shell-åtkomst, repository-skrivbehörigheter och utgående nätverksanslutningar. Styra dem på samma sätt som du styr varje annan privilegerad identitet, med en inventering, godkända funktioner och granskningsloggar.
Den sista förändringen är svårare kulturellt. De flesta nuvarande “AI-säkerhetsverktyg” presenterar resultat och routerar dem till människor. Människor kan inte triage i den hastighet som agenter genererar. Vad du än antar måste det lösa problem automatiskt inom arbetsflödet, med spårbar logik, eller så blir det en till instrumentpanel som ingen läser.
Tack för den underbara intervjun, läsare som vill lära sig mer bör besöka Boost Security.


