
Intervjuer
Dr Mathilde Pavis, chef för juridik, OpenOrigins – Intervjuer

 Lägg till Unite.AI bland dina föredragna källor på Google
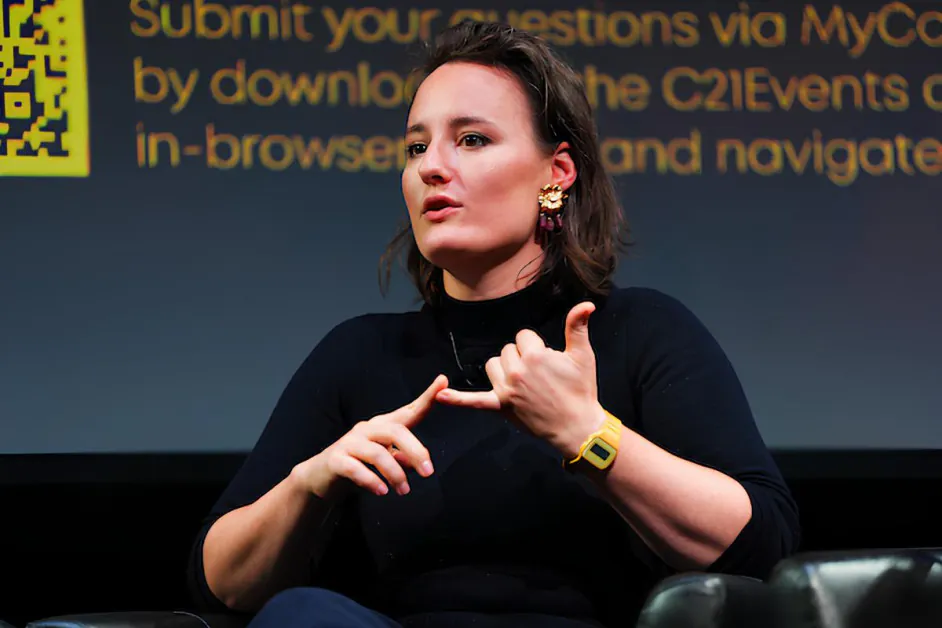
Dr Mathilde Pavis, chef för juridik på OpenOrigins, är en ledande expert inom AI-reglering och digitala medier, specialiserad på deepfakes, syntetiska medier och innehållsproveniens. Hon rådgiver företag, regeringar och fackföreningar om regelefterlevnad, licensiering och risker i generativ AI, och har arbetat med Microsoft (MSFT ) och ElevenLabs på AI-politik och strategi. Hon har också rådgivit UNESCO om AI och immateriella rättigheter, och bidrar regelbundet med expertråd till brittiska beslutsfattare.
OpenOrigins utvecklar teknologi för att bekämpa desinformation och deepfakes genom att skapa verifierbara, oföränderliga register över digitalt innehåll. Plattformen fokuserar på att etablera tydlig proveniens, vilket möjliggör för medier, skapare och plattformar att bevisa när och hur innehåll skapades, redigerades och distribuerades – en alltmer kritisk funktion när syntetiska medier blir mer avancerade och svåra att upptäcka.
Du har arbetat nära med regeringar, globala institutioner som UNESCO och företag som Microsoft och ElevenLabs på AI-reglering. Vad ledde dig att fokusera specifikt på deepfakes, digitala repliker och syntetiska medier, och hur formade den resan ditt beslut att grunda Replique?
Mitt arbete med deepfakes började inte med teknologin – det började med ett mycket äldre juridiskt problem. När jag började forska om immateriella rättigheter för min doktorsexamen 2013, slog jag mig av hur mycket mindre skydd som artister får jämfört med författare, kompositörer eller filmproducenter. I praktiken innebär det att dina ord eller din musik skyddas bättre i lag än din röst, ditt ansikte och din kropp. Den obalansen kändes konstig, och den fick mig att ställa en djupare fråga: hur värderar vi kulturellt och juridiskt arbetet med någon som bidrar med sitt ansikte, röst och kropp på skärmen?
Den frågan ledde mig in på artisters rättigheter och data. Vid den tiden ansågs det vara ett nischområde med liten kommersiell relevans. Jag fick rådet att gå in i mer “lönsamma” områden som patenter eller traditionellt upphovsrätt. Antagandet var att frågor om en persons likhet eller röst i huvudsak hanterades informellt – genom branschnormer eller “gentlemens agreements” i Hollywood. Men för mig signalerade den bristen på formellt skydd en lucka, inte en återvändsgränd för min forskning, så jag fortsatte med den.
Vad som har förändrats är att i dag är nästan alla artister. Våra liv medieras genom kameror – på telefoner, laptops, videokonferenser och sociala plattformar. Oavsett om det är för arbete eller personligt bruk, spelar människor ständigt in och delar versioner av sig själva. De juridiska frågorna som tidigare tillämpades främst på skådespelare eller musiker tillämpas nu på alla som har en smartphone.
Deepfakes skapade inte dessa problem – de avslöjade och accelererade dem. Forskningen jag gjorde från 2013 och framåt blev plötsligt brådskande. Runt 2017 och 2018 började utvecklingen inom neuronnät – särskilt från platser som MIT och UC Berkeley – demonstrera hur övertygande en persons ansikte, röst och kropp kunde manipuleras digitalt. Inom ett år blev den förmågan allmänt känd som “deepfakes”, och den fick först fäste på ett sätt som var särskilt skadligt, särskilt genom icke-samtyckande sexuellt innehåll som riktade sig mot kvinnor och barn.
Först senare uppstod de kommersiella implikationerna, när de kreativa industrierna började anta syntetiska medier. Då kom de kontraktuella och ekonomiska frågorna jag hade arbetat med till förgrunden. Nästan över en natt förvandlades vad som tidigare hade setts som ett i huvudsak teoretiskt eller doktrinärt rättsområde till ett högst praktiskt, kommersiellt signifikant och socialt brådskande område.
I sin kärna har den juridiska utmaningen inte förändrats: människor vill dela aspekter av sig själva, men behålla meningsfull kontroll. Existerande ramar kämpar med den nyansen. De tenderar att behandla individer som antingen helt privata eller fullständigt offentliga – antingen skyddade eller rättmätiga. Men de flesta människor existerar någonstans däremellan. Den spänningen är nu central inte bara för professionella artister, utan för alla som deltar i digitalt liv.
Jag blev känd som någon som forskade och arbetade i det här området, vilket ledde mig att arbeta med regeringar som var intresserade av att skydda människor mot deepfakes, och företag som ville göra digitala kloningsprodukter säkra att använda, som ElevenLabs. På Replique tar jag allt jag har lärt mig till människor och företag som vill använda digital kloning eller digital replikteknologi på ett ansvarsfullt och säkert sätt. Jag har i princip förvandlat min “blue sky”-forskning till en rådgivningsverksamhet som tillhandahåller specialistjuridisk rådgivning till de kreativa industrierna.
Som chef för juridik på OpenOrigins, ett företag som fokuserar på att etablera en oföränderlig register över innehållsproveniens för att bekämpa deepfakes, hur ser du proveniensbaserade system som konkurrerar med eller ersätter traditionella deepfake-detektionsmetoder?
Att jämföra deepfake-detektionsverktyg kan snabbt bli en äpplen-och-päron-övning, eftersom deras effektivitet beror på sammanhang och syfte. Från ett politiskt perspektiv behöver vi en uppsättning kompletterande verktyg – det finns inget enda “bästa” lösning, och Open Origins är en del av det bredare ekosystemet. Där OpenOrigins teknologi utmärker sig som en deepfake-detektionslösning är i situationer där en innehållsskapare eller informationsorganisation behöver bevisa autenticiteten hos det innehåll de delar med partners, publik eller allmänheten.
Genom att tillhandahålla verifierbar proveniens och “kvitton” vid skapandet erbjuder det en stark form av förebyggande genom att demonstrera att innehållet inte är en deepfake. Men denna approach är mindre användbar för vanliga internetanvändare som vill snabbt bedöma innehåll de möter online. I sådana fall beror upptäckt mer på sannolikhetsbaserade och innehållsanalytiska metoder snarare än proveniensbaserad verifiering. Vi behöver olika verktyg för olika behov, och vi måste acceptera att det inte finns någon silverkula mot deepfakes.
Från ett juridiskt perspektiv, vad är för närvarande den största luckan i hur jurisdiktioner hanterar samtycke och äganderätt i AI-genererat eller AI-replikerat innehåll?
Oj, hur lång tid har du? Svaret beror på vad vi menar med AI-genererat eller replikerat innehåll. Problemen varierar beroende på om du tittar på en AI-genererad bild av ett hus eller en katt. Eller en digital återgestaltning av en persons ansikte eller röst. Låt oss hålla oss till ämnet deepfakes och digitala repliker, och svara på din fråga i sammanhanget “digital kloning”.
När det gäller samtycke är det centrala problemet att de flesta kontrakt – antingen anställningsavtal eller plattformsavtal – innehåller breda, vaga klausuler som ger omfattande rättigheter över användarinnehåll. Dessa kan tolkas som en form av “bakdörrssamtycke” där att godkänna villkoren kan anses innebära att man samtycker till användningar som kloning, även om de flesta människor starkt skulle ifrågasätta den tolkningen. Det skapar en betydande lucka mellan juridisk tolkning och användarförväntan, en som för närvarande gynnar företag medan regleringen halkar efter.
När det gäller äganderätt finns det inget tydligt juridiskt svar på vem som äger en digital klon, eftersom existerande ramar som dataskydd, upphovsrätt och personlighetsrättigheter inte var utformade för denna teknologi. I dag skannas och klonas de flesta människor på jobbet, på begäran av och med finansiering från en arbetsgivare eller kund. Och dessa enheter förväntar sig vanligtvis en hög grad av kontroll över denna tillgång, vilket är förståeligt men ofta problematiskt eftersom tillgången är en digital imitation av ditt ansikte eller din röst, och kan få dig att säga saker du aldrig har sagt, eller göra saker du aldrig har gjort.
Frågan om “vem äger din klon?” är mycket viktig, men obesvarad i lag för närvarande.
Du har arbetat nära med röstklonningsteknologier. Vilka är de mest missförstådda juridiska riskerna när det gäller syntetiska röster, både för företag och individer?
Det mest missförstådda problemet i juridisk regelefterlevnad är balansen mellan ett företags kommersiella intresse av att finansiera och exploatera en digital klon, och den enskildes rätt till integritet och digital värdighet. Denna spänning finns över flera juridiska regimer (primärt immateriella rättigheter, dataskydd och integritet) som aldrig var utformade för att fungera tillsammans och tolkar kloning på grundläggande olika sätt. Som ett resultat är det komplext och ofta oklart att översätta detta till fungerande, företagsvänliga metoder. Företag förbiser därför ofta viktiga risker eller ådrar sig betydande kostnader för att navigera dem ordentligt. Det skapar ett perverst resultat där ansvarsfull regelefterlevnad blir den svårare, dyrare vägen, snarare än standarden.
Hur bör företag tänka kring samtyckesarkitektur i AI-system, särskilt när det gäller likhet, identitet och träningsdata?
Företag bör utforma sina system kring tre centrala förmågor. Först behöver de säkra informerat, kontextuellt samtycke vid ombordstigning. Andra måste de göra det lätt för användare att återkalla det samtycket och ta bort några eller alla av sina data, något som är tekniskt utmanande och ofta förbisett, men väsentligt för regelefterlevnad med lagar som den brittiska och EU:s GDPR och liknande regimer i USA. Att upprätthålla samtycke över tid innebär att bygga system där återkallande är operativt smidigt och anpassat till affärsmodellen.
Samtycke måste vara granulärt. Och tredje, användare bör kunna hantera behörigheter på enskilda filnivå, uppdatera sin likhetsdata och förstå hur den används. Det kräver transparens och kontroll – verktyg som tillåter användare att övervaka, granska och moderera hur deras digitala kloner distribueras. Den här nivån av flexibilitet är fortfarande ovanlig, men det är där den ökande konkurrensfördelen ligger.
I din erfarenhet av att rådgiva både startups och regeringar, var är den största diskrepansen mellan hur AI byggs och hur det regleras?
Diskrepansen mellan hur AI byggs och hur det regleras beror på fundamentalt olika uppdrag. Regeringar reglerar i allmänhetens intresse, medan AI-företag (ofta venturebackade) i huvudsak drivs av tillväxt, intäkter och vinst. Dessa prioriteringar står inte alltid i konflikt, men de drar ofta i olika riktningar, med reglering som ses som en begränsning snarare än ett stöd.
Det skapar en strukturell spänning: reglerare och innovatörer opererar med olika incitament, värderingar och till och med språk. Det gör samstämmighet svår i praktiken, även om det inte är omöjligt. Vi börjar se en ny våg av techföretag som allierar sig mer nära med allmänna intressen, men de förblir undantagen snarare än regeln – särskilt bland dem som lyckas skala.
OpenOrigins fokuserar på att verifiera innehåll vid skapandet med hjälp av kryptografisk proveniens. Hur kritiskt är detta ursprungsförsta tillvägagångssätt jämfört med efterföljande säkerhetsåtgärder?
Detta loopar tillbaka till mitt svar ovan. Att autentisera innehåll vid skapandet, “upstream”, är mycket mer effektivt än att försöka verifiera det vid distributions- eller konsumtionspunkten, dvs. “downstream”. Att autentisera innehåll vid skapandet är som att spåra mat från den tidpunkt den odlas på gården, snarare än att försöka ta reda på det från det färdiga disken. Om du vet var kycklingen odlades, hur den hanterades och hur den rörde sig genom leveranskedjan, kan du lita på vad du äter. Om du istället försöker gissa allt detta bara genom att titta på den färdiga rätten, litar du på gissningar. Det är samma sak med att skilja på mänskligt skapat och AI-genererat innehåll online: proveniens vid källan ger dig verifierbar säkerhet, medan nedströmsdetektion är inneboende mer osäker och reaktiv.
Vilken roll ser du att standarder som C2PA spelar i medias framtid, och är de tillräckliga på egen hand för att återställa förtroende online?
C2PA är en välkommen initiativ, och på många sätt stödjer den samma rörelse för innehållsautenticitet som OpenOrigins. De är en viktig del av innehållssäkerhets- och innehållsautenticitetsekosystemet. Som med alla cybersäkerhetsverktyg finns det ingen silverkula.
För skapare och talanger inom branscher som film, musik och spel, vilka praktiska steg bör de ta i dag för att skydda sig från obehörig digital replikering?
Artister i dag står inför två distinkta risker: replikeringen av deras arbete (såsom musik, bilder eller skrivande) och replikeringen av deras likhet, inklusive deras ansikte, röst och kropp. Med minimal inmatning kan AI-system nu reproducera båda med hög trovärdighet. I praktiken börjar skyddet med att vara medveten om vad man delar online, och inse att allt innehåll som publiceras kan skannas och användas i träningsdata, ofta utan tydligt samtycke eller synlighet.
Den risken är nu en baslinje för att verka online. Men den mer omedelbara och kontrollerbara risken ligger ofta i kontrakt. Avtal som artister ingår med sina samarbetspartner, distributörer eller plattformar kan innehålla klausuler som tillåter AI-användning, återanvändning eller återförsäljning av innehåll för träningsändamål – ofta utan meningsfullt deltagande i nedströmsintäkter.
För artister gör det kontraktgranskning kritisk. Att förstå hur ditt arbete och din likhet kan användas, licensieras eller återanvändas är nu lika viktigt som den kreativa processen i sig. Mycket av den nuvarande debatten (inom fackföreningar, branschorganisationer och plattformar) handlar om att korrigera den obalansen och säkerställa att skapare behåller både kontroll och rättvis ersättning.
Så två viktiga råd: var försiktig med vad du delar online, och läs dina kontrakt och leta efter AI-klausuler innan du skriver under.
Om tre till fem år, tror du att vi kommer att nå en punkt där varje stycke digitalt innehåll måste ha verifierbar proveniens, eller kommer förtroendet att förbli fragmenterat över plattformar och jurisdiktioner?
Jag skulle vilja säga ja, men realistiskt, nej – inte inom fem år. I tech känns fem år långt; i termer av att förändra användarbeteende och vanor är det mycket kort. De flesta konsumenter är osannolika att basera sina beslut på om innehållet kommer med autentiserad proveniens. Plattformar tenderar att följa användarbegär, optimerar för engagemang snarare än proveniens.
Det kan förändras om reglering ingriper. Vi ser redan tidiga drag i platser som Kalifornien, där märknings- och modereringskrav börjar dyka upp, men att skala det globalt kommer att ta tid – troligen närmare ett decennium än fem år.
Ett annat område för förändring är sektorspecifikt: industrier som journalistik, finans, försäkring och hälsovård kan börja kräva proveniens och autentisering eftersom förtroende är grundläggande för deras verksamhet.
Slutligen, kanske bryr sig konsumenter inte om proveniensinformation på kort sikt, men de kommer sannolikt att bry sig om innehållskvalitet och informationskvalitet. Om AI-genererat innehåll blir för homogent eller “tråkigt”, kan publiken börja värdera mänskligt skapat innehåll mer explicit. Det kunde driva en segmentering av marknaden, där vissa plattformar prioriterar skala och AI-genererat innehåll, och andra kuraterar för autenticitet, proveniens och högt förtroende, mänskligt lett material – men den förändringen förblir okänd.
Tack för dina utmärkta svar, läsare som vill lära sig mer bör besöka OpenOrigins.


