
AI-modeller och plattformar
Komplett guide till Gemma 2: Googles nya öppna stora språkmodell

 Lägg till Unite.AI bland dina föredragna källor på Google
Gemma 2 bygger vidare på sin föregångare och erbjuder förbättrad prestanda och effektivitet, tillsammans med en uppsättning innovativa funktioner som gör den särskilt attraktiv för både forskning och praktiska tillämpningar. Det som särskiljer Gemma 2 är dess förmåga att leverera prestanda som är jämförbar med mycket större proprietära modeller, men i ett paket som är utformat för bredare tillgänglighet och användning på mer modest hårdvara.
När jag gick in på de tekniska specifikationerna och arkitekturen för Gemma 2, blev jag alltmer imponerad av designens ingenuity. Modellen inkorporerar flera avancerade tekniker, inklusive nya uppmärksamhetsmekanismer och innovativa tillvägagångssätt för träningstabilitet, som bidrar till dess remarkabla förmågor.

Google [securities_stock_price_tag symbol="GOOGL" exchange="NASDAQ"] Open Source LLM Gemma
I denna omfattande guide, kommer vi att utforska Gemma 2 i detalj, undersöka dess arkitektur, nyckelfunktioner och praktiska tillämpningar. Oavsett om du är en erfaren AI-utövare eller en entusiastisk nybörjare inom området, syftar den här artikeln till att ge värdefulla insikter i hur Gemma 2 fungerar och hur du kan utnyttja dess kraft i dina egna projekt.
Vad är Gemma 2?
Gemma 2 är Googles senaste öppna stora språkmodell, utformad för att vara lätt och kraftfull. Den bygger på samma forskning och teknik som användes för att skapa Googles Gemini-modeller, och erbjuder toppmoderna prestanda i ett mer tillgängligt paket. Gemma 2 finns i två storlekar:
Gemma 2 9B: En modell med 9 miljarder parametrar
Gemma 2 27B: En större modell med 27 miljarder parametrar
Varje storlek finns i två varianter:
Basmodeller: Förtränade på en stor mängd textdata
Instruction-tunerade (IT) modeller: Finjusterade för bättre prestanda på specifika uppgifter
Åtkomst modellerna i Google AI Studio: Google AI Studio – Gemma 2
Läs rapporten här: Gemma 2 Teknisk Rapport
Nyckelfunktioner och förbättringar
Gemma 2 introducerar flera betydande framsteg jämfört med sin föregångare:
1. Ökad träningsdata
Modellerna har tränats på avsevärt mer data:
Gemma 2 27B: Tränad på 13 biljoner token
Gemma 2 9B: Tränad på 8 biljoner token
Denna utvidgade datamängd, som främst består av webbdata (främst engelska), kod och matematik, bidrar till modellernas förbättrade prestanda och anpassningsförmåga.
2. Sliding Window Attention
Gemma 2 implementerar en ny approach till uppmärksamhetsmekanismer:
Varannan lager använder en sliding window attention med en lokal kontext på 4096 token
Alternativa lager använder fullständig kvadratisk global attention över hela 8192 token kontexten
Denna hybridapproach syftar till att balansera effektivitet med förmågan att fånga långväga beroenden i indata.
3. Soft-Capping
För att förbättra träningsstabilitet och prestanda, introducerar Gemma 2 en soft-capping-mekanism:
<p>def soft_cap(x, cap):
return cap * torch.tanh(x / cap)</p>

<p># Tillämpad på attention logits
attention_logits = soft_cap(attention_logits, cap=50.0)</p>

# Tillämpad på slutliga lager-logit

<p>final_logits = soft_cap(final_logits, cap=30.0)
Denna teknik förhindrar att logits växer för stort utan att trunkera dem hårt, och bibehåller mer information samtidigt som den stabiliserar träningsprocessen.
- Gemma 2 9B: En modell med 9 miljarder parametrar
- Gemma 2 27B: En större modell med 27 miljarder parametrar
Varje storlek finns i två varianter:
- Basmodeller: Förtränade på en stor mängd textdata
- Instruction-tunerade (IT) modeller: Finjusterade för bättre prestanda på specifika uppgifter
4. Kunskapsdestillering
För 9B-modellen använder Gemma 2 kunskapsdestilleringstekniker:
- Förträning: 9B-modellen lär sig från en större lärarmodell under initial träningsfas
- Efter träningsfas: Både 9B- och 27B-modellerna använder on-policy destillering för att förbättra sin prestanda
Denna process hjälper den mindre modellen att fånga de större modellernas förmågor mer effektivt.
5. Modellkombination
Gemma 2 använder en ny modellkombinationsteknik som kallas Warp, som kombinerar flera modeller i tre steg:
- Exponential Moving Average (EMA) under förstärkt inlärning
- Spherical Linear intERPolation (SLERP) efter att flera policys har finjusterats
- Linear Interpolation Towards Initialization (LITI) som en sista steg
Denna approach syftar till att skapa en mer robust och kapabel slutmodell.
Prestandabenchmarks
Gemma 2 visar imponerande prestanda på olika benchmarks:
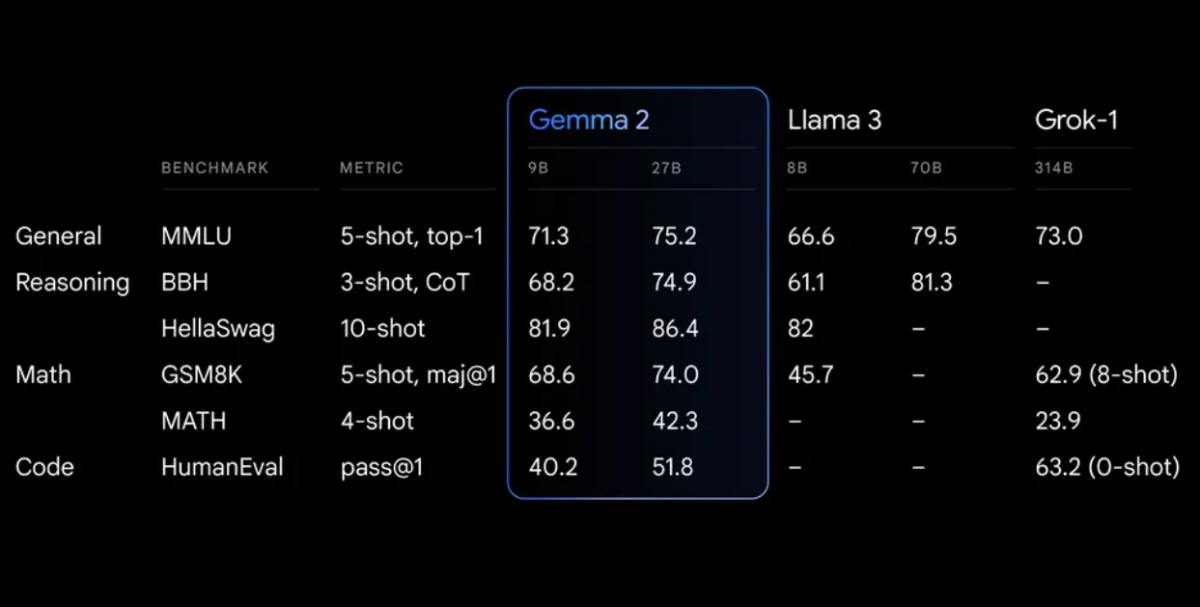
Gemma 2 på en omkonstruerad arkitektur, utvecklad för både exceptionell prestanda och inferens-effektivitet
Komma igång med Gemma 2
För att börja använda Gemma 2 i dina projekt, har du flera alternativ:
1. Google AI Studio
För snabb experimentering utan hårdvarukrav, kan du komma åt Gemma 2 via Google AI Studio.
2. Hugging Transformers
Gemma 2 är integrerad med den populära Hugging Face Transformers-biblioteket. Här är hur du kan använda det:
<div class="relative flex flex-col rounded-lg"> <div class="text-text-300 absolute pl-3 pt-2.5 text-xs"> <p>from transformers import AutoTokenizer, AutoModelForCausalLM</p> <p># Ladda modell och tokenisator model_name = "google/gemma-2-27b-it" # eller "google/gemma-2-9b-it" för den mindre versionen tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name)</p> <p># Förbered indata prompt = "Förklara begreppet kvantmekanisk sammanflätning på ett enkelt sätt." inputs = tokenizer(prompt, return_tensors="pt")</p> <p># Generera text outputs = model.generate(**inputs, max_length=200) response = tokenizer.decode(outputs[0], skip_special_tokens=True)</p> print(response)
3. TensorFlow/Keras
För TensorFlow-användare är Gemma 2 tillgänglig via Keras:
<p>import tensorflow as tf from keras_nlp.models import GemmaCausalLM</p> <p># Ladda modell model = GemmaCausalLM.from_preset("gemma_2b_en")</p> <p># Generera text prompt = "Förklara begreppet kvantmekanisk sammanflätning på ett enkelt sätt." output = model.generate(prompt, max_length=200)</p> print(output)
Avancerad användning: Bygga ett lokalt RAG-system med Gemma 2
En kraftfull tillämpning av Gemma 2 är att bygga ett Retrieval Augmented Generation (RAG)-system. Låt oss skapa ett enkelt, fullständigt lokalt RAG-system med Gemma 2 och Nomic-embeddings.
Steg 1: Konfigurera miljön
Först, se till att du har de nödvändiga biblioteken installerade:
<p>pip install langchain ollama nomic chromadb</p>
Steg 2: Indexera dokument
Skapa en indexerare för att bearbeta dina dokument:
<p>import os from langchain.text_splitter import RecursiveCharacterTextSplitter from langchain.document_loaders import DirectoryLoader from langchain.vectorstores import Chroma from langchain.embeddings import HuggingFaceEmbeddings</p> <p>class Indexer: def __init__(self, directory_path): self.directory_path = directory_path self.text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200) self.embeddings = HuggingFaceEmbeddings(model_name="nomic-ai/nomic-embed-text-v1")</p> <p>def load_and_split_documents(self): loader = DirectoryLoader(self.directory_path, glob="**/*.txt") documents = loader.load() return self.text_splitter.split_documents(documents)</p> <p>def create_vector_store(self, documents): return Chroma.from_documents(documents, self.embeddings, persist_directory="./chroma_db")</p> <p>def index(self): documents = self.load_and_split_documents() vector_store = self.create_vector_store(documents) vector_store.persist() return vector_store</p> <p># Användning indexer = Indexer("sökväg/till/dina/dokument") vector_store = indexer.index()</p>
Steg 3: Konfigurera RAG-systemet
Nu, låt oss skapa RAG-systemet med Gemma 2:
<p>from langchain.llms import Ollama
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate</p>
<p>class RAGSystem:
def __init__(self, vector_store):
self.vector_store = vector_store
self.llm = Ollama(model="gemma2:9b")
self.retriever = self.vector_store.as_retriever(search_kwargs={"k": 3})</p>
<p>self.template = """Använd följande kontext för att besvara frågan i slutet.
Om du inte vet svaret, säg bara att du inte vet, försök inte hitta på ett svar.</p>
{context}
<p>Fråga: {question}
Svar: """</p>
<p>self.qa_prompt = PromptTemplate(
template=self.template, input_variables=["context", "question"]
)</p>
<p>self.qa_chain = RetrievalQA.from_chain_type(
llm=self.llm,
chain_type="stuff",
retriever=self.retriever,
return_source_documents=True,
chain_type_kwargs={"prompt": self.qa_prompt}
)</p>
<p>def query(self, question):
return self.qa_chain({"query": question})</p>
<p># Användning
rag_system = RAGSystem(vector_store)
response = rag_system.query("Vad är huvudstaden i Frankrike?")
print(response["result"])</p>
Detta RAG-system använder Gemma 2 via Ollama för språkmodellen och Nomic-embeddings för dokumentåtervinning. Det tillåter dig att ställa frågor baserat på de indexerade dokumenten och ger svar med kontext från relevanta källor.
Fine-tuning Gemma 2
För specifika uppgifter eller domäner, kan du fine-tune Gemma 2. Här är ett grundläggande exempel med Hugging Face Transformers-biblioteket:
from transformers import AutoTokenizer, AutoModelForCausalLM, TrainingArguments, Trainer from datasets import load_dataset <p># Ladda modell och tokenisator model_name = "google/gemma-2-9b-it" tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name)</p> <p># Förbered dataset dataset = load_dataset("ditt_dataset")</p> <p>def tokenize_function(examples): return tokenizer(examples["text"], padding="max_length", truncation=True)</p> <p>tokenized_datasets = dataset.map(tokenize_function, batched=True)</p> <p># Ställ in träningsargument training_args = TrainingArguments( output_dir="./results", num_train_epochs=3, per_device_train_batch_size=4, per_device_eval_batch_size=4, warmup_steps=500, weight_decay=0.01, logging_dir="./logs", )</p> <p># Initiera Trainer trainer = Trainer( model=model, args=training_args, train_dataset=tokenized_datasets["train"], eval_dataset=tokenized_datasets["test"], )</p> # Starta fine-tuning trainer.train() <p># Spara den fine-tunerade modellen model.save_pretrained("./fine_tuned_gemma2") tokenizer.save_pretrained("./fine_tuned_gemma2")</p>
Kom ihåg att justera träningsparametrarna baserat på dina specifika krav och beräkningsresurser.
Etiska överväganden och begränsningar
Medan Gemma 2 erbjuder imponerande förmågor, är det viktigt att vara medveten om dess begränsningar och etiska överväganden:
- Fördomar: Liksom alla språkmodeller, kan Gemma 2 återspegla fördomar som finns i dess träningsdata. Utvärdera alltid dess utdata kritiskt.
- Faktamässig korrekthet: Medan Gemma 2 är mycket kapabel, kan den ibland generera felaktig eller inkonsekvent information. Verifiera viktiga fakta från tillförlitliga källor.
- Kontextlängd: Gemma 2 har en kontextlängd på 8192 token. För längre dokument eller samtal, kan du behöva implementera strategier för att hantera kontexten effektivt.
- Beräkningsresurser: Särskilt för 27B-modellen, kan betydande beräkningsresurser krävas för effektiv inferens och fine-tuning.
- Ansvarsfull användning: Följ Googles ansvarsfulla AI-principer och se till att din användning av Gemma 2 överensstämmer med etiska AI-principer.
Slutsats
Gemma 2 avancerade funktioner som sliding window attention, soft-capping och nya modellkombinationstekniker gör den till ett kraftfullt verktyg för en mängd olika språkbehandlinguppgifter.
Genom att utnyttja Gemma 2 i dina projekt, antingen genom enkel inferens, komplexa RAG-system eller fine-tunerade modeller för specifika domäner, kan du dra nytta av kraften i SOTA AI samtidigt som du behåller kontrollen över dina data och processer.


