
Andersons vinkel
Att Bringa Visuella Analogier Till AI

 Lägg till Unite.AI bland dina föredragna källor på Google
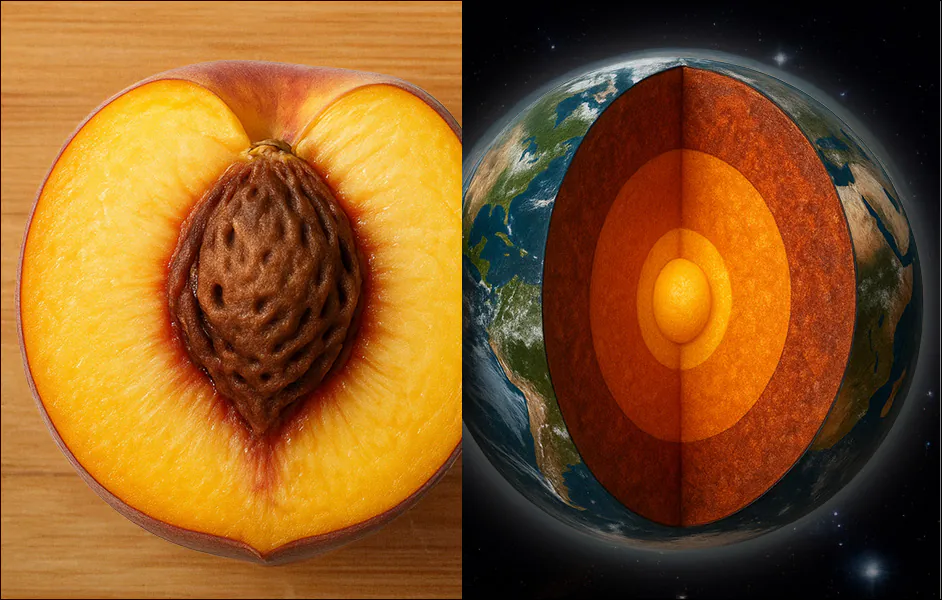
Nuvarande AI-modeller misslyckas med att känna igen ‘relationella’ bildlikheter, såsom hur jordens lager liknar en persika, och saknar därmed en viktig aspekt av hur människor uppfattar bilder.
Det finns många datorseende-modeller som kan jämföra bilder och hitta likheter mellan dem, men den nuvarande generationen av jämförelsesystem har liten eller ingen fantasifull kapacitet. Tänk på några av texterna i den klassiska 1960-talslåten, Windmills of Your Mind:
Like a carousel that’s turning, running rings around the moon
Like a clock whose hands are sweeping past the minutes of its face
And the world is like an apple whirling silently in space
Jämförelser av detta slag representerar ett område av poetisk allusion som är meningsfull för människor på ett sätt som går långt utöver konstnärlig uttryck; snarare är det förknippat med hur vi utvecklar våra perceptuella system; när vi skapar vår ‘objekt’-domän, utvecklar vi en förmåga till visuell likhet, så att – till exempel – tvärsnitt som visar en persika och jorden, eller fraktala rekursioner som kaffespiraler och galaxgrenar, registreras som analogiska hos oss.
På detta sätt kan vi dra slutsatser om samband mellan tydligen orelaterade objekt och objektyper, och inferera system (såsom tyngdkraft, rörelsemängd och ytkohesion) som kan tillämpas på en mängd olika domäner i olika skalor.
Att Se Saker
Även den senaste generationen av bildjämförelse-AI-system, såsom Learned Perceptual Image Patch Similarity (LPIPS) och DINO, som informeras av mänsklig återkoppling, utför endast bokstavliga ytanlikheter.
Deras förmåga att hitta ansikten där inga finns – d.v.s., pareidoli – representerar inte den typ av visuella likhetsmekanismer som människor utvecklar, utan snarare sker detta på grund av att ansiktsletande algoritmer använder lågnivåansiktsstrukturfunktioner som ibland överensstämmer med slumpmässiga objekt:

Exempel på falska positiva för ansiktsigenkänning i ‘Faces with Things’-dataseten. Källa
För att avgöra om maskiner verkligen kan utveckla vår fantasifulla förmåga att känna igen visuell likhet över domäner, har forskare i USA genomfört en studie kring Relationell Visuell Likhet, och skapat och tränat en ny dataset som är utformad för att tvinga abstrakta relationer att bildas mellan olika objekt som ändå är bundna av en abstrakt relation:

De flesta AI-modeller känner endast igen likhet när bilder delar ytegenskaper som form eller färg, vilket är varför de endast länkar till grupp B (ovan) till referensen. Människor, å andra sidan, ser också grupp A som liknande – inte för att bilderna ser lika ut, utan för att de följer samma underliggande logik, såsom att visa en transformation över tid. Det nya arbetet försöker återskapa denna typ av strukturell eller relationell likhet, i syfte att bringa maskinperception närmare mänskligt resonemang. Källa: https://arxiv.org/pdf/2512.07833
Kapitelningssystemet som utvecklats för dataseten möjliggör ovanligt abstrakta annoteringar, utformade för att tvinga AI-system att fokusera på basegenskaper snarare än specifika lokala detaljer:

De förutsagda ‘anonyma’ kapitelrubrikerna som bidrar till författarnas ‘relsim’-mått.
Den curerade samlingen och den ovanliga kapitelstilen ger upphov till författarnas nya föreslagna mått relsim, som författarna har finjusterat i en vision-språkmodell (VLM).

En jämförelse mellan kapitelstilen i vanliga dataset, som fokuserar på attributlikhet, och relsim-tillvägagångssättet (nedre raden), som betonar relationell likhet.
Nya tillvägagångssättet bygger på metoder från kognitiv vetenskap, särskilt Dedre Gentners Struktur-Mapping-teori (en studie av analogi) och Amos Tverskys definition av relationell likhet och attributlikhet.

Från det associerade projektwebbplatsen, ett exempel på relationell likhet. Källa
Författarna hävdar:
‘[Människor] bearbetar attributlikhet perceptuellt, men relationell likhet kräver konceptuell abstraktion, ofta stödd av språk eller tidigare kunskap. Detta tyder på att att känna igen relationell likhet först kräver att man förstår bilden, använder kunskap och abstraherar dess underliggande struktur.’
Den nya artikeln heter Relationell Visuell Likhet, och kommer med en projektwebbplats (se video som är inbäddad i slutet av den här artikeln).
Metod
Forskarna använde en av de mest kända hyperskale-dataseten som utgångspunkt för sin egen samling – LAION-2B:

Metadata för en post i LAION-2B-samlingen. Källa
114 000 bilder som sannolikt innehåller elastiska relationella strukturer extraherades från LAION-2B, vilket innebar filtrering av de många lågkvalitativa bilderna som finns i den minimalt kuraterade dataseten.
För att skapa en pipeline för detta urvalsprocess, använde författarna Qwen2.5-VL-7B, och utnyttjade 1 300 positiva och 11 000 negativa mänskligt märkta exempel:

RelSim-systemet tränas i tre steg: filtrering av bilder från LAION-2B för relationellt innehåll; tilldelning av varje grupp en gemensam anonym kapitelrubrik som fångar deras underliggande logik; och inlärning av att matcha bilder till dessa kapitelrubriker med en kontrastiv förlust.
Artikeln hävdar:
‘Annotatorerna instruerades: “Kan du se någon relationell mönster, logik eller struktur i den här bilden som kunde vara användbar för att skapa eller länka till en annan bild?”. Den finjusterade modellen uppnår 93% överensstämmelse med mänskliga bedömningar, och när den tillämpas på LAION-2B, ger den N = 114k bilder som identifierats som relationellt intressanta.’
För att generera relationella etiketter, uppmanade forskarna Qwen-modellen att beskriva den gemensamma logiken bakom grupper av bilder utan att namnge specifika objekt. Denna abstraktion var svår att uppnå när modellen såg endast en bild, men blev möjlig när flera exempel demonstrerade det underliggande mönstret.
De resulterande gruppnivå-kapitelrubrikerna ersatte specifika termer med platshållare som ‘{Ämne}’ eller ‘{Typ av rörelse}’, vilket gjorde dem allmänt tillämpliga.
Efter mänsklig verifikation, parades varje kapitelrubrik med alla bilder i dess grupp. Mer än 500 sådana grupper användes för att träna modellen, som sedan tillämpades på de 114 000 filtrerade bilderna för att producera en stor uppsättning abstrakta, relationellt annoterade prover.
Data och Tester
Efter extrahering av relationella funktioner med Qwen2.5-VL-7B, finjusterades en modell på data med LoRA, i 15 000 steg, via åtta A100 GPU:er*. För textsidan, inbäddades relationella kapitelrubriker med all-MiniLM-L6-v2 från Sentence-Transformers-biblioteket.
Datasetet med 114 000 kapitelrubriker delades upp i 100 000 för träning och 14 000 för utvärdering. För att testa systemet, användes en återställningsuppsättning: givet en frågebild, måste modellen hitta en annan bild från en pool på 28 000 objekt som uttryckte samma relationella idé. Återställningspoolen innehöll 14 000 utvärderingsbilder och 14 000 ytterligare prover från LAION-2B, med 1 000 frågor slumpmässigt valda från utvärderingssättet för benchmarking.
För att utvärdera återställningskvalitet, användes GPT-4o för att poängsätta den relationella likheten mellan varje fråga och återställd bild på en skala från 0 till 10. En separat mänsklig studie genomfördes också för att mäta användarpreferens (se nedan).
Varje deltagare visades en anonymiserad frågebild med två kandidater, en återställd av det föreslagna tillvägagångssättet och den andra av en baslinje. Deltagarna ombads att avgöra vilken bild som var mer relationellt lik den ursprungliga bilden, eller om båda var lika nära. För varje baslinje skapades 300 tripletter och bedömdes av minst tre personer vardera, vilket resulterade i cirka 900 svar.
RelSim-tillvägagångssättet jämfördes med flera etablerade bild-till-bild-likhetmetoder, inklusive den ovannämnda LPIPS och DINO, samt dreamsim och CLIP-I. Utöver baslinjer som direkt beräknar likhetspoäng mellan bildpar, såsom LPIPS, DINO, dreamsim och CLIP-I, testade författarna också kapitelbaserade metoder där Qwen användes för att generera en anonym eller abstrakt kapitelrubrik för varje bild.; detta tjänade sedan som återställningsfrågan.
Två återställningsvarianter utvärderades, med CLIP-baserad text-till-bild-återställning (CLIP-T) för text-till-bild-återställning, och Qwen-T med text-till-text-återställning. Båda kapitelbaserade baslinjerna använde den ursprungliga förtränade Qwen-modellen snarare än den version som finjusterats på relationell logik. Detta möjliggjorde för författarna att isolera effekten av grupp-baserad träning, eftersom den finjusterade modellen hade exponerats för bildsätt, snarare än isolerade exempel.
Existerande Mått och Relationell Likhet
Författarna testade initialt om existerande mått kunde fånga relationell likhet:

Jämförelse av återställningsprestanda som bedömts av GPT-4o, visande den genomsnittliga relationella likhetspoängen för varje metod. Konventionella likhetsmått som LPIPS, DINO och CLIP-I fick lägre poäng. Kapitelbaserade baslinjer Qwen-T och CLIP-T presterade också sämre. Den högsta poängen uppnåddes av RelSim (6,77, högersta blå kolonnen), vilket indikerar att finjustering på grupp-baserade relationella mönster förbättrade överensstämmelsen med GPT-4o:s bedömningar.
Med avseende på dessa resultat hävdar författarna**:
‘[LPIPS], som fokuserar rent på perceptuell likhet, uppnår den lägsta poängen (4,56). [DINO] presterar bara marginellt bättre (5,14), troligen på grund av att den tränas enbart på ett självständigt sätt på bilddata. [CLIP-I] ger de starkaste resultaten bland baslinjerna (5,91), antagligen för att viss abstraktion ibland är närvarande i bildkapitelrubriker.
‘Men CLIP-I presterar fortfarande sämre än vår metod, eftersom att uppnå en bättre poäng kan kräva förmågan att nå ännu högre abstraktionsnivåer, såsom de i anonyma kapitelrubriker.’
I den mänskliga studien föredrog människor konsekvent RelSim-metoden över alla baslinjer:

Relationella likhetspoäng tilldelade av GPT-4o för varje metod. Standardlikhetsmått som LPIPS, DINO och CLIP-I fick lägre poäng, och kapitelbaserade varianter Qwen-T och CLIP-T presterade bara marginellt bättre. Även justerade versioner av DINO och CLIP kunde inte stänga gapet. Den högsta poängen, 6,77, uppnåddes av RelSim-modellen, tränad med grupp-baserad övervakning.
Författarna noterar:
‘Detta är mycket uppmuntrande, eftersom det visar inte bara att vår modell, RelSim, kan framgångsrikt återställa relationellt lika bilder, utan också, återigen, bekräftar att människor verkligen uppfattar relationell likhet – inte bara attributlikhet!’
För att undersöka hur relationell och attributlikhet kan komplettera varandra, använde forskarna en kombinerad visualiseringsmetod. En enskild frågebild (‘En hund som håller en kamera’) jämfördes med 3 000 slumpmässiga bilder, och likhet beräknades med hjälp av både relationella och attribut-baserade modeller:

Gemensam visualisering av visuell likhetsutrymme med hjälp av relationella och attribut-axlar. En enskild frågebild, som visar en hund som använder en kamera, jämfördes med 3 000 andra. Resultaten organiserades efter relationell likhet (vertikal) och attributlikhet (horisontal). Det övre högra området innehåller bilder som liknar frågan i både logik och utseende, såsom andra hundar som använder verktyg. Det övre vänstra området innehåller semantiskt relaterade men visuellt olika fall, såsom olika djur som utför kamerarelaterade handlingar. De flesta återstående exemplen klusterar lägre i utrymmet, vilket reflekterar svagare likhet. Layouten visar hur relationella och attribut-modeller belyser kompletterande aspekter av visuell data. Vänligen se källartikeln för bättre upplösning.
Resultaten visade kluster som motsvarade olika typer av likhet: vissa bilder var både relationellt och visuellt lika, såsom andra hundar i mänskliga poser; andra delade relationell logik men inte utseende, såsom olika djur som imiterar mänskliga handlingar; resten visade varken.
Denna analys tyder på att de två likhetstyperna fyller olika roller och ger en rikare struktur när de kombineras.
Användningsfall
Artikeln undersöker också några möjliga slutanvändningsfall för relationell likhet, inklusive relationell bildåterställning, som möjliggör bildsökning som är mer anpassad till människors eget kreativa sätt att se på världen:

Relationell återställning returnerar bilder som delar en djupare konceptuell struktur med frågan, snarare än att matcha yttegenskaper. Till exempel returnerar en matvara som är utformad för att likna ett ansikte andra antropomorfa måltider; en skuren föremål returnerar andra skurna former; och scener med vuxen-avkomma-interaktion returnerar bilder med liknande relationella roller, även om arter och sammansättning skiljer sig.
En annan möjlighet är analogisk bildgenerering, som skulle möjliggöra syntes av frågor som använder relationella strukturer snarare än direkta beskrivningar. I en jämförelse av resultat från den nuvarande generationen av state-of-the-art text-till-bild-modeller, kan vi se att resultaten av ett sådant tillvägagångssätt sannolikt kommer att vara mer varierade:

Givet en ingångsbild och en relationell prompt, ombads modellerna att generera en ny bild som uttrycker samma underliggande koncept. Proprietära modeller producerade mer trogna analogier, som bevarade strukturell logik över stora förändringar i form, medan open-sourced-modeller tenderade att återgå till bokstavliga eller stilistiska matchningar, utan att överföra den djupare idén. Utdata jämfördes med mänskligt kuraterade analogier, som exemplifierade den avsedda transformationen.
Slutsats
Generativa AI-system skulle, verkar det, bli betydligt förbättrade av en förmåga att inkorporera abstrakt representation i sina konceptualiseringar. Som det är nu, tenderar att begära koncept-baserade bilder som “vrede” eller “lycka” att returnera bilder som är utformade från de mest populära eller talrika bilderna som hade dessa associationer i datasetet; vilket är minneslagring snarare än abstraktion.
Detta princip kan förmodligen vara ännu mer fördelaktigt om det kunde tillämpas på generativt skrivande – särskilt analytiskt, spekulativt eller fiktivt utdata.
Tryck för att spela. Källa
* En A100 kan ha 40Gb eller 80GB av VRAM; detta specificeras inte i artikeln.
** Författarnas citeringar är redundant och exkluderad.
Publicerad första gången tisdagen den 16 december 2025


