
Det bästa
10 bästa AI-webbskrapningsverktyg (september 2026)

 Lägg till Unite.AI bland dina föredragna källor på Google
Unite.AI kan få ersättning när du använder länkar till produkter vi granskar. Det påverkar inte våra redaktionella bedömningar. Läs vår affiliateinformation.
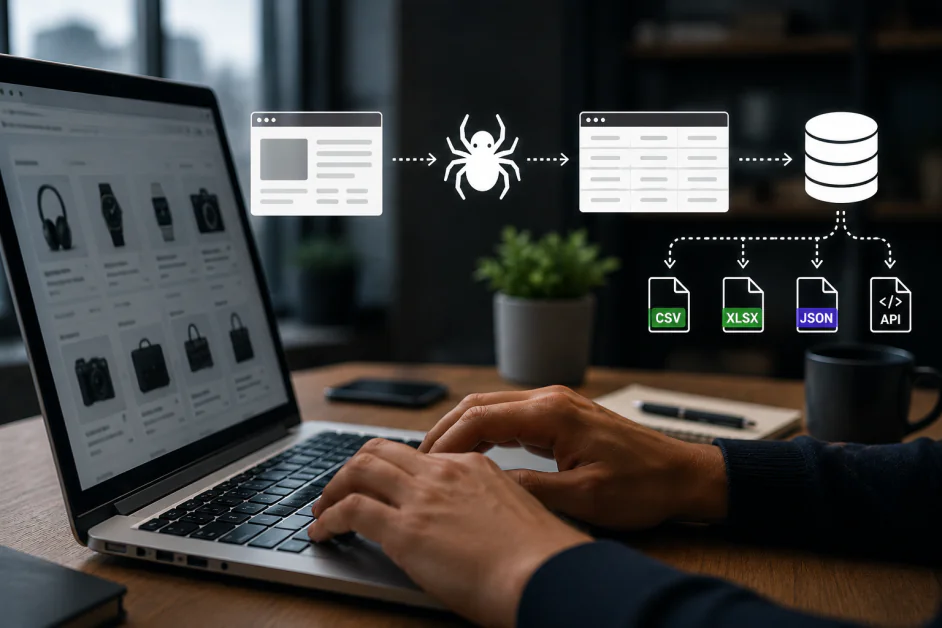
AI‑verktyg för webbskrapning är inte längre bara sidparser. De bästa plattformarna hjälper team att samla in offentlig webbdata, omvandla röriga sidor till strukturerade dataset, mata in retrieval‑augmented generation‑system, övervaka marknader och ge AI‑agenter pålitlig webbkontext.
Denna förändring är viktig eftersom skrapning har blivit både mer värdefull och svårare att utföra väl. Moderna webbplatser är dynamiska, personligt anpassade, kraftigt skriptade och ofta skyddade av anti‑missbrukssystem. Ett användbart skrapningsverktyg måste göra mer än att bara hämta HTML. Det måste hantera rendering, extraktionslogik, schemaläggning, datakvalitet, efterlevnad och överlämning till de system där data faktiskt används.
Det rätta valet beror på uppgiften. Vissa team behöver företagsklassad infrastruktur för stora offentliga dataprogram. Andra behöver LLM‑klar Markdown, en kodfri robot för återkommande forskning, en utvecklarplattform för webbläsar‑automation eller ett specialiserat API för sökresultat. Verktygen nedan täcker dessa olika tillvägagångssätt.
Vårt team har oberoende utvärderat varje lösning i den här guiden, bedömt dess funktioner, praktiska styrkor, begränsningar och hur väl den passar de användningsfall som återspeglas i våra rankningar.
Bästa AI‑webbskrapningsverktygen jämfört
| AI‑verktyg | Bäst för | Nyckelstyrkor |
|---|---|---|
| Bright Data | Företagswebbskrapning, proxy‑infrastruktur och AI‑datapipelines | Scraper‑API:er, Browser‑API, Scraper Studio, Web Unlocker, proxy‑infrastruktur, dataset, RAG‑arbetsflöden |
| Firecrawl | Omvandla webbplatser till rent, LLM‑klart innehåll för AI‑applikationer | Scrape, crawl, search, map, monitor, Markdown, strukturerad JSON, webbläsarinteraktion, API, MCP, öppen källkod |
| Apify | Utvecklare som bygger skalbara skrapare, webbläsar‑automation och data‑agenter | Actor‑marknadsplats, Crawlee, Playwright, Puppeteer, Selenium, schemaläggning, proxy‑er, dataset, API:er, MCP‑integrationer |
| Browse AI | Kodfri webbskrapning, webbplatsövervakning och återkommande affärsdatainsamling | AI‑robotar, point‑and‑click‑träning, webbplatsövervakning, schemalagd extraktion, färdiga robotar, integrationer |
| SearchAPI | Realtids‑SERP‑ och sökmotor‑data för AI, SEO och forskningsarbetsflöden | Google, Google Maps, Bing, YouTube, shopping‑ och nyhetsdata, strukturerad JSON, geotargeting, proxy‑rotation, omförsök, MCP |
| ScrapingBee | Utvecklarvänligt skrap‑API med AI‑extraktion och JavaScript‑rendering | Naturlig‑språk‑extraktion, strukturerad JSON, Markdown, JavaScript‑scenarier, proxy‑rotation, skärmbilder, dedikerade API:er, CLI, MCP |
| Octoparse | Visuell kodfri skrapning av dynamiska webbplatser och återkommande molnjobb | Visuell arbetsflödesbyggare, AI‑autodetektion, molnutdragning, mallar, IP‑rotation, schemaläggning, export, API:er |
| Oxylabs | Företags‑skrap‑API:er, AI‑grundning och svåra offentliga webbplatser | Web Scraper API, AI Studio, Headless Browser, Web Unblocker, Fast Search API, strukturerad data, geotargeting |
| Diffbot | Automatisk sidklassificering, entitetsutvinning och Knowledge Graph‑åtkomst | Extract API, Crawl API, Knowledge Graph, entitets‑förstärkning, naturlig språkbehandling, datorseende, strukturerade dataset |
| ScrapeGraphAI | Naturlig‑språk‑extraktion med strukturerad JSON och AI‑ramverksintegrationer | Prompt‑baserad extraktion, JSON‑scheman, crawling, övervakning, JavaScript‑rendering, SDK:er, CLI, MCP, LangChain‑ och CrewAI‑integrationer |
Hur du väljer ett AI‑webbskrapningsverktyg
Börja med att definiera vilken typ av webbdataproblem du faktiskt har. Om målet är att förse en AI‑produkt med ren webbkontext, prioritera Markdown, strukturerad JSON, crawl‑kontroller och retrieval‑vänlig output. Om målet är återkommande affärsforskning kan en kodfri robot eller en visuell arbetsflödesbyggare vara snabbare. Om målet är storskalig insamling av offentlig data, leta efter djup infrastruktur: rendering, köer, proxy‑kontroller, upplåsning, övervakning och pålitlig leverans.
Den andra frågan är vem som ska underhålla arbetsflödet. Ett marknadsföringsteam som spårar konkurrenters sidor behöver en helt annan produkt än ett ingenjörsteam som bygger en datapipeline. Bra skrapningssystem gör extraktion repeterbar, men de eliminerar inte behovet av validering. Webbplatser förändras, fält drifttar, och AI‑assistenter kan låta självsäkra även när en sida är tvetydig. Den bästa lösningen är den som matchar ditt teams tekniska kompetens, granskningsprocess och efterlevnadsbehov.
10 bästa AI‑webbskrapningsverktygen
1. Bright Data
Bright Data är det starkaste alternativet när webbdatainsamling är ett kärnsystem snarare än ett sidoprojekt. Det kombinerar scraper‑API:er, webbläsarinfrastruktur, proxy‑hantering, upplåsnings‑teknik och färdiga dataset så att team kan samla in offentlig webbdata i stor skala utan att själva sätta ihop varje lager.
Plattformen är särskilt användbar för företag som bygger marknadsintelligens, e‑handelsövervakning, sök‑intelligens, AI‑träningsdataset, retrieval‑augmented generation‑pipelines eller konkurrens‑dataprodukter. Bright Data ger tekniska team tillräcklig kontroll för att bygga komplexa arbetsflöden samtidigt som den erbjuder hanterade vägar för team som vill ha strukturerad data utan att underhålla en skör skrapningsstack.
Denna bredd är också köpkriteriet. Bright Data är mest meningsfullt när en organisation kan tilldela ingenjörs‑ eller data‑operationsansvar, definiera godkända mål och övervaka kvalitet och kostnad över tid. Små team med en begränsad lista av enkla webbplatser kan ha bättre nytta av ett lättare API eller en kodfri tjänst, medan reglerade program bör anpassa insamlingspolicyer till juridisk och integritetsgranskning.
Fördelar och nackdelar
- Bredaste infrastrukturtäckning i denna ranking
- Starkt för hög volym och svåra offentliga webbplatser
- Färdiga skrapare och dataset minskar byggetid
- Användbart för AI‑datapipelines, sök‑intelligens och e‑handelsövervakning
- Mer infrastruktur än små, sporadiska projekt behöver
- Team måste fortfarande ha tydlig datastyrning och mål‑sitesregler
- Avancerade användningsfall kräver teknisk uppsättning och övervakning
2. Firecrawl
Firecrawl är byggt för AI‑eran av webbskrapning. Istället för att tvinga utvecklare att rensa rå HTML, hantera sidrendering och manuellt normalisera rörigt innehåll, omvandlar det webbplatser till ren Markdown eller strukturerad data som kan mata agenter, retrieval‑system, forskningsverktyg och produktarbetsflöden.
Det attraktiva är enkelheten på applikationslagret. Utvecklare kan skrapa en sida, crawla en webbplats, söka webben, kartlägga URL:er, övervaka förändringar eller begära strukturerad output med mycket mindre “plumbing” än en traditionell skrapningsstack. Firecrawl är ett särskilt bra val när slutprodukten är en AI‑assistent, kunskapsbas, forskningsarbetsflöde eller retrieval‑augmented generation‑system.
Team bör betrakta Firecrawl som innehålls‑anskaffningslagret snarare än hela dataplatån. Produktion kräver fortfarande mål‑avgränsning, deduplicering, färskhetsregler, schemavalidering och observabilitet när webbplatser förändras. Värdet är högst när utvecklare vill ha ett koncist API och möjlighet till själv‑hosting, men inte behöver den breda proxy‑kontrollen eller hanterade dataset som levereras av företagsinfrastruktur‑leverantörer.
Fördelar och nackdelar
- Utmärkt för AI‑appar som behöver ren webbkontext
- Markdown och strukturerad output minskar efterbearbetning
- Användbart API‑yttersnitt för scrape, crawl, search, map och monitor‑arbetsflöden
- Öppen källkod ger tekniska team mer deploymentsflexibilitet
- Inte en fullständig proxy‑ eller företags‑datainfrastrukturplattform
- Komplex extraktion gynnas fortfarande av schema‑design och validering
- Team med strikta efterlevnadsbehov bör granska implementering och lagringsval noggrant
3. Apify
Apify är ett starkt val för team som vill ha både en utvecklarplattform och en stor marknadsplats med färdiga web‑automationsverktyg. Dess Actor‑modell gör det möjligt att paketera skrapare, webbläsar‑automation och dataarbetsflöden som återanvändbara molnjobb som kan schemaläggas, anropas via API, kopplas till lagring och delas inom ett team.
Utvecklare får en praktisk väg från prototyp till produktion. De kan bygga med Crawlee, Playwright, Puppeteer, Selenium eller befintliga Actors, och sedan använda Apify för exekvering, köer, proxy‑hantering, dataset, webhooks och integrationer. Det gör plattformen särskilt användbar för team som behöver repeterbara datajobbar snarare än engångsextraktioner.
Apifys flexibilitet är både en styrka och ett ansvar. Team måste välja pålitliga Actors, kontrollera versioner, övervaka körningar och budgetera för beräknings‑, proxy‑ och lagringskostnader när arbetsbelastningen växer. Det är bäst för utvecklare som vill ha återanvändbara byggblock och moln‑operationer på ett ställe; tillfälliga användare kan finna ett specialbyggt skrapverktyg snabbare att lära sig.
Fördelar och nackdelar
- Stor marknadsplats med färdiga Actors för vanliga mål
- Kraftfulla utvecklarverktyg för anpassad skrapning och webbläsar‑automation
- Lämplig för schemalagda, repeterbara datainsamlingsarbetsflöden
- Crawlee‑stöd ger tekniska team en flexibel öppen‑källkodsbas
- Kvaliteten på marknadsplatsen varierar per Actor och användningsfall
- Anpassade jobb kräver fortsatt underhåll när webbplatser förändras
- Ej‑tekniska användare kan föredra ett enklare visuellt skrapverktyg
4. Browse AI
Browse AI är bäst för affärsteam som behöver webbdata men inte vill bygga egna skrapare. Användare tränar en robot genom att visa vad som ska samlas in, och kör sedan roboten på begäran eller enligt schema. Det gör verktyget användbart för att spåra konkurrenter, övervaka listor, samla leads, bevaka lager eller omvandla repetitiv forskning till ett återkommande arbetsflöde.
Styrkan ligger i tillgängligheten. Browse AI ger drift, marknadsföring, rekrytering, e‑handel och forskningsgrupper ett praktiskt sätt att samla strukturerad data från webbplatser utan att ingenjörsteamet måste underhålla varje selektor. Det försöker inte vara den djupaste utvecklarplattformen; det försöker göra repeterbar webbdatainsamling tillgänglig.
Browse AI fungerar bäst när mål‑arbetsflödet kan demonstreras tydligt och granskas av en människa. Användare bör testa paginering, inloggningssteg, tomma tillstånd och layout‑förändringar innan de förlitar sig på automation för beslut. Det är ett starkt val för avdelningsprojekt, men ingenjörsledda program kan behöva mer granular kontroll över omförsök, datakontrakt och distribution.
Fördelar och nackdelar
- Stark kodfri upplevelse för affärsanvändare
- Lämplig för återkommande övervakning och kalkylblads‑liknande arbetsflöden
- Point‑and‑click‑robotträning är enklare än selektor‑baserad konfiguration
- Användbart för team som behöver webbdata utan ingenjörsstöd
- Mindre flexibel än utvecklar‑första plattformar för komplex logik
- Robotar kan behöva justeras när mål‑sidor förändras markant
- Stora eller starkt anpassade program kan växa ur en kodfri metod
5. SearchAPI
SearchAPI är en specialiserad skrapningstjänst för team som behöver aktuella sökmotorresultat som strukturerad data snarare än rå resultatsidor. Ett enda API‑yttersnitt kan returnera organiska länkar, annonser, nyheter, kartlistningar, shoppingresultat, kunskapspaneler, “People Also Ask”-frågor, AI‑genererade sökfunktioner och andra resultattyper i JSON, beroende på valt sökmotor.
Plattformen är särskilt användbar för SEO‑övervakning, lokal sökanalys, marknadsundersökning, produktintelligens och AI‑agenter som behöver realtids‑sök‑kontext. SearchAPI hanterar webbläsar‑rendering, proxy‑rotation, omförsök och CAPTCHA‑hantering bakom begäran, medan lokalisering‑parametrar stödjer land, språk, plats och enhetsspecifika frågor. Dess dokumenterade motorer sträcker sig bortom standard‑Google‑resultat till källor som Google Maps, Bing, YouTube, nyheter och handelssökningar.
SearchAPI erbjuder även en MCP‑server för att koppla stödda AI‑assistenter och utvecklingsmiljöer till sina sökverktyg. Trade‑offen är specialisering: detta är ett starkt sök‑dataskikt, inte en generell crawler för att extrahera godtyckliga fält från vilken webbplats som helst. Köpare bör även modellera användning noggrant eftersom planerna är kredit‑baserade, genomströmning varierar per nivå och rikare sökyttersnitt fortfarande kräver schemavalidering när uppströms‑layouter förändras.
Fördelar och nackdelar
- Returnerar strukturerad realtids‑SERP‑data utan att behöva underhålla sök‑skrapare eller proxy‑infrastruktur
- Stöder stora sök‑, kart‑, video‑, nyhets‑, shopping‑ och andra specialiserade resultatmotorer
- Plats‑, språk‑, land‑ och enhetskontroller passar rank‑spårning och marknadsundersökning
- API‑ och MCP‑åtkomst gör sökdata praktisk för applikationer och AI‑agenter
- Fokuserad på sökmotor‑resultatdata snarare än godtycklig webb‑crawling
- Kredit‑baserade planer och genomströmningstak kräver prognostisering för högvolym‑arbetsbelastningar
- Applikationer bör validera fält när sökmotorer ändrar resultatlayout
6. ScrapingBee
ScrapingBee är ett utvecklarvänligt API för team som vill samla och strukturera webbdata utan att underhålla headless‑webbläsare eller proxy‑infrastruktur. Det kombinerar JavaScript‑rendering, proxy‑rotation, skärmbilder, CSS/XPath‑extraktion och ett AI‑extraktionslager som omvandlar naturliga språk‑förfrågningar och fält‑regler till strukturerad JSON.
Plattformen är särskilt användbar när utvecklare vill ha en enda endpoint för både enkla sidor och interaktiva webbplatser. JavaScript‑scenarier kan klicka, scrolla, skriva eller vänta innan extraktion, medan Markdown‑output, dedikerade API:er, CLI och MCP‑integrationer hjälper det skrapade innehållet att flytta in i analys, automation och AI‑arbetsflöden. ScrapingBee är enklare att anta än en full skrapningsstack, även om kreditförbrukning kan variera med premium‑proxy, rendering och AI‑funktioner.
ScrapingBee passar bäst när ingenjörer vill ha ett hanterat begärandelager men behålla orkestrering och datakvalitet i sin egen applikation. Team bör definiera omförsöksregler, scheman, crawl‑gränser och validering för flersidiga jobb istället för att behandla varje lyckad HTTP‑respons som pålitlig data. En visuell desktop‑skrapare blir enklare för icke‑tekniska användare, men API‑team får mer direkt kontroll över integration och distribution.
Fördelar och nackdelar
- Naturlig‑språk‑AI‑extraktion kan returnera strukturerad JSON utan handbyggda selektorer
- JavaScript‑rendering och skriptade åtgärder hanterar många dynamiska sid‑arbetsflöden
- Proxy‑rotation, skärmbilder, Markdown‑output och dedikerade API:er finns via en tjänst
- CLI, MCP och automations‑integrationer passar utvecklare och agent‑arbetsflöden
- Kreditförbrukning ökar när förfrågningar inkluderar AI‑extraktion, premium‑proxy eller JavaScript‑rendering
- Det är en API‑först‑produkt snarare än en visuell desktop‑skrapare
- Komplexa flersidiga crawls kräver fortfarande orkestrering och kvalitetskontroller
7. Octoparse
Octoparse är en mogen kodfri skrapare för användare som vill ha ett visuellt arbetsflöde snarare än ett utvecklar‑ramverk. Den kan upptäcka siddata, guida användare genom extraktionssteg och köra skrapjobb i molnet, vilket gör den användbar för återkommande insamling från e‑handelsplatser, kataloger, listor, söksidor och andra strukturerade webbkällor.
Plattformen är starkast när ett team behöver mer arbetsflödeskontroll än en snabb webbläsartilläggsskära, men ändå vill undvika kodning. Mallar, schemaläggning, molnutdragning, automatiska exporteringar och stöd för dynamiska sidor gör Octoparse till en praktisk mellanställning mellan enkla kodfria verktyg och ingenjörsledda skrapningsplattformar.
Den visuella modellen kräver fortfarande noggrann arbetsflödesdesign. Team bör testa paginering, oändlig scroll, inloggningsstatus, dubblettposter och felgrenar innan de förlitar sig på schemalagda jobb. Octoparse passar analytiker och driftspersonal som kan äga dessa kontroller, medan utvecklare som bygger strikt versionsstyrda pipelines kan föredra ett API‑ eller kod‑först‑ramverk med starkare källkontroll och automatiserad testning.
Fördelar och nackdelar
- Visuell arbetsflödesbyggare ger användare mer kontroll än enkla ett‑klick‑verktyg
- Molnutdragning möjliggör återkommande jobb utan lokal maskin
- Mallar minskar uppsättningstid för vanliga webbplatser och datatyper
- Lämplig för driftsteam som behöver repeterbara strukturerade dataset
- Arbetsflödesdesign kan ta tid på komplicerade webbplatser
- Mindre naturlig för utvecklingsteam som föredrar kod‑först pipelines
- Kontinuerlig övervakning behövs fortfarande när mål‑sajter förändras
8. Oxylabs
Oxylabs är ett starkt val för team som behöver pålitlig åtkomst till offentlig webbdata i skala och inte vill själva hantera proxy‑rotation, rendering och anti‑blockeringslager. Dess Web Scraper API är designat för att samla strukturerad offentlig data från ett brett spektrum av mål samtidigt som mycket av skrapningsinfrastrukturen hanteras bakom kulisserna.
Företaget har också fördjupat sig i AI‑datapipelines med AI Studio, Fast Search API, webbläsar‑automation och grundläggande användningsfall för grounding. Det gör Oxylabs relevant för organisationer som bygger marknadsintelligenssystem, sökövervakning, modell‑grounding‑pipelines, e‑handelsdataset och agent‑arbetsflöden som kräver färsk webbkontext.
Oxylabs är mest övertygande när pålitlighet, mål‑svårighet eller geografisk räckvidd motiverar en företagsinriktad tjänst. Köpare bör kartlägga mål‑sajter, output‑krav, svarstider och efterlevnadsansvar innan de väljer en produktkonfiguration. Små projekt kanske inte utnyttjar plattformens fulla infrastrukturdjup, medan stora program fortfarande behöver oberoende kvalitetsövervakning eftersom framgångsrik insamling inte garanterar korrekt normalisering.
Fördelar och nackdelar
- Stark företagsklassad skrap‑ och proxy‑infrastruktur
- Användbar för offentliga webbdatapipelines som kräver skala och pålitlighet
- AI Studio och Fast Search API stödjer agent‑ och grounding‑arbetsflöden
- Lämplig för svåra dynamiska webbplatser och geotargeterad insamling
- Passar bäst för team med definierade tekniska och efterlevnadskrav
- Kan vara mer infrastruktur än vad små kodfria projekt behöver
- Avancerade arbetsflöden kräver noggrann mål‑urval och validering
9. Diffbot
Diffbot skiljer sig från de flesta webbskrapningsverktyg eftersom det fokuserar på att förstå sidor och entiteter, inte bara samla fält. Dess extraktionsteknik klassificerar sidor, identifierar strukturerade entiteter och kopplar webbdata till ett bredare Knowledge Graph, vilket är användbart när målet är berikad, normaliserad information snarare än råa skrapade rader.
Det gör Diffbot särskilt relevant för team som arbetar med entitets‑intelligens, företag‑ och persondata, marknadsundersökning, kunskapsgrafer, medieövervakning och AI‑system som behöver strukturerade fakta från det öppna webben. Det är mindre ett snabbt point‑and‑click‑verktyg och mer ett webb‑skala extraktions‑ och kunskapslager.
Den huvudsakliga köpkriteriet är om Diffbots datamodell matchar de entiteter och relationer som projektet kräver. När den gör det kan team undvika att bygga sid‑specifika parser och beriknings‑pipelines från grunden. När den inte gör det kan en konventionell skrapare erbjuda mer direkt kontroll. Utvärderingen bör omfatta representativa sidor, fält‑täckning, uppdateringsfrekvens, entitets‑upplösning och hur provenance bevaras nedströms.
Fördelar och nackdelar
- Stark automatisk extraktion och entitetsförståelse
- Knowledge Graph‑åtkomst ger kontext bortom en enskild sida
- Användbart för berikning, forskning och strukturerade intelligensarbetsflöden
- Lämplig när normaliserade entiteter är viktigare än råa sidtabeller
- Mindre intuitivt för enkel kalkylblads‑stil skrapning
- Bästa resultat beror på om Diffbots modeller passar mål‑innehållstypen
- Team måste förstå Knowledge Graph och API‑modellen för att få fullt värde
10. ScrapeGraphAI
ScrapeGraphAI är designat för användare som vill beskriva den data de behöver i naturligt språk och få strukturerad output. Istället för att skriva selektorer för varje fält kan team ange en URL, definiera önskad information och använda AI‑assisterad extraktion för att returnera ren JSON för applikationer, forskningsarbetsflöden eller agenter.
Det är ett bra val för utvecklare som bygger AI‑arbetsflöden kring webbdata, särskilt när extraktionsuppgiften förändras ofta eller måste kopplas till ramverk som LangChain, CrewAI, SDK:er, kommandoradsverktyg eller MCP‑aktiverade miljöer. Den största fördelen är flexibilitet: extraktionslogiken kan drivas av promptar snarare än att vara helt bunden till sköra sid‑selektorer.
Denna flexibilitet gör validering extra viktig. Team bör definiera scheman, omförsöks‑beteende, evidens‑fält och prov‑granskningsregler innan produktionsanvändning, eftersom ett plausibelt svar inte nödvändigtvis är en komplett extraktion. ScrapeGraphAI är attraktivt för experiment och adaptiva arbetsflöden, medan stabila högvolym‑jobb fortfarande kan gynnas av deterministiska selektorer eller ett hybrid‑tillvägagångssätt som använder AI endast där sidstruktur varierar.
Fördelar och nackdelar
- Naturlig‑språk‑extraktion är användbar för föränderliga eller utforskande uppgifter
- Strukturerad JSON‑output passar AI‑applikationer och automationsarbetsflöden
- Utvecklar‑integrationer stödjer agent‑ och orkestrerings‑use‑cases
- Hjälpsamt när selector‑underhåll skulle bromsa experimentering
- AI‑extraktion bör valideras innan produktionsanvändning
- Prompt‑design och scheman påverkar output‑konsistens
- Mindre lämplig för team som behöver ett helt visuellt kodfritt arbetsflöde
Vanliga frågor
Vad gör ett webbskrapningsverktyg AI‑drivet?
AI‑drivna skrapare hjälper vanligtvis med en eller flera av fyra uppgifter: identifiera fält på en sida, omvandla sidinnehåll till strukturerad data, styra en webbläsare via naturliga språk‑instruktioner eller förbereda skrapat innehåll för AI‑system. De bästa verktygen kräver fortfarande tydliga prompts, scheman, validering och regler för vilken data som ska samlas in.
Vad är skillnaden mellan skrapning och webbläsar‑automation?
Skrapning fokuserar på att extrahera data från sidor. Webbläsar‑automation styr en webbläsare för att klicka, scrolla, logga in, fylla i formulär, vänta på dynamiskt innehåll eller gå igenom ett flerstegs‑arbetsflöde. Många moderna verktyg kombinerar båda, men distinktionen är viktig: en statisk produktlista är ett skrap‑jobb, medan ett arbetsflöde som kräver navigering och interaktion kan behöva webbläsar‑automation.
Vilket output‑format är bäst för ett RAG‑system?
Retrieval‑augmented generation‑system fungerar oftast bäst med ren text, Markdown, strukturerad JSON, metadata och stabila käll‑URL:er. Målet är inte bara att samla innehåll utan att bevara tillräcklig struktur för chunking, retrieval, citering och kvalitetskontroller. Rå HTML kan vara användbart, men det skapar ofta extra städningsarbete innan datan blir användbar för en AI‑applikation.
Kan AI‑skrapare hantera JavaScript‑webbplatser?
Många kan det, men kvaliteten beror på produkten. Vissa verktyg renderar sidor i en webbläsare, andra använder headless‑browser‑infrastruktur, och åter andra förlitar sig på extraktion efter att sidan har laddats. JavaScript‑stöd är viktigt för e‑handel, marknadsplatser, sociala plattformar, instrumentpaneler och moderna webbappar där den användbara datan visas efter det initiala sidresponsen.
Är kodfria skrapare lämpliga för stora projekt?
Kodfria skrapare kan vara utmärkta för återkommande affärsarbetsflöden, konkurrens‑övervakning, lead‑forskning och driftsuppgifter. Större program kan så småningom behöva API:er, köer, övervakning, proxy‑infrastruktur, versionskontroll, datavalidering och ingenjörsansvar. De bästa kodfria verktygen är starkast när arbetsflödet är tydligt och teamet vill ha snabbhet utan att bygga en egen skrapare.
Är webbskrapning lagligt?
Lagligheten kring webbskrapning beror på jurisdiktion, målwebbplats, datatyp, åtkomstmetod och hur datan används. Insamling av offentlig webbdata kan fortfarande väcka kontrakts‑, integritets‑, immaterial‑rätts‑, cybersäkerhets‑ och plattforms‑policy‑frågor. Team bör granska tillämpliga lagar, robots.txt och villkor där det är relevant, interna efterlevnads‑policyer samt känsligheten i den data som samlas innan de kör ett skrapningsprogram.
Bör AI‑genererade extraktionsresultat valideras?
Ja. AI kan göra skrapning mer flexibel, men den kan också misstolka sidor, slå ihop fält, missa dold kontext eller returnera inkonsekventa strukturer när layouter förändras. Produktionsarbetsflöden bör inkludera schemavalidering, provgranskning, förändrings‑larm, felhantering och mänsklig granskning för känsliga beslut.
Slutliga tankar om AI‑webbskrapningsverktyg
Bright Data är det starkaste övergripande valet för team som behöver seriös infrastruktur och stora offentliga‑dataprogram. Firecrawl är det renaste alternativet för AI‑applikationer som kräver LLM‑klar webbkontext, medan Apify ger utvecklare en flexibel plattform för anpassade skrapare, Actors och webbläsar‑automation.
För affärsteam gör Browse AI och Octoparse återkommande datainsamling mer tillgänglig utan att varje arbetsflöde blir ett ingenjörsprojekt. ScrapingBee är ett starkt utvecklar‑vänligt API för naturlig‑språk‑extraktion, JavaScript‑rendering och strukturerad output utan att behöva underhålla webbläsare och proxy‑infrastruktur.
SearchAPI sticker ut när kravet är färsk, strukturerad sökmotor‑data för SEO, forskning eller AI‑agenter snarare än godtycklig webb‑crawling. Oxylabs är bäst för företags‑skrap‑API:er och svåra offentliga webbplatser, Diffbot är övertygande när entitets‑utvinning och Knowledge Graph‑kontext är viktigt, och ScrapeGraphAI är ett flexibelt prompt‑drivet extraktionsalternativ för AI‑arbetsflöden.




