
Интервью
Ксавье Конорт, сооснователь и директор по продукту FeatureByte — серия интервью

 Добавьте Unite.AI в избранные источники в Google
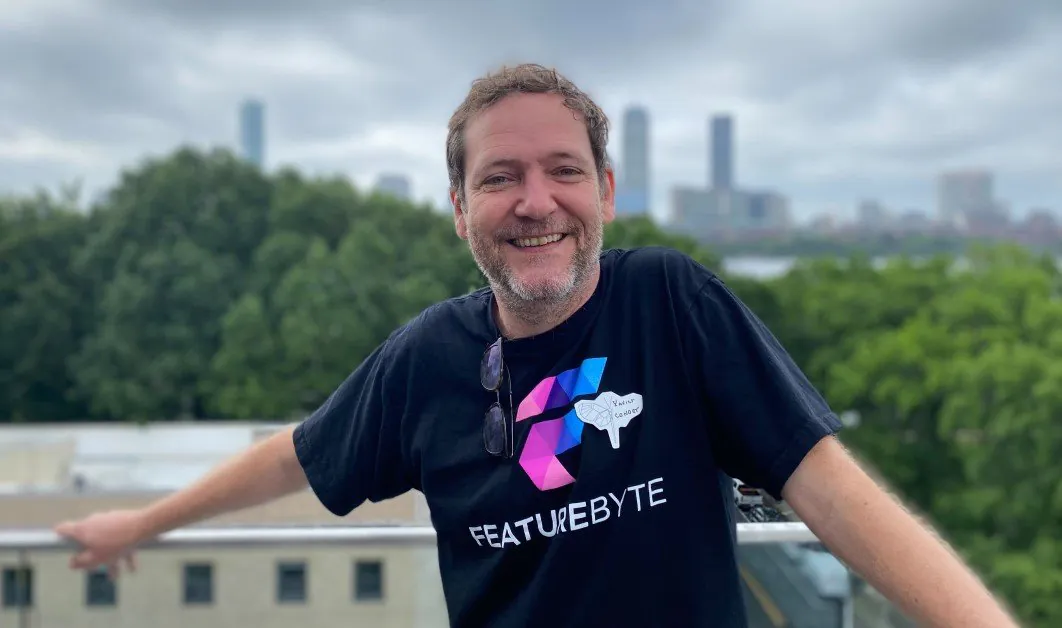
Ксавье Конорт – видный ученый в области данных с более чем 25-летним опытом работы с данными. Он начал свою карьеру как актуарий в страховой индустрии, а затем перешел в область науки о данных. Он является одним из лучших участников конкурса Kaggle и был главным ученым по данным в компании DataRobot до того, как стал сооснователем FeatureByte.
FeatureByte ставит своей целью масштабировать корпоративный ИИ, радикально упрощая и индустриализируя данные ИИ. Платформа для конструирования признаков и управления ими позволяет ученым создавать и делиться передовыми признаками и готовыми к производству конвейерами данных за считанные минуты – вместо недель или месяцев.
Вы начали свою карьеру как актуарий в страховой индустрии, прежде чем перейти в область науки о данных. Что стало причиной этого перехода?
Одним из определяющих моментов стала победа в конкурсе GE Flight Quest, организованном компанией GE с призовым фондом в 250 тысяч долларов, где участникам предлагалось предсказать задержки внутренних рейсов в США. Я обязан частью этого успеха ценной практике страхования: двухэтапному моделированию. Этот подход помогает контролировать смещение в признаках, которые не имеют достаточного представительства в доступных данных для обучения. Вместе с другими победами на Kaggle, это достижение убедило меня в том, что мой актуарный опыт дает мне конкурентное преимущество в области науки о данных.
Во время моего участия в Kaggle, я также имел возможность связаться с другими энтузиастами науки о данных, включая Джереми Ачина и Тома Де Годоя, которые позже стали основателями DataRobot. Мы разделяли общий опыт работы в страховой индустрии и достигли заметных успехов на Kaggle. Когда они запустили DataRobot, компанию, специализирующуюся на AutoML, они пригласили меня присоединиться к ним в качестве главного ученого по данным. Их видение объединения лучших практик из страховой индустрии с возможностями машинного обучения вдохновило меня на создание чего-то инновационного и влиятельного.
В DataRobot вы сыграли ключевую роль в разработке плана развития науки о данных. С какими проблемами, связанными с данными, вы столкнулись?
Одной из наиболее значительных проблем, с которыми мы столкнулись, была переменная качество данных, предоставляемых в качестве входных данных для нашего решения AutoML. Эта проблема часто приводила либо к длительному сотрудничеству между нашей командой и клиентами, либо к разочаровывающим результатам в производстве, если не были приняты соответствующие меры. Проблемы качества данных исходили из нескольких источников, требующих нашего внимания.
Одной из основных проблем стала общая практика использования инструментов бизнес-интеллекта для подготовки и управления данными. Хотя эти инструменты ценны для получения информации, они не обладают возможностями, необходимыми для обеспечения корректности данных на соответствующий момент времени для подготовки данных машинного обучения. В результате могли возникать утечки в данных для обучения, что приводило к переобучению и неточной производительности модели.
Недостаточная коммуникация между учеными и инженерами по данным была еще одной проблемой, которая влияла на точность моделей в производстве. Несоответствия между фазами обучения и производства, возникающие из-за несоответствия между этими двумя командами, могли повлиять на производительность модели в реальном окружении.
Какие были некоторые из ключевых выводов из этого опыта?
Мой опыт в DataRobot подчеркнул значение подготовки данных в машинном обучении. Решая проблемы, связанные с генерацией данных для обучения моделей, таких как корректность данных на соответствующий момент времени, пробелы в экспертизе, знаниями области, ограничениями инструментов и масштабируемостью, мы можем повысить точность и надежность моделей машинного обучения. Я пришел к выводу, что упрощение процесса подготовки данных и внедрение инновационных технологий сыграют ключевую роль в раскрытии полного потенциала ИИ и выполнении его обещаний.
Мы также услышали от вашего сооснователя Рази Разиуддина о истории создания FeatureByte, можете ли вы рассказать нам свою версию событий?
Когда я обсуждал свои наблюдения и идеи с моим сооснователем Рази Разиуддином, мы поняли, что разделяем общее понимание проблем в подготовке данных для машинного обучения. Во время наших обсуждений, я поделился с Рази своими идеями о недавних достижениях в сообществе MLOps. Я мог наблюдать появление хранилищ признаков и платформ для работы с признаками, которые компании, ориентированные на ИИ, внедряют для снижения задержки предоставления признаков, поощрения повторного использования признаков или упрощения материализации признаков в обучающие данные, обеспечивая при этом согласованность между обучением и производством. Однако было очевидно, что существует пробел в удовлетворении потребностей ученых по данным. Рази поделился со мной своими идеями о том, как современный стек данных революционизировал бизнес-интеллект и аналитику, но не был полностью использован для ИИ.
Стало ясно, что и Рази, и я имеем возможность сделать значительный вклад, радикально упрощая процесс конструирования признаков и предоставляя ученым по данным и инженерам по машинному обучению правильные инструменты и опыт для бесшовного экспериментирования с признаками и их предоставления моделям.
Какие были некоторые из ваших самых больших проблем в переходе от ученого по данным к предпринимателю?
Переход от ученого по данным к предпринимателю потребовал от меня смены перспективы с технической на более широкую, ориентированную на бизнес. Хотя у меня был прочный фундамент в понимании болевых точек, создании дорожной карты, выполнении планов, построении команды и управлении бюджетами, я обнаружил, что создание правильного послания, которое действительно резонирует с нашей целевой аудиторией, было одной из моих самых больших проблем.
Как ученый по данным, моим основным фокусом всегда были анализ и интерпретация данных для получения ценных выводов. Однако как предприниматель, мне необходимо было сместить свое мышление в сторону рынка, клиентов и общего бизнеса.
К счастью, я смог преодолеть эту проблему, используя опыт человека вроде моего сооснователя Рази.
Мы услышали от Рази, почему конструирование признаков так сложно. Что, по вашему мнению, делает его столь трудной задачей?
Конструирование признаков имеет две основные проблемы:
- Преобразование существующих столбцов: это включает в себя преобразование данных в подходящий формат для алгоритмов машинного обучения. Техники, такие как кодирование one-hot, масштабирование признаков и продвинутые методы, такие как преобразования текста и изображений, используются. Создание новых признаков из существующих, например признаков взаимодействия, может значительно повысить производительность модели. Популярные библиотеки, такие как scikit-learn и Hugging Face, предоставляют обширную поддержку этого типа конструирования признаков. Решения AutoML также стремятся упростить этот процесс.
- Извлечение новых столбцов из исторических данных: исторические данные имеют решающее значение в таких областях, как системы рекомендаций, маркетинг, обнаружение мошенничества, страховые тарифы, кредитный скоринг, прогнозирование спроса и обработка данных сенсоров. Извлечение информативных столбцов из этих данных является сложной задачей. Примеры включают время с момента последнего события, агрегации по недавним событиям и векторные представления последовательностей событий. Этот тип конструирования признаков требует экспертизы, экспериментирования, сильных навыков программирования и инженерии данных, а также глубоких знаний науки о данных. Факторы, такие как утечка информации из будущего, обработка больших наборов данных и эффективное выполнение кода, также требуют внимания.
В целом, конструирование признаков требует экспертизы, экспериментирования и создания сложных ад-хок конвейеров данных в отсутствие инструментов, специально разработанных для этого.
Можете ли вы рассказать, как FeatureByte наделяет ученых по данным полномочиями, упрощая конвейеры признаков?
FeatureByte наделяет ученых по данным полномочиями, упрощая весь процесс конструирования признаков. С помощью интуитивно понятного Python SDK, он позволяет быстро создавать и извлекать признаки из больших таблиц событий и предметов. Расчеты эффективно обрабатываются за счет масштабируемости платформ данных, таких как Snowflake, DataBricks и Spark. Блокноты облегчают экспериментирование, а обмен признаками и их повторное использование экономят время. Аудит гарантирует точность признаков, а немедленное развертывание устраняет проблемы с управлением конвейерами.
Помимо этих возможностей, предоставляемых нашей библиотекой с открытым исходным кодом, наше корпоративное решение предоставляет комплексную основу для управления и организации операций ИИ в масштабе, включая рабочие процессы управления и пользовательский интерфейс для каталога признаков.
Каково ваше видение будущего FeatureByte?
Наше окончательное видение для FeatureByte – революционизировать область науки о данных и машинного обучения, наделяя пользователей возможностью раскрыть свой полный творческий потенциал и извлечь беспрецедентную ценность из своих активов данных.
Мы особенно взволнованы быстрым прогрессом в области генеративного ИИ и трансформеров, который открывает мир возможностей для наших пользователей. Кроме того, мы посвящаем себя демократизации конструирования признаков. Генеративный ИИ имеет потенциал снизить барьер входа для творческой конструирования признаков, сделав ее более доступной для более широкой аудитории.
В заключение, наше видение будущего FeatureByte заключается в постоянных инновациях, использовании потенциала генеративного ИИ и демократизации конструирования признаков. Мы стремимся быть платформой, которая позволяет специалистам по данным преобразовывать сырые данные в действенные входные данные для машинного обучения, стимулируя прорывы и достижения во всех отраслях.
У вас есть какие-либо советы для начинающих предпринимателей в области ИИ?
Определите свою область, оставайтесь сосредоточенными и приветствуйте новизну.
Определив нишу, в которой вы хотите занять ведущие позиции, вы можете отличиться и установить сильное присутствие в этой области. Исследуйте рынок, поймите потребности и болевые точки потенциальных клиентов и стремитесь предоставить уникальное решение, которое эффективно решает эти проблемы.
Определите свое долгосрочное видение и установите четкие краткосрочные цели, соответствующие этому видению. Сосредоточьтесь на построении прочной основы и предоставлении ценности в вашей выбранной области.
Наконец, хотя важно оставаться сосредоточенным, не бойтесь принять новизну и исследовать новые идеи в рамках вашей определенной области. Область ИИ постоянно эволюционирует, и инновационные подходы могут открыть новые возможности.
Спасибо за отличное интервью, читателям, которые хотят узнать больше, следует посетить FeatureByte.








