
AGI и будущее ИИ
Роль векторных баз данных в современных генеративных приложениях ИИ

 Добавьте Unite.AI в избранные источники в Google

Для эффективной работы крупномасштабных генеративных приложений ИИ требуется хорошая система для обработки большого объема данных. Одной из таких важных систем является векторная база данных. Что отличает эту базу данных, так это ее способность работать с различными типами данных, такими как текст, звук, изображения и видео, в форме векторов.
Что такое векторные базы данных?
Векторная база данных – это специализированная система хранения, предназначенная для эффективной обработки высокоразмерных векторов. Эти векторы, которые можно рассматривать как точки в многомерном пространстве, часто представляют собой вложения или сжатые представления более сложных данных, таких как изображения, текст или звук.
Векторные базы данных позволяют выполнять быстрые поиски подобия среди этих векторов, что обеспечивает быстрое извлечение наиболее подобных элементов из огромного набора данных.
Традиционные базы данных vs. векторные базы данных
Векторные базы данных:
- Обработка высокоразмерных данных: Векторные базы данных предназначены для управления и хранения данных в высокоразмерных пространствах. Это особенно полезно для приложений, таких как машинное обучение, где данные можно представить в виде векторов в многомерных пространствах.
- Оптимизация для поиска подобия: Одной из выдающихся особенностей векторных баз данных является их способность выполнять поиск подобия. Вместо запросов данных на основе точных совпадений эти базы данных позволяют пользователям извлекать данные, которые похожи на заданный запрос, что делает их бесценными для задач, таких как поиск изображений или текста.
- Масштабируемость для крупных наборов данных: По мере того, как приложения ИИ и машинного обучения продолжают расти, так же растет и объем обрабатываемых ими данных. Векторные базы данных предназначены для масштабирования, что обеспечивает их способность обрабатывать огромные объемы данных без снижения производительности.
Традиционные базы данных:
- Хранение структурированных данных: Традиционные базы данных, такие как реляционные базы данных, предназначены для хранения структурированных данных. Это означает, что данные организованы в предопределенные таблицы, строки и столбцы, что обеспечивает целостность и согласованность данных.
- Оптимизация для операций CRUD: Традиционные базы данных в основном оптимизированы для операций CRUD. Это означает, что они предназначены для эффективного создания, чтения, обновления и удаления записей данных, что делает их подходящими для широкого спектра приложений, от веб-сервисов до корпоративного программного обеспечения.
- Фиксированная схема: Одной из определяющих характеристик многих традиционных баз данных является их фиксированная схема. Как только структура базы данных определена, внесение изменений может быть сложным и трудоемким. Эта жесткость обеспечивает целостность данных, но может быть менее гибкой, чем бессхемная или динамическая структура некоторых современных баз данных.
Традиционные базы данных часто испытывают трудности со сложностью вложений, что легко решается с помощью векторных баз данных.
Векторные представления
Центральным моментом в работе векторных баз данных является фундаментальная концепция представления различных форм данных с помощью числовых векторов. Давайте рассмотрим изображение в качестве примера. Когда вы видите картинку кошки, это может быть просто милым изображением кошки для нас, но для машины оно может быть преобразовано в уникальный 512-мерный вектор, такой как:
[0.23, 0.54, 0.32, …, 0.12, 0.45, 0.90]
С помощью векторных баз данных приложения ИИ могут делать больше. Они могут находить информацию на основе смысла и запоминать вещи на долгое время. Интересно, что этот метод не ограничивается только изображениями. Текстовые данные, наполненные контекстным и семантическим смыслом, также могут быть представлены в виде векторов.
Генеративный ИИ и необходимость векторных баз данных
Генеративный ИИ часто включает в себя вложения. Возьмем, к примеру, вложения слов в обработке естественного языка (NLP). Слова или предложения преобразуются в векторы, которые отражают семантический смысл. При генерации текста, похожего на человеческий, модели должны быстро сравнивать и извлекать соответствующие вложения, обеспечивая, чтобы сгенерированный текст сохранял контекстный смысл.
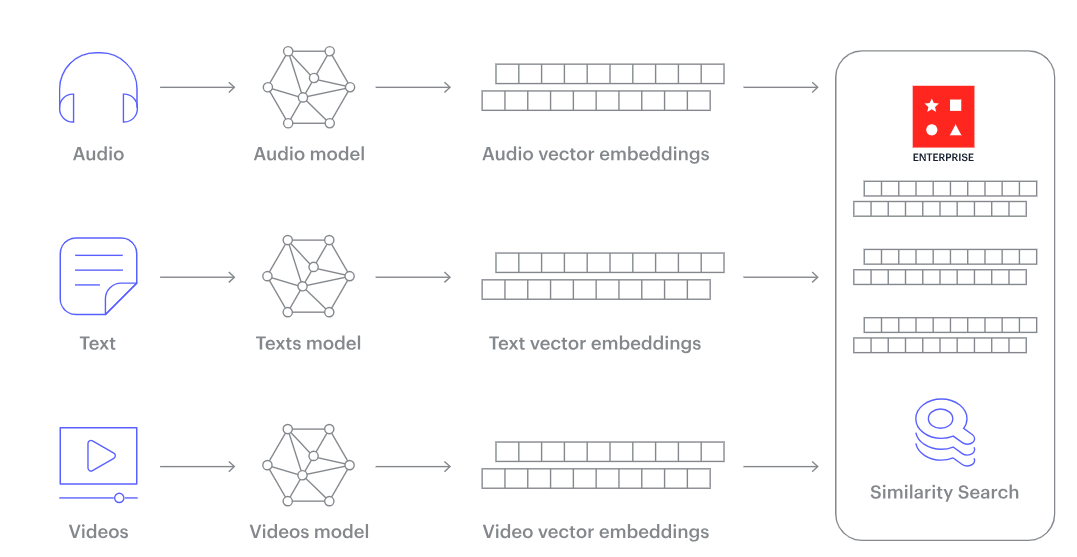
Аналогично, при генерации изображений или звука вложения играют решающую роль в кодировании закономерностей и особенностей. Для того, чтобы эти модели функционировали оптимально, им требуется база данных, которая позволяет мгновенно извлекать подобные векторы, что делает векторные базы данных важнейшим компонентом генеративного ИИ.
Создание вложений для естественного языка обычно включает использование предварительно обученных моделей, таких как:
- GPT-3 и GPT-4: GPT-3 компании OpenAI (Генеративный предварительно обученный трансформер 3) стал монументальной моделью в сообществе NLP с 175 миллиардами параметров. Следующая за ним модель GPT-4, с еще большим количеством параметров, продолжает расширять границы генерации высококачественных вложений. Эти модели обучены на различных наборах данных, что позволяет им создавать вложения, отражающие широкий спектр лингвистических нюансов.
- BERT и его варианты: BERT (Бидирекциональные энкодированные представления из трансформеров) от Google – это еще одна значительная модель, которая прошла через различные обновления и итерации, такие как RoBERTa и DistillBERT. Бидирекциональная тренировка BERT, которая читает текст в обоих направлениях, особенно подходит для понимания контекста, окружающего слово.
- ELECTRA: Более недавняя модель, которая эффективна и работает на уровне с более крупными моделями, такими как GPT-3 и BERT, при этом требуя меньше вычислительных ресурсов. ELECTRA различает реальные и фальшивые данные во время предварительной тренировки, что помогает в генерации более точных вложений.

Понимание вышеуказанного процесса:
Первоначально используется модель вложений для преобразования желаемого контента в векторные вложения. Как только они сгенерированы, эти вложения хранятся внутри векторной базы данных. Для легкой отслеживаемости и релевантности эти хранимые вложения сохраняют ссылку или указатель на исходный контент, из которого они были получены.
Позже, когда пользователь или система задает вопрос приложению, та же модель вложений снова вступает в действие. Она преобразует этот запрос в соответствующие вложения. Эти новые вложения затем ищут в векторной базе данных, чтобы найти векторные представления, которые им подобны. Вложения, определенные как совпадения, имеют прямую связь с исходным контентом, обеспечивая, что запрос пользователя удовлетворяется релевантными и точными результатами.
Растущие инвестиции в новые векторные базы данных
С ростом популярности ИИ многие компании вкладывают больше средств в векторные базы данных, чтобы улучшить свои алгоритмы и сделать их быстрее. Это можно увидеть в недавних инвестициях в стартапы векторных баз данных, такие как Pinecone, Chroma DB и Weaviate.

Крупные компании, такие как Microsoft (MSFT ), также имеют свои собственные инструменты. Например, Azure Cognitive Search позволяет бизнесу создавать инструменты ИИ с помощью векторных баз данных.
Oracle (ORCL ) также объявила о новых возможностях Database 23c, представив интегрированную векторную базу данных. Функция AI Vector Search предусматривает новый тип данных, индексы и инструменты для хранения и поиска документов и изображений в виде векторов. Она поддерживает генерацию с дополнением извлечёнными данными (RAG), объединяющую большие языковые модели с данными компании для более точных ответов без раскрытия конфиденциальной информации.
Основные аспекты векторных баз данных
Метрики расстояния
Эффективность поиска по сходству зависит от выбранной метрики. Распространены евклидово расстояние и косинусное сходство, подходящие для разных распределений векторов.
Индексирование
Из-за высокой размерности векторов традиционные методы индексирования не подходят. Векторные базы данных используют графы Hierarchical Navigable Small World (HNSW) или деревья Annoy, позволяющие эффективно разбивать векторное пространство и быстро искать ближайших соседей.

Дерево Annoy (Источник)
Annoy использует бинарные деревья поиска. Метод многократно разделяет пространство данных и рассматривает лишь его часть, чтобы найти близких соседей.
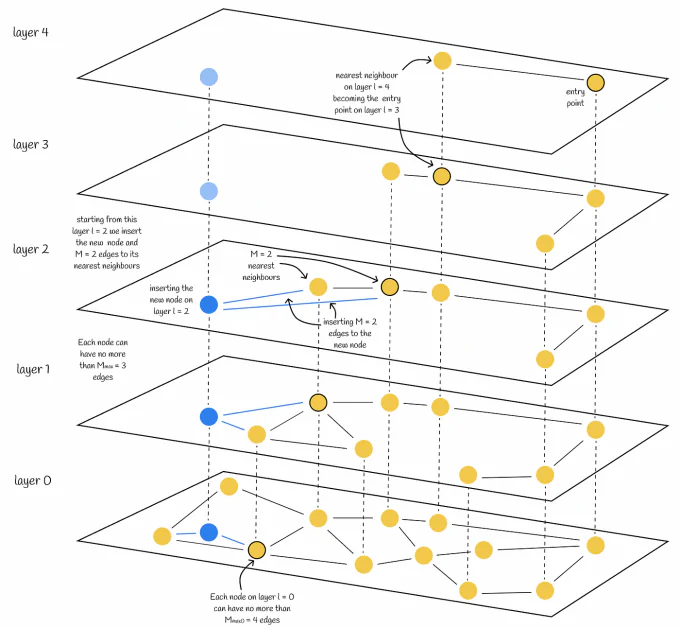
Графы Hierarchical Navigable Small World (HNSW) (Источник)
Графы HNSW, напротив, напоминают сети. Они особым образом соединяют точки данных, ускоряя поиск и помогая быстро находить близкие точки.
Масштабируемость
С ростом наборов данных сохранять высокую скорость извлечения становится сложнее. Векторные базы данных решают эту задачу с помощью распределённых систем, ускорения на GPU и оптимизированного управления памятью.
Роль векторных баз данных: применение и возможности
1. Обучающие данные для передовых моделей генеративного ИИ: Модели, такие как DALL-E и GPT-3, обучаются на огромных объёмах данных. Эти данные часто включают векторы, извлечённые из изображений, текстов, кода и других источников. Векторные базы данных тщательно отбирают эти наборы и управляют ими, позволяя моделям усваивать и анализировать знания, выявляя закономерности и связи между векторами.
2. Развитие обучения на небольшом числе примеров: Few-shot learning — метод обучения ИИ на ограниченном количестве данных. Векторные базы данных помогают ему, поддерживая развитый векторный индекс. Получив лишь несколько векторов, например представляющих изображения птиц, модель может вывести более широкое понятие птицы, распознав сходства и связи между ними.
3. Улучшение рекомендательных систем: Рекомендательные системы используют векторные базы данных, чтобы предлагать контент, соответствующий предпочтениям пользователя. Анализируя его поведение, профиль и запросы, они извлекают векторы интересов. Затем система ищет в базе векторы контента, наиболее близкие к этим интересам, обеспечивая точные рекомендации.
4. Семантический поиск информации: Традиционный поиск опирается на точное совпадение ключевых слов. Векторные базы данных позволяют понимать и извлекать контент на основе семантического сходства. Поиск становится интуитивнее, поскольку учитывает смысл запроса, а не только совпадение слов. Вектор запроса сравнивается с векторами в базе, чтобы найти контент, соответствующий намерению пользователя, а не только формулировке.
5. Мультимодальный поиск: Мультимодальный поиск объединяет данные из разных источников, включая текст, изображения, аудио и видео. Векторные базы данных служат его основой, позволяя совместно анализировать векторы разных модальностей. По одному запросу пользователь может получить сведения из разных источников, более глубокое понимание и более полные результаты.
Заключение
Мир ИИ быстро меняется, затрагивая многие отрасли, создавая преимущества и новые проблемы. Быстрый прогресс генеративного ИИ подчёркивает важную роль векторных баз данных в управлении многомерными данными и их анализе.
Эти специализированные системы хранения, способные обрабатывать высокоразмерные векторы изображений, текста и звука, стали важной основой эффективной работы современных приложений ИИ, особенно поиска по сходству.
Их растущую значимость подтверждают инвестиции в сектор: развитию технологий активно способствуют как стартапы вроде Pinecone, так и крупные компании, включая Microsoft.


