Взгляд Anderson
Как понять, создают ли системы синтеза изображений действительно оригинальный материал

 Добавьте Unite.AI в избранные источники в Google

Ключевые моментыПоказатель редкости (Rarity Score) от KAIST и NAVER оценивает оригинальность…
Показать больше
- Показатель редкости (Rarity Score) от KAIST и NAVER оценивает оригинальность изображения через расстояния до ближайших соседей.
- Существующие метрики, такие как метод усечения (Truncation Trick), отдают предпочтение аутентичности, а не новизне сгенерированных изображений.
- Показатель редкости может выявлять по-настоящему изобретательные результаты систем вроде DALL-E 2.
Новое исследование из Южной Кореи предложило метод определения того, производят ли системы синтеза изображенийдействительно новые изображения или просто незначительные вариации тренировочных данных, что потенциально может противоречить цели таких архитектур (например, производству новых и оригинальных изображений).
Очень часто, как предполагает статья, последнее утверждение верно, поскольку существующие метрики, которые такие системы используют для улучшения своих генеративных возможностей в процессе обучения, вынуждены отдавать предпочтение изображениям, которые относительно близки к (не фальшивым) исходным изображениям в наборе данных.
Ведь если сгенерированное изображение «визуально близко» к исходным данным, оно, скорее всего, будет получать более высокий балл за «аутентичность», чем за «оригинальность», поскольку оно «верно» – хотя и не вдохновляюще.
В секторе, который еще слишком молод и неопробованный, чтобы его юридические последствия были еще известны, это может оказаться важным юридическим вопросом, если окажется, что коммерциализированный синтетический контент изображений не достаточно отличается от (часто) защищенных авторским правом исходных материалов, которые в настоящее время допускаются в исследовательский сектор в виде популярных веб-скрапированных наборов данных (потенциал будущих претензий по поводу нарушения авторских прав такого типа недавно привлек внимание в отношении GitHub Co-Pilot AI от Microsoft ).
В плане все более связного и семантически прочного вывода из систем, таких как OpenAI DALL-E 2, Google Imagen и Китая CogView (а также менее мощных DALL-E mini), существует очень мало последующих способов надежно проверить оригинальность сгенерированного изображения.
Действительно, поиск некоторых из самых популярных новых изображений DALL-E 2 часто приводит только к дальнейшим экземплярам этих же изображений, в зависимости от поисковой системы.

Загрузка полной группы из девяти изображений DALL-E 2 приводит только к другим таким группам, поскольку сетка — самый сильный признак. Если выделить первое изображение из этого поста в Twitter от 8 июня 2022 года, опубликованного аккаунтом Weird Dall-E Generations, и загрузить отдельно, Google сосредоточится на баскетбольном мяче и заведет поиск в семантический тупик. Для того же изображения Yandex, по крайней мере, похоже, действительно анализирует пиксели и сопоставляет признаки.
Хотя Yandex с большей вероятностью, чем Google Search, использует фактические признаки (то есть характеристики, извлеченные или рассчитанные из изображения, а не обязательно черты человеческого лица) и визуальные характеристики (а не семантические) представленного изображения для поиска похожих изображений, все поисковые системы изображений либо имеют определенные цели или методы, которая может затруднить выявление случаев плагиата исходное>сгенерированное через веб-поиск.
Кроме того, тренировочные данные для генеративной модели могут быть не полностью доступны публично, что еще больше препятствует судебной экспертизе оригинальности сгенерированных изображений.
Интересно, что выполнение поиска изображения в одном из синтетических изображений, представленных Google на его посвященном сайте Imagen, не находит ничего сравнимого с предметом изображения, в плане фактического просмотра изображения и беспристрастного поиска похожих изображений. Вместо этого, семантически фиксированный поиск Google не позволяет провести чистый веб-поиск изображения без добавления поисковых терминов «imagen google» в качестве дополнительного (и ограничивающего) параметра:

Yandex, с другой стороны, находит множество похожих (или, по крайней мере, визуально связанных) реальных изображений из художественного сообщества:

В целом было бы лучше, если бы новизна или оригинальность вывода систем синтеза изображений могла бы быть измерена каким-то образом, не требуя извлечения признаков из каждого возможного веб-изображения в момент обучения модели или в не публичных наборах данных, которые могут использовать защищенные авторским правом материалы.
Связано с этой проблемой, исследователи из школы искусственного интеллекта Kim Jaechul в Корейском институте передовых технологий (KAIST AI) сотрудничали с глобальной ИКТ- и поисковой компанией NAVER Corp для разработки Балла редкости, который может помочь определить более оригинальные творения систем синтеза изображений.

Изображения созданы с помощью StyleGAN-FFHQ. Столбцы слева направо показывают результаты от худших к лучшим. У Truncation trick и Realism собственные цели, тогда как новый Балл редкости в верхней строке ищет связные и оригинальные изображения, а не только связные. Из-за ограничения размера иллюстраций подробности и более высокое разрешение смотрите в исходной статье. Источник: https://arxiv.org/pdf/2206.08549.pdf
Новая статья называется Rarity Score: A New Metric to Evaluate the Uncommonness of Synthesized Images (Балл редкости: новая метрика оценки необычности синтетических изображений). Ее написали три исследователя из KAIST и три из NAVER Corp.
За пределами «дешевого трюка»
Среди предыдущих метрик, на которые опирается новая статья, есть «трюк обрезки» предложенный в 2019 году в сотрудничестве между университетом Heriot-Watt в Великобритании и Google DeepMind.
Трюк обрезки по сути использует другое латентное распределение для выборки, чем то, которое использовалось для обучения генеративной модели.
Исследователи, разработавшие этот метод, были удивлены, что он работает, но признают в исходной статье, что он снижает разнообразие сгенерированного вывода. Тем не менее, трюк обрезки стал эффективным и популярным в контексте того, что можно переописать как «дешевый трюк» для получения аутентичных результатов, которые не действительно ассимилируют все возможности, присутствующие в данных, и могут больше походить на исходные данные, чем желательно.
Относительно трюка обрезки авторы новой статьи отмечают:
«Он не предназначен для генерации редких образцов в тренировочных наборах данных, а скорее для синтеза типичных изображений более стабильно. Мы предполагаем, что существующие генеративные модели смогут производить образцы, более богатые реальным распределением данных, если генератор сможет быть побужден эффективно производить редкие образцы».
Общая тенденция полагаться на традиционные метрики, такие как расстояние Фрехе-Инсепшн (FID, которое подверглось интенсивной критике в декабре 2021 года), балл инсепшн (IS) и расстояние ядра Инсепшн (KID) в качестве «индикаторов прогресса» во время обучения генеративной модели, авторы дополнительно комментируют*:
«Эта схема обучения приводит генератор к тому, чтобы не синтезировать много редких образцов, которые уникальны и имеют сильные характеристики, которые не составляют большую часть реального распределения изображений. Примеры редких образцов из публичных наборов данных включают людей с различными аксессуарами в FFHQ, белых животных в AFHQ и необычные статуи в Metfaces.
«Способность генерировать редкие образцы важна не только потому, что она связана с предельными возможностями генеративных моделей, но и потому, что уникальность играет важную роль в творческих приложениях, таких как виртуальные люди.
«Однако качественные результаты нескольких недавних исследований редко содержат эти редкие примеры. Мы предполагаем, что природа схемы противостоящего обучения заставляет распределение сгенерированных изображений быть подобным тому, что в тренировочном наборе данных. Следовательно, изображения с четкой индивидуальностью или редкостью занимают только небольшую часть изображений, синтезированных моделями».
Техника
Новая метрика редкости исследователей адаптирует идею, представленную в предыдущих работах – использование K-ближайших соседей (KNN) для представления массивов настоящих (тренировочных) и синтетических (выводных) данных в системе синтеза изображений.
Относительно этого нового метода анализа авторы утверждают:
«Мы предполагаем, что обычные образцы будут находиться ближе друг к другу, тогда как уникальные и редкие образцы будут разреженно расположены в пространстве признаков».
Результаты изображения выше показывают наименьшие расстояния ближайших соседей (NND) до самых больших в архитектуре StyleGAN, обученной на FFHQ.
«Для всех наборов данных образцы с наименьшими NND показывают типичные и представительные изображения. Напротив, образцы с наибольшими NND имеют сильную индивидуальность и значительно отличаются от типичных изображений с наименьшими NND».
В теории, используя эту новую метрику в качестве дискриминатора, или, по крайней мере, включая ее в более сложную архитектуру дискриминатора, генеративная система могла бы быть направлена подальше от чистой имитации к более изобретательному алгоритму, сохраняя при этом необходимую связность концепций, которые могут быть важными для аутентичного производства изображений (т.е. «мужчина», «женщина», «машина», «церковь» и т. д.).
Сравнения и эксперименты
В тестах исследователи провели сравнение производительности метрики редкости с трюком обрезки и метрикой реализма NVIDIA 2019 года и обнаружили, что во всех рамках и наборах данных этот подход может индивидуализировать «уникальные» результаты.
Хотя результаты, представленные в статье, слишком обширны, чтобы включить их здесь, исследователи, кажется, продемонстрировали способность нового метода выявить редкость как в реальных (настоящих), так и в сгенерированных (фальшивых) изображениях в генеративной процедуре:
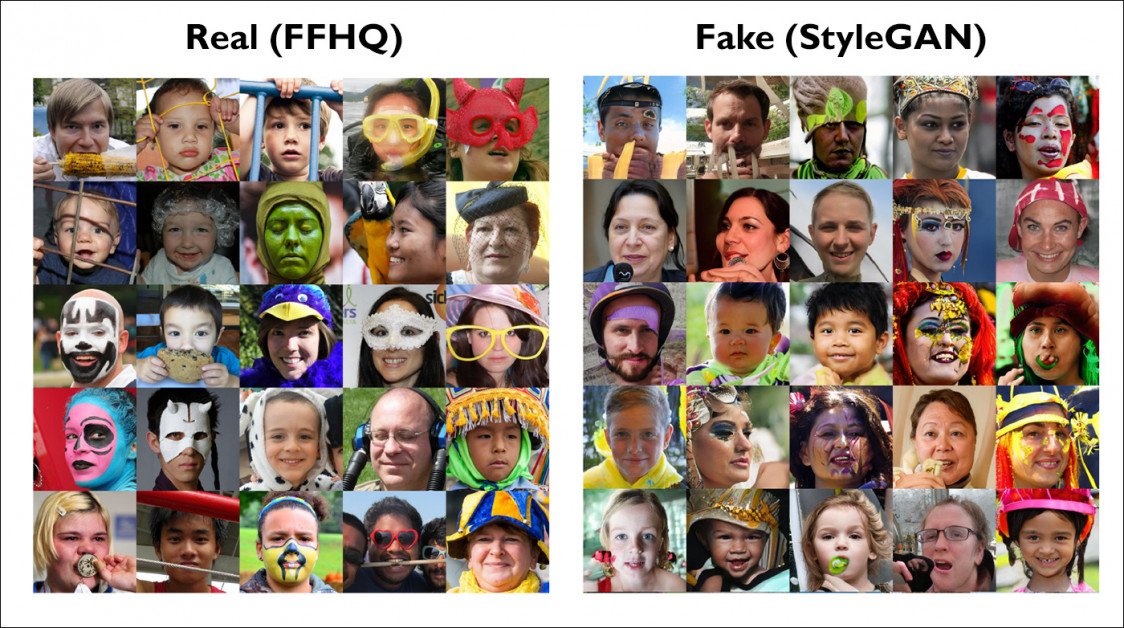
Избранные примеры из обширных визуальных результатов исследования; подробнее см. источник выше. Слева реальные примеры FFHQ с очень малым числом близких соседей в исходном наборе, то есть новые и необычные. Справа изображения StyleGAN, которые новая метрика определила как действительно новые. Из-за ограниченного размера иллюстраций подробности и более высокое разрешение доступны в исходном исследовании.
Новая метрика редкости не только позволяет определить «новые» генеративные результаты в единой архитектуре, но также, по утверждению исследователей, позволяет сравнивать генеративные модели различных архитектур (т.е. автоэнкодер, VAE, GAN и т. д.).
Статья отмечает, что Балл редкости отличается от прежних метрик вниманием к способности генеративной системы создавать уникальные и редкие изображения. Традиционные показатели более узко оценивают разнообразие между результатами генерации в ходе обучения модели.
За пределами ограниченных задач
Хотя исследователи провели тесты на ограниченных доменных рамках (например, генератор/набор данных, предназначенный для производства изображений людей или кошек), метрика редкости потенциально может быть применена к любой произвольной процедуре синтеза изображений, где желательно определить сгенерированные примеры, которые используют распределения, полученные из обученных данных, вместо того, чтобы увеличивать аутентичность (и снижать разнообразие) путем введения посторонних латентных распределений или использования других «обходных путей», которые компрометируют новизну в пользу аутентичности.
По сути, такая метрика потенциально могла бы различать действительно новые результаты в системах, таких как серия DALL-E, используя выявленный расстояние между кажущимся нетипичным результатом, тренировочными данными и результатами из подобных подсказок или входных данных (т.е. изображений-подсказок).
На практике, и в отсутствие четкого понимания степени, в которой система действительно ассимилировала визуальные и семантические концепции (часто препятствуемой ограниченными знаниями о тренировочных данных), это может быть жизнеспособным методом выявления настоящего «момента вдохновения» в генеративной системе – точки, в которой достаточное количество входных концепций и данных привели к чему-то действительно изобретательному, а не к чему-то чрезмерно производному или близкому к исходным данным.
* Мои конверсии встроенных цитат авторов в гиперссылки.
Опубликовано впервые 20 июня 2022 года.