
Взгляд Anderson
GAN в качестве рендерера лица для “традиционного” CGI

 Добавьте Unite.AI в избранные источники в Google

Ключевые моментыОтделение идентичности от экспрессии в латентном пространстве GAN остаётся центральной…
Показать больше
- Отделение идентичности от экспрессии в латентном пространстве GAN остаётся центральной нерешённой задачей синтеза лицевых видео.
- Параметрические CGI-модели, такие как SMPL и 3DMM, всё чаще используются для упорядочивания необузданных латентных кодов GAN.
- Гибридный подход Disney «Rendering with Style» дал неестественные результаты, объединив традиционные карты текстур с изображениями, сгенерированными GAN.
Мнение Когда генеративно-состязательные сети (GAN) впервые продемонстрировали свою способность воспроизводить потрясающе реалистичные 3D лица, это событие спровоцировало золотую лихорадку для неиспользованного потенциала GAN в создании согласованного во времени видео с человеческими лицами.
Где-то в скрытом пространстве GAN, казалось, что там должны быть скрыты порядок и рациональность – схема зарождающейся семантической логики, закопанной в скрытых кодах, которая позволила бы GAN генерировать согласованные множественные виды и множественные интерпретации (такие как изменения выражения) одного и того же лица – и, таким образом, предложить убедительный во времени метод создания видеодипфейков, который бы превзошел автоэнкодеры.
Вывод высокого разрешения был бы тривиальным по сравнению с средами низкого разрешения, в которых ограничения GPU заставляют DeepFaceLab и FaceSwap работать, а зона “смены” лица (в рабочих процессах автоэнкодеров) стала бы “зоной создания” GAN, информированной несколькими входными изображениями или даже только одним изображением.
Не будет больше несоответствия между “сменой” и “хост”-лицами, потому что весь образ будет сгенерирован с нуля, включая волосы, линии челюсти и внешние крайности лицевых черт, которые часто оказываются проблемой для “традиционных” автоэнкодерных глубоких подделок.
Зима видео лиц на основе GAN
Как оказалось, это было не так легко. В конечном итоге, разделение факторов оказался центральной проблемой и остается основной задачей. Как можно сохранить отдельную идентичность лица и изменить ее позу или выражение без сбора корпуса тысяч эталонных изображений, которые учат нейронную сеть, что происходит при этих изменениях, как это делают системы автоэнкодеров?
Было предложено, что входная идентичность может быть подвергнута телологическим, общим, шаблонным преобразованиям, которые не являются специфичными для идентичности. Примером этого может быть применение выражения к лицу GAN, которое не присутствовало в каких-либо изображениях этого человека, которые GAN знает.

Из статьи 2022 года Tensor-based Emotion Editing in the StyleGAN Latent Space, шаблонные выражения применяются к входному лицу из набора данных FFHQ. Источник: https://arxiv.org/pdf/2205.06102.pdf
Очевидно, что подход “один размер подходит всем” не может покрыть разнообразие уникальных для каждого человека лицевых выражений. Мы должны задуматься, может ли улыбка, такая уникальная, как у Джека Николсона или Виллема Дефо, когда-либо получить верную интерпретацию под влиянием таких “средних” кодов.

Кто это обаятельный латинский незнакомец? Хотя метод GAN производит более реалистичное и лицо высокого разрешения, преобразование не информируется множеством реальных изображений актера, как это делает DeepFaceLab, который долго и нередко с большими затратами обучается на базе данных тысяч таких изображений, и, следовательно, сходство компрометируется. Здесь (на заднем плане) модель DeepFaceLab импортирована в DeepFaceLive, потоковую реализацию популярного и спорного программного обеспечения. Примеры из https://www.youtube.com/watch?v=9tr35y-yQRY (2022) и https://arxiv.org/pdf/2205.06102.pdf.
Несколько редакторов лицевых выражений GAN были предложены за последние несколько лет, большинство из которых занимаются неизвестными идентичностями, где верность преобразований невозможно определить для случайного читателя, поскольку эти лица не знакомы.

Неизвестные идентичности преобразуются в предложении 2020 года Cascade-EF-GAN. Источник: https://arxiv.org/pdf/2003.05905.pdf
Возможно, редактор лиц GAN, который получил наибольший интерес (и цитаты) за последние три года, – это InterFaceGAN, который может выполнять проходы в скрытом пространстве в кодах, связанных с позой (углом камеры/лица), выражением, возрастом, расой, полом и другими важными качествами.
Возможности “морфинга” в стиле 1980-х годов InterFaceGAN и подобных рамок в основном являются способом проиллюстрировать путь к преобразованию, когда изображение проецируется обратно через подходящий скрытый код (такой как “возраст”). В плане производства видеозаписей с временной непрерывностью такие схемы до сих пор квалифицируются как “впечатляющие катастрофы”.
Если добавить к этому трудность создания согласованных во времени волос, и тот факт, что метод исследования/манипуляции скрытым кодом не имеет врожденных временных руководств для работы (и трудно знать, как ввести такие руководства в рамку, предназначенную для генерации статических изображений, и которая не имеет родной возможности для видеовыхода), можно логически заключить, что GAN не является всем, что вам нужно для лицевой видеосинтеза.
Поэтому последующие усилия привели к постепенным улучшениям в разделении факторов, в то время как другие добавили другие соглашения в области компьютерного зрения в качестве “управляющего слоя”, такие как использование семантической сегментации в качестве механизма управления в поздней статье 2021 года статье SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing.
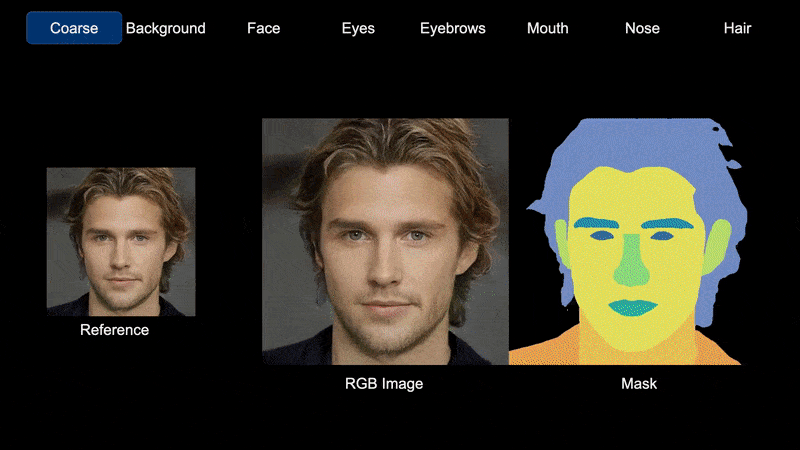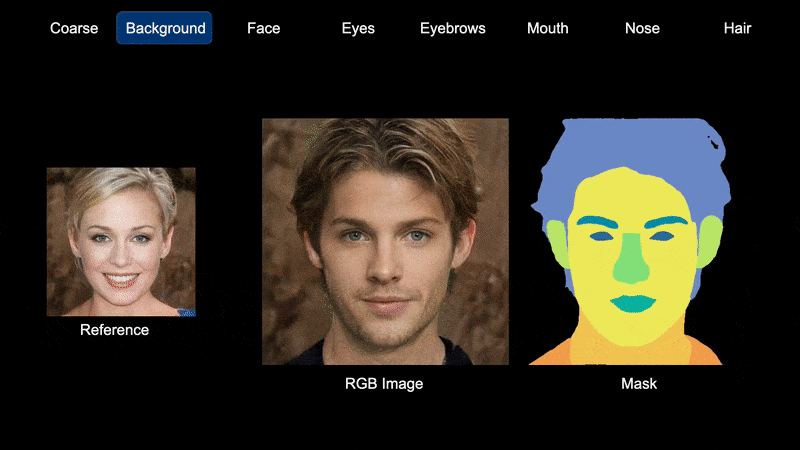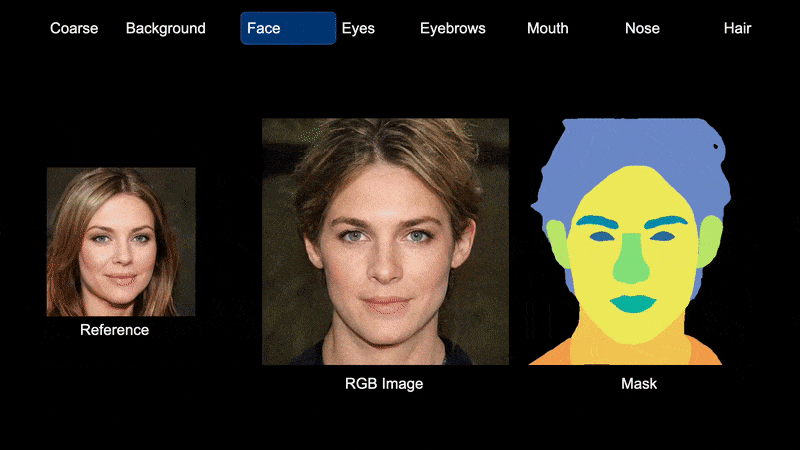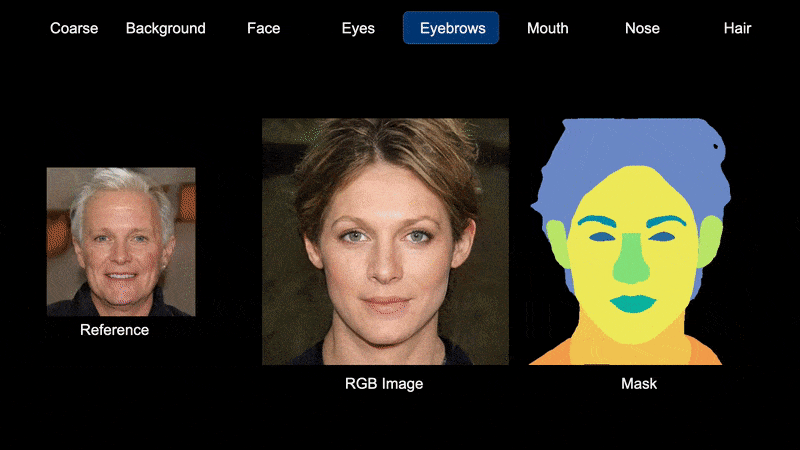
Семантическая сегментация в качестве метода управления латентным пространством в SemanticStyleGAN. Источник: https://semanticstylegan.github.io/
Параметрическое Руководство
Исследовательское сообщество GAN лицевой синтеза все больше ориентируется на использование “традиционных” параметрических CGI лиц в качестве метода руководства и введения порядка в впечатляющие, но неукрощенные скрытые коды в скрытом пространстве GAN.
Хотя параметрические лицевые примитивы были основой исследований в области компьютерного зрения более двадцати лет, интерес к этому подходу возрос в последнее время, с увеличением использования Skinned Multi-Person Linear Model (SMPL) CGI примитивов, подхода, который был открыт Институтом Макса Планка и ILM, и который был улучшен с помощью Sparse Trained Articulated Human Body Regressor (STAR) рамки.

SMPL (в данном случае вариант SMPL-X) может наложить CGI параметрическую сетку, соответствующую оцененной позе (включая выражения, если необходимо) всего человеческого тела, представленного на изображении, что позволяет выполнять новые операции над изображением с помощью параметрической сетки в качестве объемного или перцептивного ориентира. Источник: https://arxiv.org/pdf/1904.05866.pdf
Самое известное развитие в этом направлении было инициативой Disney 2019 года Rendering with Style, которая объединила использование традиционных текстурных карт с GAN-генерируемыми изображениями в попытке создать улучшенный, анимированный результат в стиле дипфейков.

Старое встречает новое в гибридном подходе Disney к GAN-генерируемым глубоким подделкам. Источник: https://www.youtube.com/watch?v=TwpLqTmvqVk
Подход Disney накладывает традиционно отрендеренные CGI элементы в сеть StyleGAN2, чтобы дорисовать человеческие лица в “проблемных” зонах, где временная согласованность является проблемой для видеогенерации – зонах, таких как текстура кожи.

Рабочий процесс Rendering with Style.
Поскольку параметрическая CGI голова, которая руководит этим процессом, может быть настроена и изменена в соответствии с потребностями пользователя, сгенерированное лицо GAN может отражать эти изменения, включая изменения положения головы и выражения.
Хотя этот подход был разработан для объединения управляемости CGI с реализмом GAN-лиц, в конечном итоге результаты демонстрируют худшее из обоих миров и все еще не могут сохранить текстуру волос и даже базовое позиционирование черт.
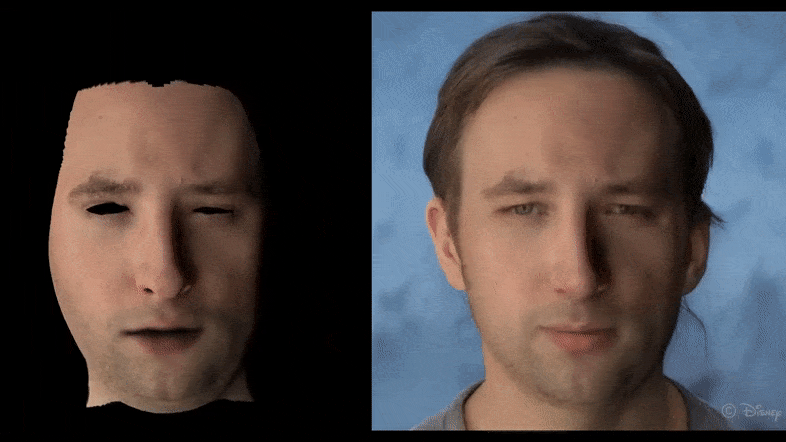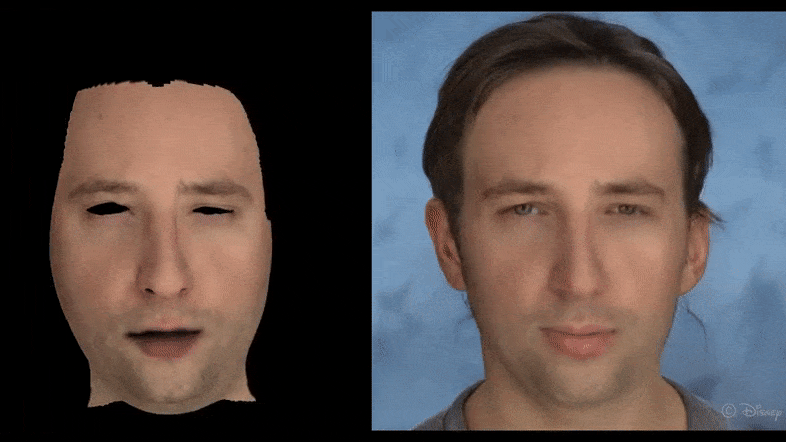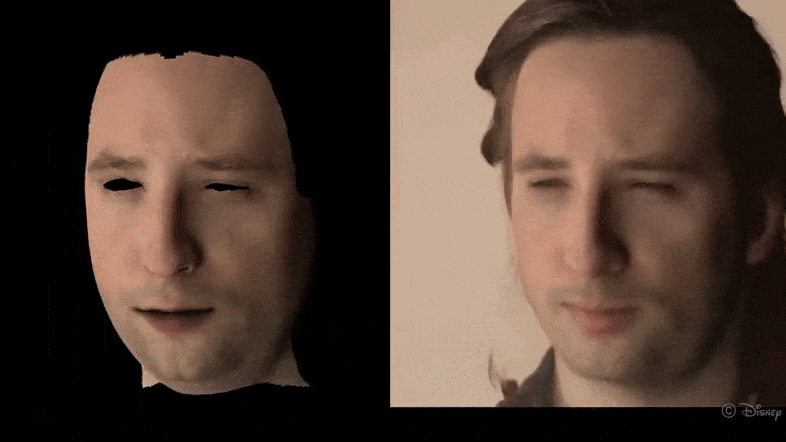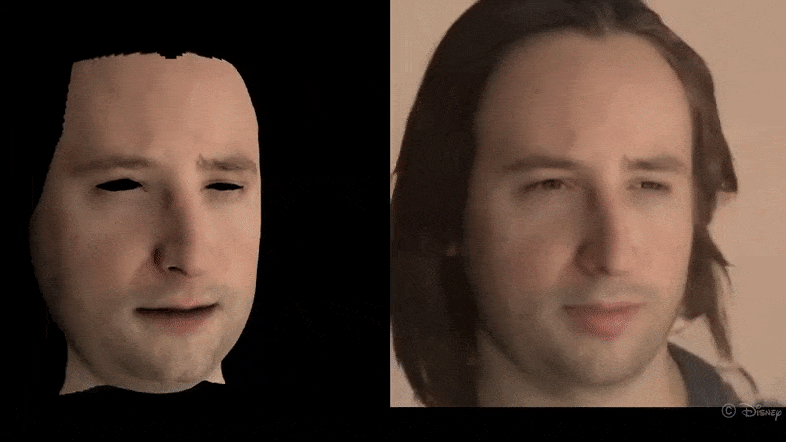
Новый вид зловещей долины возникает из Rendering with Style, хотя принцип все еще сохраняет некоторый потенциал.
Статья 2020 года статья StyleRig: Rigging StyleGAN for 3D Control over Portrait Images использует все более популярный подход, с использованием трехмерных морфабельных моделей лица (3DMM) в качестве прокси для изменения характеристик в среде StyleGAN, в данном случае через новую сеть риггинга под названием RigNet:

3DMM выступают в качестве прокси для интерпретаций скрытого пространства в StyleRig. Источник: https://arxiv.org/pdf/2004.00121.pdf
Однако, как обычно в таких инициативах, результаты на данный момент кажутся ограниченными минимальными манипуляциями с положением и “неинформированными” изменениями выражения/аффекта.

StyleRig улучшает уровень контроля, хотя согласованные во времени волосы остается нерешенной задачей. Источник: https://www.youtube.com/watch?v=eaW_P85wQ9k
Аналогичные результаты показывает разработка Mitsubishi Research MOST-GAN, статья 2021 года статья, которая использует нелинейные 3DMM в качестве архитектуры разделения факторов, но которая также борется за достижение динамического и согласованного движения.
Последняя попытка обеспечить управляемость и разделение факторов – это One-Shot Face Reenactment on Megapixels, который снова использует 3DMM параметрические головы в качестве дружественного интерфейса для StyleGAN.

В рабочем процессе MegaFR One-Shot Face Reenactment сеть выполняет синтез лиц, объединяя реальное изображение, инвертированное в латентное представление с параметрами, взятыми из отрендеренной модели 3DMM. Источник: https://arxiv.org/pdf/2205.13368.pdf
OSFR принадлежит к растущему классу редакторов лиц GAN, которые стремятся разработать линейные рабочие процессы редактирования в стиле Photoshop/After Effects, где пользователь может ввести желаемое изображение, на котором можно применить преобразования, а не искать в скрытом пространстве коды, связанные с идентичностью.
Снова параметрические выражения представляют собой общий и неличный метод введения выражения, что приводит к манипуляциям, которые кажутся зловеще неестественными в своем собственном, не всегда положительном смысле.

Введенные выражения в OSFR.
Как и предыдущая работа, OSFR может сделать вывод о почти исходных позах из одного изображения и также выполнить “фронтализацию”, где изображение с нецентральной позой переводится в паспортное фото:

Оригинальное (вверху) и выводимое паспортное изображение из одной из реализаций OSFR, описанных в новой статье.
На практике этот тип вывода аналогичен некоторым принципам фотограмметрии, которые лежат в основе нейронных полей излучения (NeRF), за исключением того, что здесь геометрия должна быть определена одним фото, а не 3-4 точками зрения, которые позволяют NeRF интерпретировать пропущенные промежуточные позы и создавать исследуемые нейронные 3D-сцены с людьми.
(Однако NeRF не является всем, что вам нужно, поскольку он несет в себе почти совершенно другой набор препятствий для GAN в плане производства лицевого видеосинтеза)
Имеет ли GAN Место в Лицевом Видеосинтезе?
Достижение динамических выражений и поз вне распределения обучающих данных из одного исходного изображения кажется алхимическим увлечением в исследованиях лицевой синтеза GAN в настоящее время, главным образом потому, что GAN – это единственный метод, который в настоящее время может выводить с довольно высоким разрешением и относительно высокой точностью нейронные лица: хотя автоэнкодерные глубокие подделки могут обучаться на множестве реальных поз и выражений, они должны работать с разрешением входа и выхода, ограниченным видеопамятью (VRAM), и требуют “хоста”; в то время как NeRF ограничен аналогичным образом и – в отличие от двух других подходов – в настоящее время не имеет установленных методов для изменения лицевых выражений и страдает от ограниченной редактируемости в целом.
Кажется, что единственный способ вперед для точной системы CGI/GAN лицевой синтеза – это найти способ собрать многофотографическую идентичность сущность внутри скрытого пространства, где код скрытого пространства для идентичности человека не должен проходить весь путь через скрытое пространство, чтобы использовать несвязанные параметры позы, но может ссылаться на свои собственные связанные (реальные) изображения в качестве ссылок для преобразований.
Даже в таком случае, или даже если вся сеть StyleGAN была обучена на наборе изображений лиц одной личности (аналогично тому, как это делают автоэнкодеры), нехватка семантической логики все еще, скорее всего, потребует быть предоставленной вспомогательными технологиями, такими как семантическая сегментация или параметрические 3DMM лица, которые, в таком сценарии, хотя бы имели бы больше материала для работы.


