
Взгляд Anderson
‘Креативная’ проверка лица с помощью генеративных противостоящих сетей

 Добавьте Unite.AI в избранные источники в Google

Новая статья Стэнфордского университета предложила зарождающийся метод обмана систем аутентификации лиц на платформах, таких как приложения для знакомств, используя Генеративную противостоящую сеть (GAN), чтобы создать альтернативные изображения лиц, содержащие ту же сущностную информацию об идентификаторе, что и настоящее лицо.
Метод успешно обошел процессы проверки лица в приложениях для знакомств Tinder и Bumble, в одном случае даже выдавая лицо, переключенное по полу (мужчина), за подлинное лицо источника (женщина).

Различные сгенерированные идентификаторы, которые включают в себя конкретную кодировку автора статьи (изображено в первом изображении выше). Источник: https://arxiv.org/pdf/2203.15068.pdf
По словам автора, работа представляет собой первую попытку обойти проверку лица с помощью сгенерированных изображений, которые были наделены конкретными чертами идентификатора, но которые пытаются представить альтернативную или существенно измененную идентификацию.
Метод был протестирован на локальной системе проверки лица и показал хорошие результаты в тестах против двух приложений для знакомств, которые выполняют проверку лица на загруженных пользователями изображениях.
Новая статья называется Обход проверки лица и написана Санжаной Сардой, исследователем в департаменте электротехники Стэнфордского университета.
Контроль пространства лица
Хотя “внедрение” идентификаторных черт (т.е. из лиц, дорожных знаков и т. д.) в созданные изображения является стандартным методом противостоящих атак, новое исследование предполагает что-то другое: что растущая способность контролировать латентное пространство GAN в конечном итоге позволит разработать архитектуры, которые могут создавать последовательные альтернативные идентификаторы для идентификатора пользователя – и, по сути, позволять извлекать черты идентификатора из изображений, доступных в Интернете, из неосведомленного пользователя, чтобы включить их в “тень” созданную идентификацию.
Последовательность и навигация были основными проблемами, связанными с латентным пространством GAN с момента его создания. GAN, который успешно ассимилировал коллекцию обучающих изображений в свое латентное пространство, не предоставляет легкой карты, чтобы “переместить” черты из одного класса в другой.
Хотя методы и инструменты, такие как Gradient-weighted Class Activation Mapping (Grad-CAM), могут помочь установить латентные направления между установленными классами и позволить преобразования (см. изображение ниже), дальнейшая проблема переплетения обычно делает это “приблизительным” путешествием, с ограниченным тонким контролем перехода.
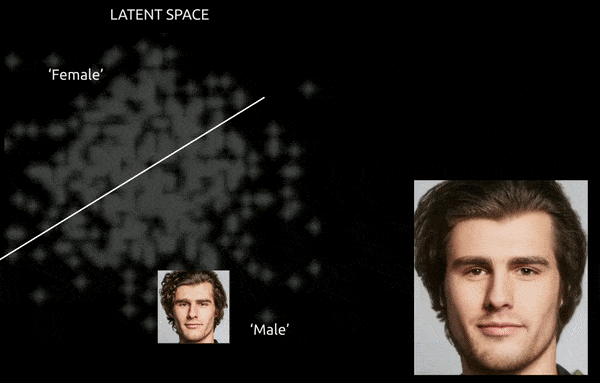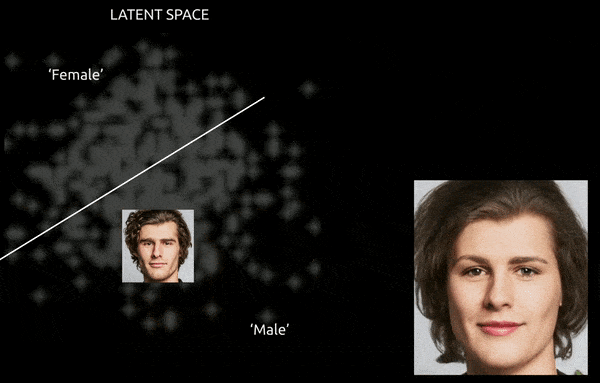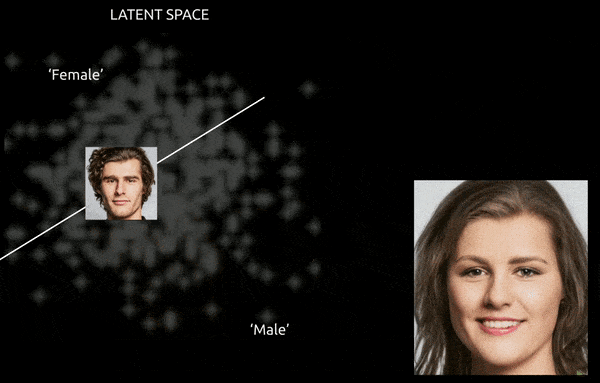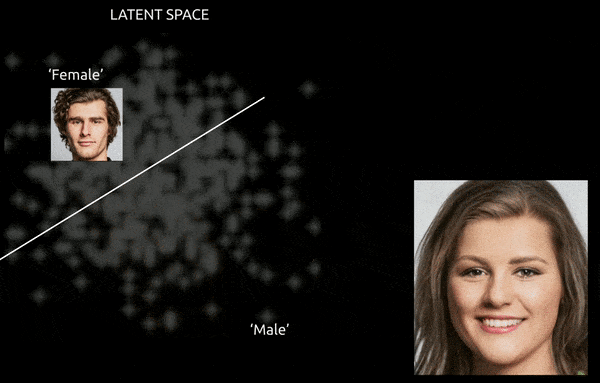
Грубое путешествие между закодированными векторами в латентном пространстве GAN, перемещающее данные, полученные из мужской идентификации, в “женские” кодировки на другой стороне одной из многих линейных гиперплоскостей в сложном и загадочном латентном пространстве. Изображение, получено из материала на https://www.youtube.com/watch?v=dCKbRCUyop8
Способность “заморозить” и защитить идентификаторные черты, перемещая их в трансформируемые кодировки в другом месте латентного пространства, потенциально позволяет создать последовательную (и даже анимированную) индивидуальность, чья идентификация читается машинными системами как кто-то другой.
Метод
Автор использовал два набора данных в качестве основы для экспериментов: набор данных человеческого пользователя, состоящий из 310 изображений ее лица, охватывающий период четырех лет, с различным освещением, возрастом и углами зрения, с обрезанными лицами, извлеченными через Caffe; и расово сбалансированные 108 501 изображения в наборе данных FairFace, аналогично извлеченные и обрезанные.
Местная модель проверки лица была получена из базовой реализации FaceNet и DeepFace, предварительно обученная на ConvNet Inception, с каждым изображением, представленным 128-мерным вектором.
Подход использует изображения лица из обучающего подмножества FairFace. Чтобы пройти проверку лица, рассчитанное расстояние, вызванное нормой Фробениуса изображения, смещается относительно целевого пользователя в базе данных. Любое изображение под порогом 0,7 эквивалентно тому же идентификатору, в противном случае проверка считается неудачной.
Модель StyleGAN была дообучена на личном наборе данных автора, производя модель, которая могла генерировать узнаваемые вариации ее идентификатора, хотя ни одно из этих сгенерированных изображений не было идентично обучающим данным. Это было достигнуто путем заморозки первых четырех слоев в дискриминаторе, чтобы избежать переобучения данных и произвести варьированное выходное значение.
Хотя разнообразные изображения были получены с базовой моделью StyleGAN, низкое разрешение и точность привели к повторной попытке с StarGAN V2, который позволяет обучать семенные изображения к целевому лицу.
Модель StarGAN V2 была предварительно обучена примерно 10 часов, используя набор данных FairFace, с размером партии четыре и размером проверки восемь. В наиболее успешном подходе личный набор данных автора был использован в качестве источника с обучающими данными в качестве справочного материала.
Эксперименты по проверке
Модель проверки лица была построена на основе подмножества из 1000 изображений, с целью проверки произвольного изображения из набора. Изображения, которые прошли проверку успешно, были затем протестированы против собственного идентификатора автора.

Слева, автор статьи, настоящая фотография; в середине, произвольное изображение, которое не прошло проверку; справа, несвязанное изображение из набора данных, которое прошло проверку как автор.
Цель экспериментов заключалась в создании как можно большего разрыва между воспринимаемой визуальной идентификацией, сохраняя при этом определяющие черты целевого идентификатора. Это было оценено с помощью расстояния Махаланобиса, метрики, используемой в обработке изображений для поиска образцов и шаблонов.
Для базовой генеративной модели низкокачественные результаты, полученные, демонстрируют ограниченное разнообразие, несмотря на то, что они проходят локальную проверку лица. StarGAN V2 оказался более способным создавать разнообразные изображения, которые могли аутентифицироваться.

Все изображения, показанные, прошли локальную проверку лица. Выше показаны низкокачественные базовые генерации StyleGAN, ниже – высококачественные генерации StarGAN V2.
Последние три изображения, показанные выше, использовали личный набор данных автора в качестве источника и справочного материала, в то время как предыдущие изображения использовали обучающие данные в качестве справочного материала и личный набор данных автора в качестве источника.
Сгенерированные изображения были протестированы против систем проверки лица приложений для знакомств Bumble и Tinder, с идентификатором автора в качестве базового, и прошли проверку. “Мужская” генерация лица автора также прошла проверку Bumble, хотя освещение в сгенерированном изображении пришлось отрегулировать перед тем, как оно было принято. Tinder не принял мужскую версию.

‘Мужские’ версии идентификатора автора (женского).
Заключение
Это семинальные эксперименты по проекции идентификатора, в контексте манипуляции латентным пространством GAN, которая остается необыкновенным вызовом в синтезе изображений и исследованиях глубоких подделок. Тем не менее, работа открывает концепцию внедрения высокоспецифических черт последовательно в различные идентификаторы и создания “альтернативных” идентификаторов, которые “читаются” как кто-то другой.
Опубликовано впервые 30 марта 2022 года.


