
Fundamentele AI
Ce este Învățarea prin Reforțare din Feedback-ul Uman (RLHF)?

 Adaugă Unite.AI la sursele tale preferate pe Google
Învățarea prin reforțare din feedback-ul uman (RLHF) este o familie de metode care utilizează judecățile umane pentru a ajuta la optimizarea unui model atunci când comportamentul dorit este dificil de specificat printr-o recompensă automată simplă. Pentru modelele de limbaj, oamenii compară în mod obișnuit răspunsuri candidate, iar un model de preferință învățat transformă aceste comparații într-un semnal de antrenament.
RLHF poate face un model pre‑antrenat să fie mai util sau să se potrivească mai bine cu o politică scrisă, dar nu garantează veridicitatea sau alinierea cu fiecare utilizator. Rezultatul depinde de cine furnizează feedback‑ul, cum sunt eșantionate prompturile, ce poate reprezenta modelul de recompensă și cum este constrânsă optimizarea.
Aspecte cheie
- RLHF urmează de obicei pre‑antrenarea și ajustarea supravegheată a instrucțiunilor.
- Preferințele pereche antrenează un model de recompensă sau de preferință; optimizarea politicii favorizează apoi ieșirile cu scoruri mai mari.
- Manipularea recompensei, dezacordul dintre analiști, schimbarea distribuției și supraoptimizarea rămân riscuri importante.
- Evaluați politica finală direct pentru calitatea sarcinii, siguranță, calibrare și efectele asupra subgrupurilor.
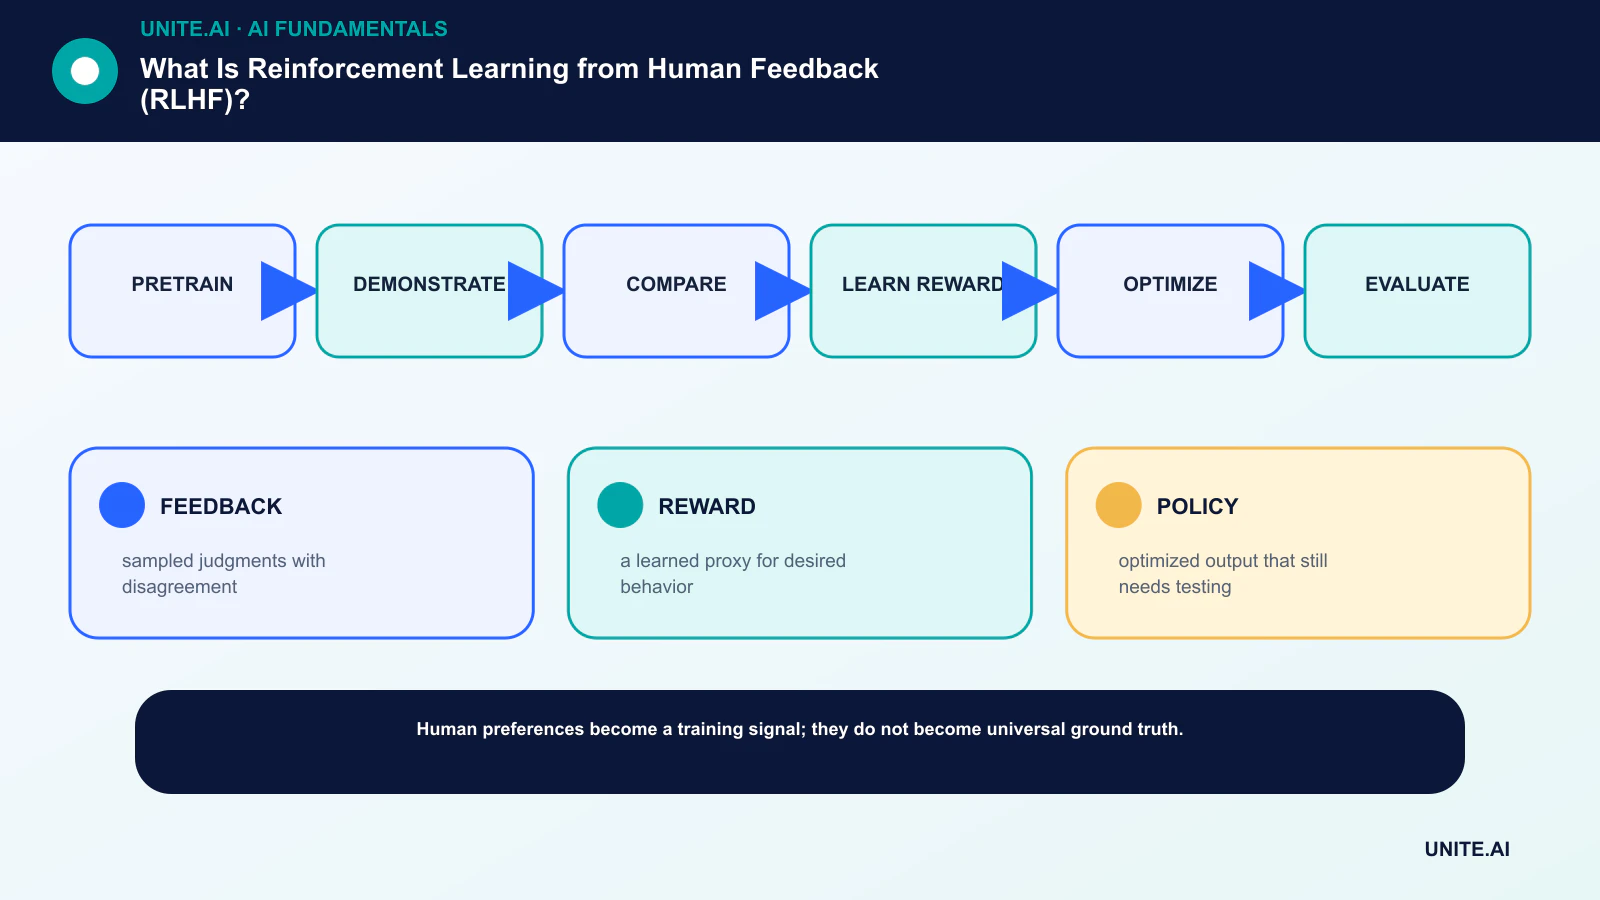
Fluxul obișnuit al RLHF
Un model de limbaj învață mai întâi o structură statistică largă prin pre‑antrenare. Ajustarea supravegheată (fine‑tuning) apoi folosește demonstrații ale răspunsurilor dorite. Pentru colectarea preferințelor, analiștii clasifică sau aleg între ieșiri pentru același prompt.
Un model de recompensă învață să prezică acele comparații. Un algoritm de învățare prin reforțare, cum ar fi PPO, poate optimiza modelul de limbaj în raport cu recompensa învățată, în timp ce o penalizare îl descurajează să se îndepărteze prea mult de politica de referință.
Feedback-ul este o măsurare, nu un adevăr de bază
Analiștii pot dezacorda deoarece instrucțiunile sunt ambigue, expertiza diferă sau valorile intră în conflict real. Poziția, verbositatea, încrederea și stilul pot influența preferințele. Un program de înaltă calitate instruiește evaluatorii, măsoară acordul, auditează exemplele și păstrează incertitudinea.
Eșantionarea este, de asemenea, importantă. Dacă setul de preferințe exclude limbi dificile, domenii sau conținut nociv, modelul de recompensă nu poate supraveghea în mod fiabil aceste aspecte. Disciplina de data‑science este la fel de importantă ca optimizerul.
Moduri de eșec
Politica poate exploata slăbiciunile recompensei învățate, generând ieșiri care obțin scoruri mari fără a satisface intenția de bază. Optimizarea excesivă poate reduce diversitatea, amplifica un stil preferat sau poate face modelul să răspundă în mod încrezător și agreabil.
Modelul de recompensă în sine poate eșua în afara distribuției de antrenament. Echipele ar trebui să testeze prompturi adversariale, sarcini factuale, limite de refuz, calibrare și comportament la diferite intensități de optimizare, în loc să se bazeze pe o singură rată agregată de succes a preferințelor.
Alternative și complementare
Optimizarea Directă a Preferințelor învață din perechi de preferințe fără a ajusta o politică separată printr-un ciclu online de învățare prin reforțare. Eșantionarea prin respingere, ajustarea supravegheată a preferințelor, feedback‑ul bazat pe reguli și supravegherea procesului oferă alte compromisuri.
Nicio metodă nu elimină necesitatea controalelor la nivel de prompt, recuperare, instrument și aplicație. Post‑antrenarea modelează comportamentul; sistemele implementate necesită în continuare dovezi fundamentate, permisiuni, monitorizare și escaladare umană.
Cum sunt antrenate modelele de preferință
Pentru un prompt x și două răspunsuri y₁ și y₂, un model de preferință atribuie scoruri scalare și este antrenat astfel încât răspunsul preferat să primească scorul mai mare. O funcție de pierdere comună se bazează pe probabilitatea ca un scor să depășească celălalt. Aceasta convertește numeroase judecăți pereche într-o funcție care poate evalua ieșirile generate nou.
Modelul învață orice semnal care prezice alegerile colectate. Dacă evaluatorii preferă proză încrezătoare, răspunsuri mai lungi, norme culturale specifice sau puncte de vedere familiare, aceste corelații pot deveni caracteristici ale recompensei. Instrucțiuni echilibrate, contraexemple, revizuiri de experți și audituri pentru preferințe superficiale reduc, dar nu elimină problema.
Datele de preferință pot include egalități, clasificări, critici, etichete scalare sau demonstrații. Selecția perechilor contează: comparațiile dintre răspunsuri evident diferite oferă puține informații despre granițele subtile de calitate, în timp ce doar perechile dificile pot destabiliza antrenamentul. Eșantionarea activă poate viza dezacorduri informative, dar poate modifica distribuția datelor.
Optimizarea politicii și regularizarea
RLHF bazat pe PPO eșantionează răspunsuri din politica curentă, le evaluează cu modelul de recompensă și actualizează politica pentru a crește recompensa așteptată. O penalizare Kullback–Leibler sau o constrângere similară menține politica aproape de referința supravegheată, limitând devierea distructivă și descurajând exploatarea slăbiciunilor înguste ale modelului de recompensă.
Intensitatea optimizării este o alegere de produs. Prea puțină nu modifică comportamentul dorit; prea multă poate genera manipularea recompensei, fraze repetitive, lăcomie de aprobare sau diversitate redusă. Se recomandă să se urmărească metricile de calitate și siguranță în raport cu recompensa și divergența pe parcursul antrenamentului, în loc să se aleagă un punct de control doar pe baza recompensei.
Metodele de preferință directă derivă un obiectiv din perechi de preferințe și un model de referință fără un ciclu online de RL explicit. Pot simplifica antrenamentul, dar moștenesc totuși calitatea preferințelor, acoperirea și presupunerile politicii de referință. Feedback‑ul constituțional sau generat de AI schimbă cine furnizează etichetele; nu elimină necesitatea de a valida valorile și eșecurile cu oamenii.
Evaluare și guvernanța datelor
Utilizați comparații orbilate, teste specifice sarcinilor, prompturi adversariale, verificări de factualitate, precizia și recall‑ul refuzului și revizuiri pe subgrupuri. Separați evaluatorii de datele de antrenament, acolo unde este posibil. O rată de succes în fața unui model mai vechi poate ascunde eșecuri absolute atunci când ambele candidați sunt slabi.
Documentați recrutarea evaluatorilor, compensarea, expertiza, geografia, limba, instrucțiunile, expunerea la conținut nociv, dezacordurile, soluționarea și controalele de calitate. Munca de colectare a feedback‑ului poate implica riscuri psihologice, iar operațiunile de date responsabile includ sprijin pentru lucrători și dreptul de a refuza sarcini tulburătoare.
După implementare, monitorizați devierea preferințelor și supra‑generalizarea. O politică ajustată pentru asistență casuală poate avea un comportament inadecvat în contexte medicale sau juridice. Păstrați limitele domeniilor, recuperarea, permisiunile și escaladarea în afara presupunerii RLHF și reantrenați doar când dovezile noi justifică schimbarea.
Un flux concret de antrenament și evaluare RLHF
Un proiect tipic începe cu un model de limbaj pre‑antrenat și un set de date de instrucțiuni utilizat pentru ajustarea supravegheată. Analiștii compară apoi răspunsurile candidate sub o rubrică scrisă ce acoperă corectitudinea, relevanța, stilul, siguranța și incertitudinea. Preferințele pereche antrenează un model de recompensă sau optimizează direct politica. Eșantionarea trebuie să includă sarcini obișnuite, cazuri de margine dificile, prompturi adversariale, multiple limbi și zone în care analiștii au dezacorduri legitime.
Precizia modelului de recompensă pe comparații reținute este necesară, dar nu suficientă. Politica optimizată poate exploata erori în recompensa învățată, poate deveni excesiv de verbosă, poate refuza cereri inofensive sau poate pierde capabilități. Urmăriți benchmark‑urile de sarcină, preferințele umane, calibrarea, siguranța, diversitatea și divergența față de modelul de referință pe parcursul antrenamentului. Colectați periodic comparații noi din politica în schimbare, astfel încât datele de preferință să acopere ieșirile pe care modelul le produce efectiv.
Documentați cine a furnizat preferințele, instrucțiunile lor, compensarea, dezacordurile, controalele de calitate și limitele culturale sau de domeniu. Utilizați recenzori experți acolo unde greșelile pot provoca pagube specializate. Formați echipe de tip red‑team atât pentru modelul de recompensă, cât și pentru politica finală, mențineți teste de regresie comportamentală și implementați treptat lansarea. RLHF modelează comportamentul conform preferințelor măsurate; nu demonstrează veridicitatea, nu elimină părtinirile și nu rezolvă problema mai largă de a specifica ce ar trebui să facă un model în fiecare context.
Listă de verificare pentru implementare practică
Transformați conceptul într-un flux de lucru delimitat și testabil: pre‑antrenare → demonstrare → comparare → învățare recompensă → optimizare → evaluare. Stabiliți un responsabil alocat, documentați datele și dependențele, creați o bază simplă, definiți criterii de acceptare și oprire, testați eșecuri reprezentative și stabiliți monitorizare, rollback și revizuire înainte de a extinde domeniul. Înregistrați versiunile și ipotezele astfel încât o altă echipă să poată reproduce rezultatul și să înțeleagă ce s‑a schimbat.
Înainte de lansare, efectuați o revizie de pregătire documentată împreună cu persoanele care construiesc, operează, securizează și sunt afectate de sistem. Testați cazuri normale, condiții de margine, eșecuri de dependență și utilizări abuzive; păstrați dovezile și riscurile nerezolvate. Definiți cine poate aproba lansarea, modifica un prag, suprascrie un rezultat sau opri funcționarea. Reexaminați decizia odată ce sosesc datele din viața reală, deoarece un pilot tehnic de succes nu garantează o performanță fiabilă la scară largă.
- FEEDBACK: judecăți eșantionate cu dezacord.
- REWARD: un proxy învățat pentru comportamentul dorit.
- POLICY: ieșire optimizată care încă necesită testare.
Întrebări frecvente
Este RLHF același lucru cu ajustarea fină?
RLHF este o formă de post‑antrenare care utilizează recompense derivate din preferințe. Ajustarea fină supravegheată antrenează direct pe ieșirile țintă; multe fluxuri de lucru folosesc ambele.
RLHF un model să fie veridic?
Poate îmbunătăţi comportamentul măsurat prin procesul de feedback, dar un model poate fi în continuare greșit, convingător sau poate exploata strategic recompensa. Veridicitatea necesită evaluare directă și fundamentare.
Referințe principale












