
Fundamentele AI
Ce sunt operațiunile IT (ITOps)?

 Adaugă Unite.AI la sursele tale preferate pe Google
Operațiunile IT (ITOps) reprezintă activitatea de rulare a serviciilor tehnologice de care depinde o organizație. Acoperă calcul, rețele, identitate, puncte finale, platforme cloud, baze de date, stocare, backupuri și procesele operaționale care mențin aceste componente disponibile, securizate și susțenabile.
Operațiunile ITOps moderne nu se limitează la un centru de operațiuni de rețea care monitorizează tablouri de bord. Echipele gestionează din ce în ce mai mult infrastructura definită prin software, serviciile de platformă, automatizarea și proprietatea distribuită, menținând totodată responsabilitatea pentru incidente, capacitate, continuitate și niveluri de serviciu.
Aspecte cheie
- ITOps gestionează serviciile și dependențele acestora în mediile on‑premises, cloud și edge.
- Observabilitatea, configurarea și inventarul furnizează contextul necesar pentru a interpreta defecțiunile.
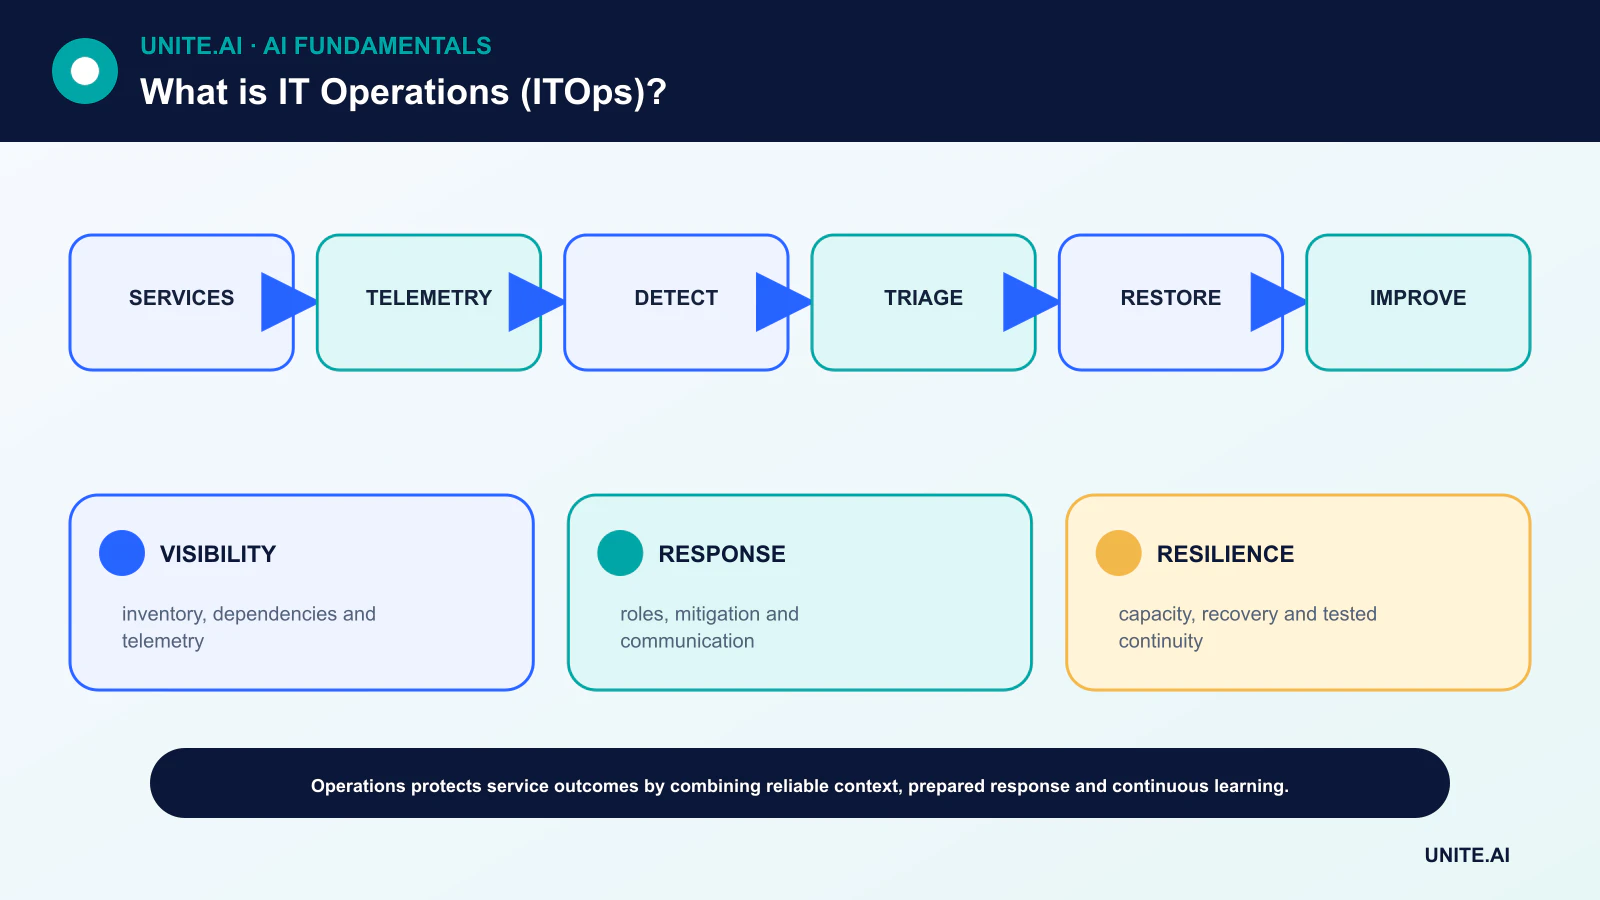
- Managementul incidentelor restaurează serviciul; managementul problemelor abordează cauzele recurente sau sistemice.
- ITOps se suprapune cu ITSM, SRE, DevOps, SecOps și AIOps, dar nu este identic cu niciunul dintre ele.
Servicii, active și configurare
Operațiunile încep prin a cunoaște ce servicii există, cine le deține, de ce utilizatori depind și ce infrastructură le susține. Inventarul activelor înregistrează componentele; managementul configurației înregistrează relațiile relevante și starea controlată.
Un inventar care nu este niciodată reconciliat devine înșelător. Automatizați descoperirea acolo unde este utilă, identificați sursele autoritare și înregistrați gradul de încredere sau prospețimea în loc să pretindeți că fiecare hartă a dependențelor este completă.
Observabilitate și obiective de serviciu
Metricele cuantifică comportamentul, jurnalele înregistrează evenimente și trasările urmăresc fluxul de lucru între servicii. Verificările sintetice pot testa un parcurs al utilizatorului. O observabilitate utilă începe cu întrebări și obiective de serviciu, apoi colectează semnalele necesare pentru a le răspunde.
Alertele ar trebui să identifice condițiile ce necesită acțiune în timp util. Pragurile fără impact asupra utilizatorului generează zgomot, în timp ce lipsa contextului de dependență încetinește diagnosticarea. AIOps poate ajuta la corelare, dar are nevoie de telemetrie de încredere și feedback operațional.
Managementul incidentelor, problemelor și schimbărilor
Managementul incidentelor coordonează detectarea, trierea, atenuarea, comunicarea și recuperarea. Rolurile clare reduc confuzia sub presiune. O soluție temporară poate restaura serviciul în timp ce o investigație ulterioară a problemei abordează cauzele profunde.
Managementul schimbărilor evaluează și înregistrează riscul fără a transforma fiecare schimbare într-o coadă. Schimbările standard, automate și cu risc scăzut pot urma căi preaprobate; schimbările cu impact mare necesită dovezi mai puternice, programare și pregătire pentru revenire.
Capacitate, reziliență și continuitate
Echipele prognozează cererea de resurse, elimină blocajele și testează comportamentul sub sarcină. Backupurile sunt utile numai când restaurarea este testată. Redundanța ajută doar când modurile de eșec sunt independente și failover‑ul funcționează efectiv.
Continuitatea afacerii definește prioritățile, timpul de recuperare și pierderea de date acceptabilă. Dependențele de identitate, DNS, planurile de control cloud și furnizori ar trebui incluse în exerciții, nu presupuse ca fiind disponibile.
ITOps, ITSM, SRE și DevOps
Managementul serviciilor IT furnizează procese pentru alinierea serviciilor la nevoile organizaționale. Ingineria fiabilității site‑ului aplică ingineria software în operațiuni și folosește obiective de nivel de serviciu și bugete de eroare. DevOps unește feedbackul dintre dezvoltare și operațiuni.
SecOps se concentrează pe amenințări și răspuns, în timp ce ITOps menține sănătatea generală a serviciilor. Diagramele organizaționale diferă; cerința importantă este deținerea explicită și dovezile partajate între aceste discipline.
Modelul operațional al ITOps
Operațiunile IT mențin serviciile tehnologice ale organizației disponibile, performante, securizate și recuperabile. Domeniul cuprinde în mod obișnuit puncte finale, identitate, rețele, servere, cloud, stocare, colaborare, baze de date, monitorizare, birou de asistență, backup și servicii ale furnizorilor. ITOps modern acoperă infrastructura deținută și platformele gestionate, așa că responsabilitatea trebuie să fie explicită chiar și când operațiunea este externalizată. Un inventar de configurare sau de servicii leagă componentele tehnice de proprietari, utilizatori, dependențe, clasificarea datelor și criticitatea pentru afacere.
Managementul serviciilor organizează incidente, cereri, probleme, schimbări, active, cunoștințe și niveluri de serviciu. Managementul incidentelor restaurează serviciul; managementul problemelor investighează cauzele recurente; facilitarea schimbărilor evaluează și coordonează riscul. Tratarea fiecărei schimbări ca pe o aprobare lentă creează ocolișuri, în timp ce automatizarea nereglementată generează eșecuri necontrolate. Schimbările standard cu risc scăzut pot fi preautorizate și automatizate; schimbările cu risc ridicat necesită dovezi, comunicare, revenire și programare pe baza impactului.
Fiabilitate, capacitate și continuitate
Monitorizarea ar trebui să urmărească serviciile orientate către utilizator și dependențele acestora, nu doar numărul de dispozitive. Definiți disponibilitatea, latența, capacitatea, prospețimea și obiectivele de suport împreună cu proprietarii de business. Alertați pe simptome acționabile și consumul bugetului de eroare; îmbogățiți evenimentele cu informații despre deținere și modificări recente. Modelele de planificare a capacității includ cererea, saturația, licențele și timpul de livrare. Elasticitatea cloud reduce întârzierea de aprovizionare, dar nu elimină cotele, limitele regionale sau controlul costurilor.
Continuitatea afacerii necesită backupuri testate, restaurare, recuperare a identității, alternative de rețea, contacte ale furnizorilor și proceduri manuale. Definiți obiectivele de timp de recuperare și punct de recuperare pentru fiecare serviciu. Un backup nu este dovadă de recuperare până nu este restaurat și validat. Repetă scenarii de ransomware, pierdere de regiune, certificate expirate, întrerupere a identității și eșec de furnizor. Urmăriți configurarea și infrastructura ca cod, acolo unde este posibil, pentru ca recuperarea să fie reproductibilă.
Securitate, automatizare și metrici
Utilizați principiul celui mai mic privilegiu, gestionarea patch‑urilor și vulnerabilităților, controale la punctele finale, segmentarea rețelei, jurnalizarea și răspunsul la incidente. Automatizați munca repetitivă cu idempotentă, limite, aprobări și audit. Măsurați disponibilitatea serviciului, recurența incidentelor, îndeplinirea cererilor, eșecul schimbărilor, recuperarea, expunerea la patch‑uri, capacitatea, costul și satisfacția utilizatorilor — nu doar închiderea tichetelor. ITOps are succes când tehnologia susține munca în mod previzibil și poate recupera din eșec, nu când infrastructura pare ocupată sau tablourile de bord afișează prea multe indicatori verzi.
Exemplu practic: recuperarea unui serviciu de colaborare
O companie definește un obiectiv de timp de recuperare de patru ore și un obiectiv de punct de recuperare de o oră pentru o platformă de colaborare. Inventarizează identitatea, DNS‑ul, rețeaua, datele, cheile, configurarea, integrările și dependențele de furnizori. Un exercițiu de recuperare presupune că regiunea principală și contul de administrator nu sunt disponibile. Operatorii activează o identitate de urgență protejată independent, restaurează configurarea și datele serviciului într-o regiune izolată și validează permisiunile, mesajele, integrările și accesul clienților. Proprietarii de business verifică serviciul restaurat prin parcursuri realiste ale utilizatorilor, în loc să se bazeze doar pe verificări de sănătate a infrastructurii.
Exercițiul înregistrează pierderea reală de date, timpul scurs, pașii manuali, contactele eșuate și dependențele ascunse. Un backup care restaurează fișierele, dar nu și cheile de criptare sau politica de identitate este marcat ca incomplet. Acțiunile corective primesc proprietari și date, iar manualul operațional este actualizat și retestat. Șabloanele de monitorizare și comunicare sunt incluse. Organizația măsoară dovezile de recuperare în loc de succesul job‑ului de backup, recunoscând că ITOps fiabil trebuie să restabilească serviciul de care utilizatorii au nevoie în condiții de eșec realiste.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație reușită. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o linie de bază reproductibilă și un set de evaluare versionat înainte de ajustări. Testați cazuri obișnuite, condiții de frontieră, intrări malformate sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizări incorecte și grupurile sau mediile cel mai probabil subservite. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, alocați autoritatea pentru eliberare, excepții, schimbări, revenire și retragere. Folosiți o lansare etapizată, păstrați o revenire sigură și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți pragurile de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și retenție, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Care este obiectivul principal al ITOps?
De a furniza și restaura servicii tehnologice de încredere în cadrul constrângerilor agreate de securitate, performanță, continuitate și cost.
Este infrastructura cloud operată în totalitate de furnizorul de cloud?
Nu. Furnizorii operează părți ale platformei de bază, în timp ce clienții rămân responsabili pentru configurare, identitate, date, sarcini de lucru, monitorizare și multe decizii la nivel de serviciu.
Referințe principale












