
Fundamentele AI
Ce este automatizarea incidentelor? Fluxuri de lucru, bariere de protecție și cazuri de utilizare

 Adaugă Unite.AI la sursele tale preferate pe Google
Automatizarea incidentelor folosește software pentru a detecta, îmbogăți, direcționa, coordona și, uneori, remedia incidente operaționale sau de securitate. Aceasta leagă semnalele de monitorizare de runbook-uri, sisteme de ticketing, comunicare, controale de acces și acțiuni de recuperare, astfel încât respondenții să petreacă mai puțin timp copierea datelor și mai mult timp luând decizii.
Automatizarea nu reprezintă eliminarea responsabilității umane. Un program sigur diferențiază pașii deterministici cu risc scăzut de acțiunile care pot afecta clienții sau producția, aplicând apoi aprobări, acreditări limitate, jurnale de audit, timeout-uri și reveniri în funcție de impact.
Aspecte cheie
- Automatizați colectarea repetabilă a dovezilor înainte de a încerca remedierea autonomă.
- Folosiți severitatea, încrederea, raza de impact și reversibilitatea pentru a selecta nivelul de aprobare.
- Tratați fiecare runbook ca pe un cod de producție versionat, cu teste și un proprietar.
- Măsurați detectarea, recunoașterea, recuperarea, recurența și impactul asupra utilizatorilor — nu doar volumul de alerte.
De la semnal la răspuns coordonat
Un flux de lucru poate deduplica alertele, atașa implementările și jurnalele recente, identifica proprietarul serviciului, deschide o înregistrare de incident, alerta echipa de gardă, crea un canal de comunicare și porni o cronologie. Acești pași reduc sarcina cognitivă fără a face automat un diagnostic riscant.
Corelarea trebuie să păstreze dovezile. Dacă o platformă grupează simptomele prea agresiv, poate ascunde incidente concurente. Conectați automatizarea la proprietatea operațiunilor IT și păstrați semnalele brute de care respondenții ar putea avea nevoie.
Alegeți acțiunile în funcție de risc
Interogările în mod read-only, instantaneele și redirecționările de trafic reversibile sunt, în general, mai ușor de automatizat decât ștergerea datelor, rotirea acreditărilor largi sau modificarea unei scheme de producție. Definiți precondiții, un timeout de execuție, postcondiții și o revenire pentru fiecare acțiune.
Utilizați identități de serviciu cu privilegiu minim și separați autorizarea de motorul de flux de lucru. Pașii cu impact ridicat ar trebui să solicite un aprobator identificat. Dacă AIOps propune o cauză sau o soluție, respondenții au în continuare nevoie de dovezi de susținere și de o modalitate sigură de a respinge propunerea.
Construiți runbook-uri fiabile
Un runbook ar trebui să declare intrările, dependențele, proprietarul, domeniul, comportamentul în caz de eșec și dovezile generate. Testați-l în mediu de testare și în timpul zilelor de simulare. Pașii idempotenți sunt valoroși deoarece reîncercarea lor nu creează daune suplimentare.
Versionați și revizuiți automatizarea ca pe orice alt software. Monitorizați expirarea acreditărilor, modificările API-ului, limitele de rată, execuțiile parțiale și legăturile ascunse dintre servicii. Procedurile manuale rămân necesare când platforma de automatizare în sine nu este disponibilă.
Învățați după recuperare
Automatizarea ar trebui să păstreze o înregistrare cu marcă temporală a semnalelor, deciziilor, acțiunilor, aprobărilor și rezultatelor. O revizuire fără vinovăție poate apoi să separe condițiile de sistem contributive de declanșatorul final și să transforme lecțiile în îmbunătățiri testate.
Măsurile utile includ timpul mediu de recunoaștere și restaurare, procentajul de pași siguri automatizați, rata acțiunilor eșuate, incidentele recurente și impactul asupra clienților. Conectați concluziile la planificarea DevOps în loc să optimizați pentru numărul de tichete închise.
Tipuri de automatizare a incidentelor
Automatizarea evenimentelor normalizează și îmbogățește semnalele primite. Automatizarea coordonării creează o înregistrare de incident, alertează proprietarii, deschide canale de comunicare și publică actualizări de stare. Automatizarea diagnostică rulează interogări în mod read-only sau capturează instantanee. Automatizarea remedierii modifică starea sistemului, în timp ce automatizarea recuperării verifică sănătatea serviciului și închide măsurile de atenuare temporare.
Aceste categorii nu ar trebui să împărtășească același nivel de încredere implicit. Îmbogățirea poate rula adesea automat; un failover în producție poate necesita verificări de încredere și un aprobator; restaurarea datelor necesită de obicei un comandant de incident și proprietarul aplicației. Controlul ar trebui să se bazeze pe impactul potențial, nu pe faptul că pasul este implementat printr-o regulă sau un model de învățare automată.
Incidentele de securitate adaugă cerințe de păstrare a dovezilor. Automatizarea trebuie să evite modificarea unui host compromis înainte ca datele volatile să fie capturate, expunerea indicatorilor sensibili în canale publice sau carantina infrastructurii partajate fără a înțelege raza de impact. Runbook-urile operaționale și cele forensice pot să se suprapună, dar ordinea lor poate diferi.
Proiectarea fluxului de lucru și planul de control
Modelați runbook-ul ca stări explicite cu precondiții și rezultate finale. Fiecare acțiune ar trebui să raporteze început, succes, eșec, timeout sau omitere, împreună cu un identificator de execuție imuabil. Un orchestrator central poate coordona pașii, dar serviciile din aval ar trebui să-și impună propria autorizare și să valideze intrările independent.
Utilizați acreditări limitate și pe termen scurt și restricționați căile de rețea ale motorului de automatizare. Separați runner-ele de dezvoltare, testare și producție. Secretele nu trebuie să apară în transcrierile de chat sau în jurnale. Pentru acțiuni cu impact ridicat, solicitați aprobarea a două persoane sau un rol de tip break‑glass, al cărui utilizare creează un traseu de revizuire imediat.
Proiectați pentru eșec parțial. Un tichet poate fi creat în timp ce alertarea eșuează; o redirecționare de trafic poate reuși într-o regiune și să aibă timeout în alta. Acțiunile compensatorii, sarcinile de reconciliere și proprietatea clară împiedică fluxul de lucru să raporteze succes doar pentru că procesul de orchestrare s-a încheiat.
Exemple, testare și maturitate
Un caz de utilizare matur este epuizarea conexiunilor la baza de date: colectați metricile pool-ului, implementările recente, interogările lente și informațiile despre proprietar; deschideți un incident; propuneți o scalare sau o acțiune de trafic reversibilă; solicitați aprobare; apoi verificați rata de eroare și latența. Același model poate servi pentru expirarea certificatelor, presiunea pe disc, joburi eșuate sau activitate suspectă a conturilor.
Testați runbook-urile prin teste unitare, API-uri simulate, incidente în mediu de testare, zile de simulare și exerciții controlate în producție. Injectați date învechite, refuzuri de permisiune, dependențe lente, evenimente duplicate și incidente conflictuale. Confirmați că reîncercările sunt sigure și că respondenții pot prelua controlul manual fără a lupta împotriva automatizării.
Maturitatea progresează de la notificare, la îmbogățire, la acțiuni ghidate, la auto‑remediere delimitată. Avansarea ar trebui să depindă de dovezi: diagnostic stabil, rate scăzute de acțiuni eșuate, rollback verificat și beneficii clare pentru utilizator. Închiderea autonomă ar trebui să fie rară până când sistemul poate demonstra recuperarea și să păstreze suficiente dovezi pentru învățarea ulterioară.
Exemplu practic: automatizarea unui incident al unui serviciu de producție
Luați în considerare un API de plată al cărui nivel de eroare crește după o implementare. Monitorizarea emite o alertă structurată care conține serviciul, mediul, regiunea, versiunea, bugetul de eroare și linkul către runbook. Automatizarea o îmbogățește cu înregistrarea modificării, sănătatea dependențelor, jurnalele recente și informațiile de proprietate, apoi grupează alertele duplicate într-un singur incident. O politică deterministă poate opri imediat rularea ulterioară; un rollback ar trebui să solicite dovezi că versiunea nouă este cauzală și că rollback-ul este sigur.
Fluxul de lucru desemnează un comandant de incident, deschide canale de comunicare, înregistrează o cronologie și sugerează pași de diagnosticare. Remedierea automată începe cu acțiuni reversibile cu risc scăzut, cum ar fi redirecționarea traficului către o instanță sănătoasă. Fiecare acțiune necesită autorizare, limite de concurență, un timeout, postcondiții verificate și rollback. Rezumatele generative pot ajuta respondenții, dar telemetria și comenzile sursă rămân vizibile pentru ca echipa să poată contesta o narațiune incorectă.
Măsurați timpul de detectare, recunoaștere, atenuare și recuperare; volumul de alerte; suprimarea duplicatelor; succesul remedierii; recurența; și daunele cauzate de automatizare. Organizați zile de simulare pentru acreditări expirate, regiuni parțiale, alerte înșelătoare și rollback-uri eșuate. După recuperare, păstrați cronologia factuală, identificați condițiile tehnice și organizaționale contributive, actualizați runbook-urile și testele și urmăriți lucrările corective până la finalizare, în loc să tratați o atenuare rapidă ca sfârșitul efortului de fiabilitate.
Listă de verificare pentru implementare practică
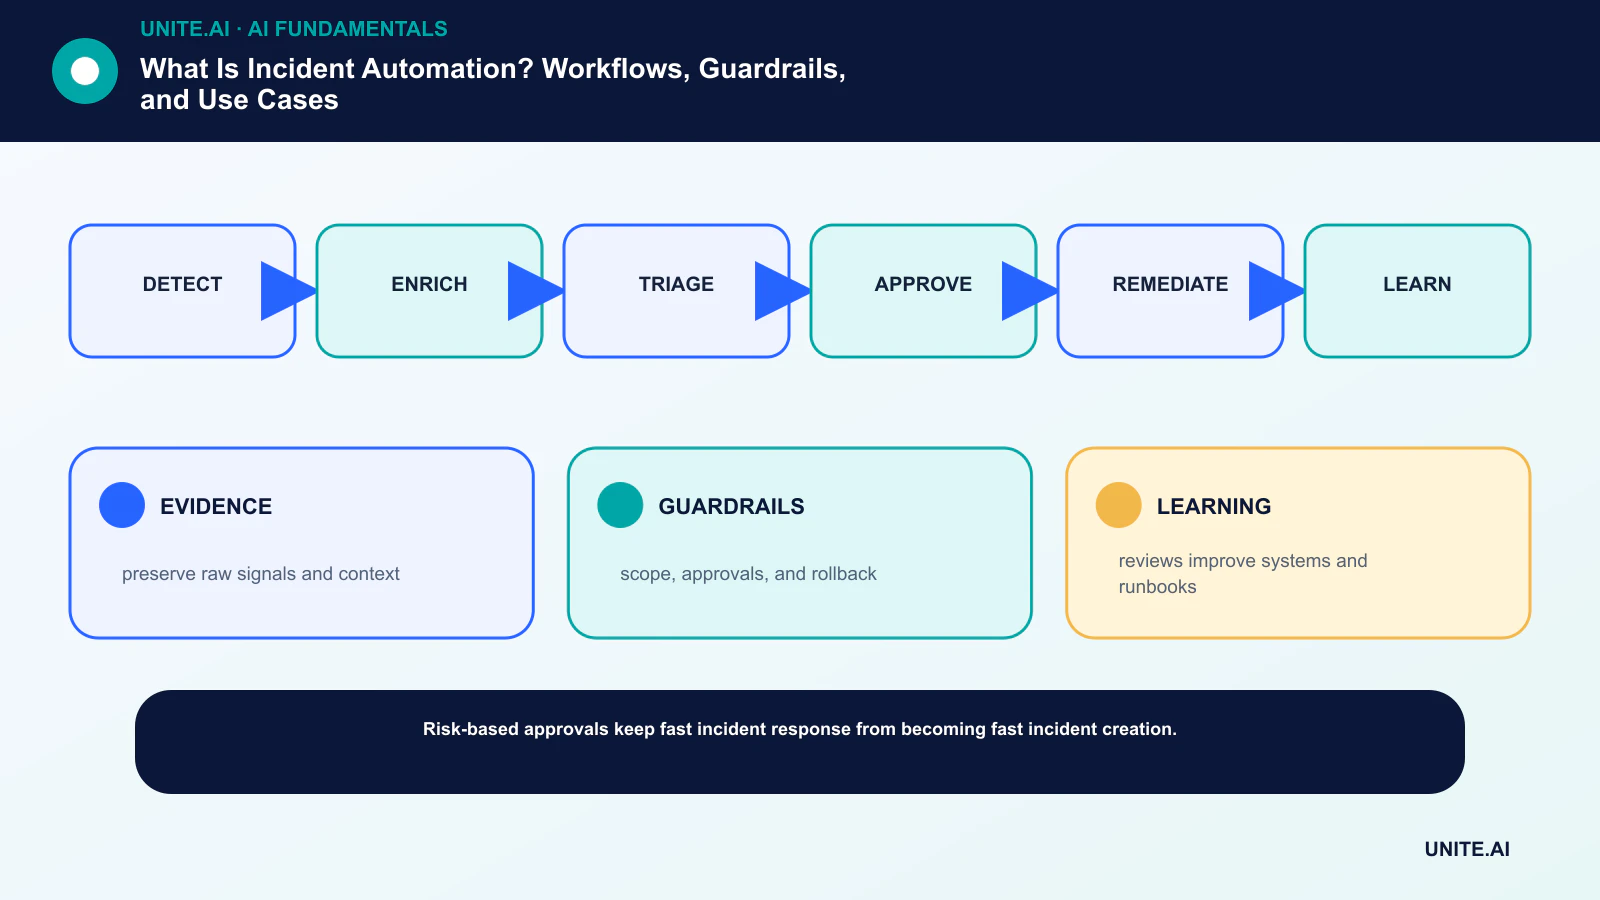
Transformați conceptul într-un flux de lucru delimitat și testabil: detectare → îmbogățire → triere → aprobare → remediere → învățare. Numiți un proprietar responsabil, documentați datele și dependențele, stabiliți o linie de bază simplă, definiți criterii de acceptare și oprire, testați eșecuri reprezentative și definiți monitorizarea, rollback-ul și revizuirea înainte de a extinde domeniul. Înregistrați versiunile și ipotezele pentru ca o altă echipă să poată reproduce rezultatul și să înțeleagă ce s‑a modificat.
Înainte de lansare, efectuați o revizuire documentată a pregătirii împreună cu persoanele care construiesc, operează, securizează și sunt afectate de sistem. Testați cazuri normale, condiții limită, eșecuri de dependență și utilizări incorecte; păstrați dovezile și riscurile nerezolvate. Definiți cine poate aproba lansarea, modifica un prag, suprascrie un rezultat sau opri funcționarea. Reexaminați decizia după ce sosesc date din lumea reală, deoarece un pilot tehnic de succes nu garantează performanță fiabilă la scară mai largă.
- EVIDENȚĂ: păstrați semnalele brute și contextul.
- MĂSURI DE PROTECȚIE: domeniu, aprobări și rollback.
- ÎNVĂȚARE: revizuirile îmbunătățesc sistemele și runbook-urile.
Întrebări frecvente
Este automatizarea incidentelor aceeași cu AIOps?
Nu. AIOps aplică analize sau învățare automată asupra datelor de operațiuni. Automatizarea incidentelor este stratul mai larg de execuție și coordonare; poate folosi reguli simple, rezultate AIOps sau ambele.
Ce ar trebui automatizat mai întâi?
Începeți cu pași cu frecvență mare, risc scăzut și bine înțeleși, cum ar fi îmbogățirea, căutarea proprietarului, capturarea dovezilor, actualizările de stare și diagnosticele reversibile.
Referințe principale











