
Fundamentele AI
Ce este ingineria platformelor? Platforme, experiența dezvoltatorilor și măsuri de control

 Adaugă Unite.AI la sursele tale preferate pe Google
Ingineria platformelor este practica de a construi și opera capabilități interne partajate care ajută echipele de software să livreze și să ruleze aplicații prin fluxuri de lucru auto‑servite susținute. Platforma este tratată ca un produs al cărui utilizatori sunt dezvoltatorii și alte echipe tehnice.
O platformă nu este automat un portal, un cluster Kubernetes sau o colecție de scripturi. Devine utilă atunci când reduce sarcina cognitivă și timpul de livrare, în timp ce îmbunătățește fiabilitatea, securitatea, observabilitatea și coerența organizațională.
Aspecte cheie
- Începeți cu cercetarea dezvoltatorilor și cu frecarea recurentă, nu cu un set de instrumente predefinit.
- Oferiți căi de aur opționale și susținute, cu rute de ieșire clare pentru excepții legitime.
- Expuneți capabilitățile prin API-uri, șabloane, automatizare și documentație; un portal este doar o interfață.
- Măsurați rezultatele utilizatorilor și adoptarea produsului împreună cu livrarea, fiabilitatea, securitatea și costul.
Platforma ca produs intern
O echipă de platformă identifică utilizatorii interni, călătoriile, punctele dureroase și rezultatele dorite. Menține o foaie de parcurs, niveluri de serviciu, documentație, suport și bucle de feedback, la fel ca orice echipă de produs. Adoptarea se câștigă prin utilitate, nu prin impunerea unui nume pentru o echipă centrală.
Acest lucru extinde cooperarea DevOps. Echipele de aplicații păstrează proprietatea asupra serviciilor lor, în timp ce platforma furnizează capabilități reutilizabile și politici.
Capabilități, portaluri și căi de aur
Capabilitățile pot acoperi depozite, medii, CI/CD, secrete, identitate, infrastructură, observabilitate, cataloage de servicii, costuri și integrarea incidentelor. Un portal pentru dezvoltatori le poate expune, dar orchestrarea și serviciile operaționale fac platforma reală.
O cale de aur este o metodă bine susținută pentru a îndeplini o sarcină comună. Ar trebui să încorporeze valori implicite sigure și să rămână transparentă. Echipele au nevoie de o cale de excepție guvernată când cerințele diferă.
Arhitectură și măsuri de control
Utilizați interfețe stabile și API-uri declarative pentru ca platforma să poată evolua în spatele lor. Separați planul de control de sarcinile de lucru, delimitați acreditările, păstrați metadatele de proprietate și faceți modificările generate revizibile și reversibile.
Integrați verificările DevSecOps, politicile și proveniența artefactelor în fluxurile de lucru. Măsurile de control ar trebui să ofere feedback rapid și remediere acționabilă, nu refuzuri neexplicate.
Măsurați și evoluați
Măsurați timpul până la prima implementare, timpul de livrare, recuperarea în caz de eșec al modificărilor, disponibilitatea platformei, sarcina de suport, adoptarea, satisfacția, postura de securitate și costul. Evitați să numărați autentificările în portal ca un proxy pentru o livrare îmbunătățită.
Instrumentați platforma prin practici de operațiuni IT și intervievați utilizatorii în mod regulat. Eliminați căile neutilizate, standardizați acolo unde repetiția este costisitoare și permiteți diversitatea acolo unde creează valoare de produs.
Platforme interne pentru dezvoltatori și căi de aur
O platformă internă pentru dezvoltatori este un produs care expune infrastructura și capabilitățile operaționale aprobate prin interfețe auto‑servite. Poate combina un portal, un catalog de servicii, șabloane, API-uri, instrumente în linie de comandă, fluxuri de lucru de implementare, secrete, medii și observabilitate. Platforma nu înlocuiește cloud‑ul sau Kubernetes; le organizează în capabilități utilizabile.
O cale de aur este o metodă orientată și susținută pentru a finaliza o sarcină comună, cum ar fi crearea unui serviciu cu un depozit, un pipeline CI, un runtime, tablouri de bord, alerte și metadate de proprietate. Ar trebui să fie cea mai ușoară opțiune sigură, permițând în același timp excepții justificate. O cale obligatorie care nu poate susține sarcini reale devine un blocaj sau este ocolită.
Echipele de platformă ar trebui să trateze dezvoltatorii ca pe niște clienți și capabilitățile ca produse. Interviurile de descoperire, analizele de utilizare, datele de suport, foile de parcurs, documentația și obiectivele de nivel de serviciu contează la fel de mult ca automatizarea. Adoptarea este dovada utilității, dar adoptarea singură nu dovedește că livrarea, fiabilitatea, securitatea sau experiența dezvoltatorului s‑au îmbunătățit.
Planuri de control, interfețe și model operațional
Planul de control al platformei reconciliază intenția declarată a dezvoltatorului cu resursele subiacente. O definiție de serviciu poate solicita un runtime, o bază de date, o regiune și un nivel de fiabilitate; controlerele traduc aceasta în configurări de cloud, rețea, politică și observabilitate. Abstracțiile stabile ar trebui să ascundă complexitatea incidentă fără a masca starea operațională necesară pentru depanare.
Interfețele pot include portaluri web, API-uri, configurație bazată pe Git, CLI‑uri și componente de pipeline reutilizabile. Cea mai bună interfață depinde de frecvența sarcinilor și de fluxul de lucru al utilizatorului. Fiecare interfață necesită autentificare, autorizare, validare, istoric de audit, explicații ale erorilor și versionare. Auto‑servirea fără gestionarea ciclului de viață produce resurse abandonate și proliferare de configurații.
O echipă de platformă deține capabilitățile partajate și drumurile bătute, în timp ce echipele de aplicații păstrează responsabilitatea pentru comportamentul software‑ului și rezultatele de business. Echipele de securitate, fiabilitate, finanțe și infrastructură contribuie cu politici și servicii. Limitele explicite de responsabilitate împiedică platforma să devină fie o coadă de tichete neresponsabilă, fie o încercare de a centraliza fiecare decizie de inginerie.
Măsurarea valorii și evitarea eșecului platformei
Măsurați timpul de livrare până la prima implementare în producție, timpul de aprovizionare a mediului, frecvența implementărilor, rata de eșec a schimbărilor, timpul de recuperare, sarcina cognitivă, volumul de suport, fiabilitatea și adoptarea controalelor de securitate. Segmentați rezultatele pe echipă și sarcină de lucru. Un lansare de șablon mai rapid are valoare limitată dacă modificările din ziua a doua rămân lente sau incidentele devin mai greu de diagnosticat.
Eșecurile comune includ construirea înainte de a înțelege utilizatorii, copierea stivei unei companii mari, expunerea infrastructurii brute în spatele unui portal, impunerea standardizării premature și optimizarea pentru producția echipei de platformă. Începeți cu o călătorie recurentă dureroasă, cartografiați pașii și așteptările, livrați o cale subțire de la cap la coadă și iterați pe baza rezultatelor observate.
Platformele trebuie să evolueze fără a destabiliza fiecare serviciu. Utilizați contracte versionate, ferestre de depreciere, migrații automate, teste de compatibilitate și proprietate clară. Urmăriți dependențele platformei astfel încât o întrerupere a planului de control să nu blocheze toate implementările sau să afecteze sarcinile de lucru în execuție. Documentați procedurile de urgență (break‑glass) și testați regulat recuperarea în caz de eșec al platformei.
Exemplu practic: o cale auto‑servită pentru un API nou
Un dezvoltator selectează un șablon API aprobat și furnizează numele serviciului, proprietarul, clasificarea datelor, limbajul și nivelul de fiabilitate. Platforma creează un depozit, o politică de dependență, un pipeline CI, un mediu de testare, o configurare de implementare, o intrare în catalogul de servicii, tablouri de bord, alerte și un ghid inițial de operare. Politica validează numele, regiunile, permisiunile și expunerea la rețea înainte de aprovizionare, în timp ce artefactele generate rămân inspectabile și aparțin echipei.
Platforma expune operațiunile de ciclu de viață — crearea mediului, implementarea, scalarea, rotirea unui secret, vizualizarea jurnalelor, revenirea și retragerea — prin API-uri stabile și un portal. Sarcinile de lucru în execuție continuă dacă portalul nu este disponibil. Excepțiile folosesc un punct de extensie documentat și o expirare, în loc de o modificare manuală neregistrată. Șabloanele versionate și migrațiile automate împiedică îmbunătățirile platformei să rupă în tăcere serviciile existente.
Măsurați timpul de la crearea depozitului până la o implementare sănătoasă în producție, efortul dezvoltatorului, cererea de suport, eșecul schimbărilor, recuperarea, conformitatea cu politicile și adoptarea în funcție de tipul sarcinii de lucru. Intervievați utilizatorii care abandonează calea și inspectați unde așteaptă sau evadează abstracția. Echipa de platformă ar trebui să prioritizeze cea mai mare frecare recurentă, să publice fiabilitatea și foaia de parcurs și să elimine capabilitățile neutilizate. Un catalog rafinat nu este o platformă dacă echipele încă au nevoie de tichete pentru fiecare operație semnificativă.
Adoptarea ar trebui să fie etapizată. Începeți cu echipe voluntare și o clasă de sarcină de lucru, demonstrați operațiunile din ziua a doua, apoi migrați cu instrumente și suport. Publicați obiectivele de serviciu ale platformei și starea dependențelor și concepeți o rută de urgență (break‑glass) care să fie controlată, dar utilizabilă în timpul întreruperilor. Chargeback sau showback pot expune costul resurselor, dar echipele de produs au nevoie și de valori implicite sensibile pentru ca guvernanța financiară să nu devină o altă coadă de aprobare manuală.
Checklist practic de implementare
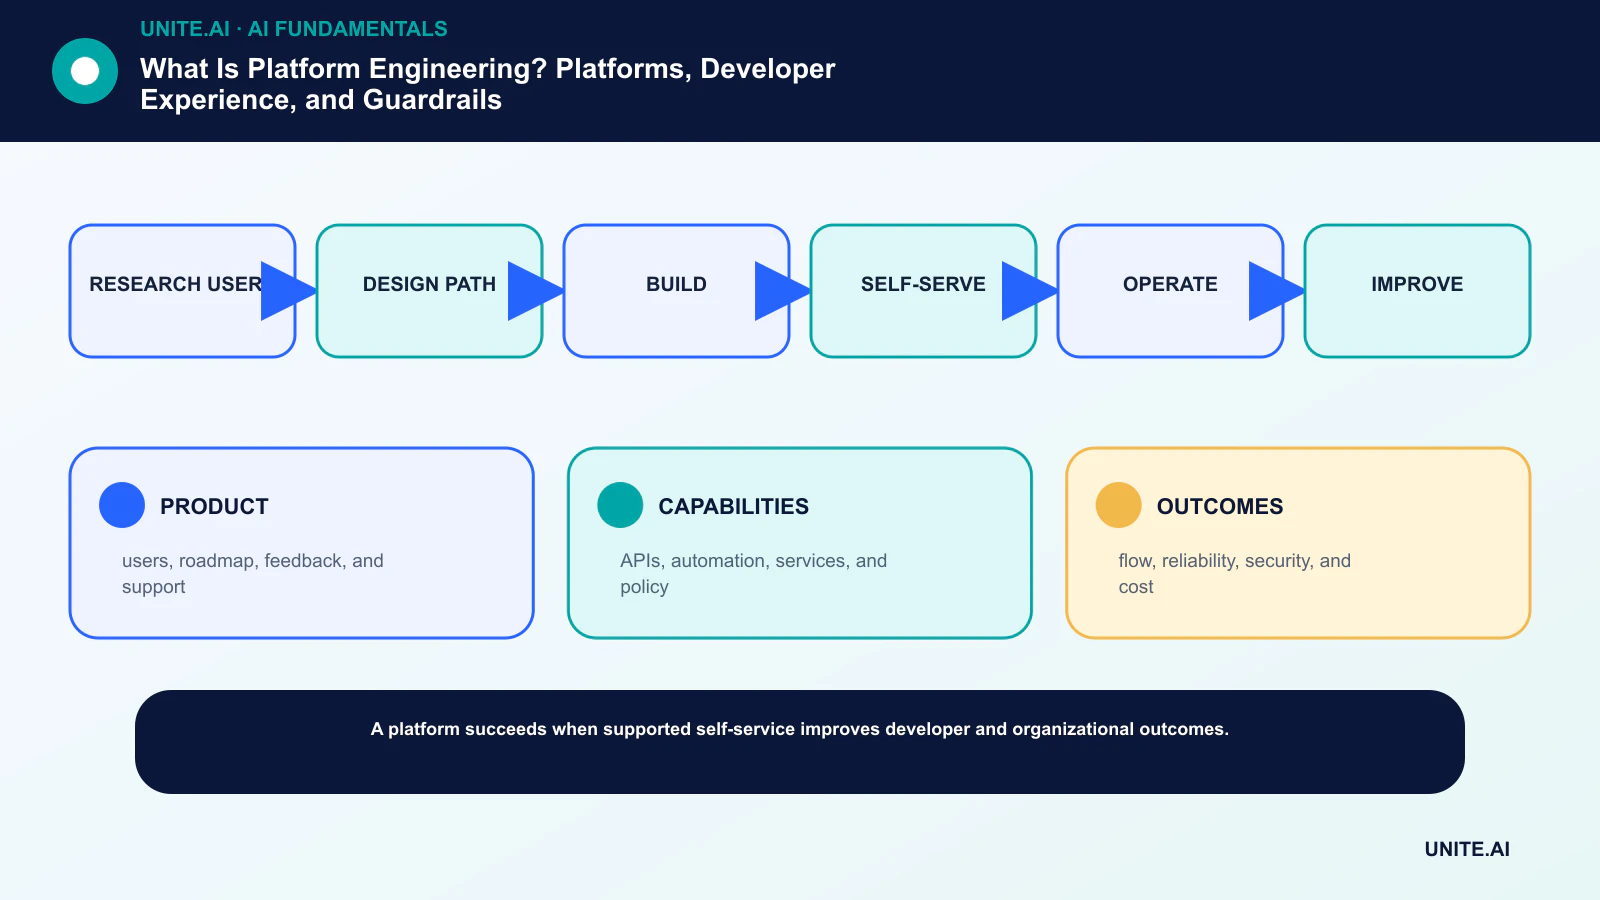
Transformați conceptul într-un flux de lucru delimitat și testabil: cercetare utilizatori → proiectare cale → construire → auto‑servire → operare → îmbunătățire. Numiți un responsabil responsabil, documentați datele și dependențele, stabiliți o linie de bază simplă, definiți criterii de acceptare și oprire, testați eșecuri reprezentative și definiți monitorizarea, revenirea și revizuirea înainte de a extinde domeniul. Înregistrați versiunile și ipotezele astfel încât o altă echipă să poată reproduce rezultatul și să înțeleagă ce s‑a modificat.
Înainte de lansare, efectuați o revizuire documentată a pregătirii cu persoanele care construiesc, operează, securizează și sunt afectate de sistem. Testați cazuri normale, condiții limită, eșecuri de dependență și utilizări incorecte; păstrați dovezile și riscurile nerezolvate. Definiți cine poate aproba lansarea, modifica un prag, anula un rezultat sau opri operațiunea. Revizuiți decizia după ce sosesc date din lumea reală, deoarece un pilot tehnic de succes nu garantează performanță fiabilă la scară mai largă.
- PRODUS: utilizatori, foaie de parcurs, feedback și suport.
- CAPABILITĂȚI: API-uri, automatizare, servicii și politică.
- REZULTATE: flux, fiabilitate, securitate și cost.
Întrebări frecvente
Înlocuiește ingineria platformelor DevOps?
Nu. Ingineria platformelor este un mod de a scala principiile DevOps prin furnizarea de produse partajate și capabilități auto‑servite. Colaborarea și proprietatea serviciului rămân esențiale.
Este un portal intern pentru dezvoltatori platforma?
De obicei nu. Un portal este o interfață. Platforma include, de asemenea, API-uri, automatizare, infrastructură, politici, servicii, documentație, suport și proprietate operațională.
Referințe principale











