Fundamentele AI
Ce este Știința Datelor?

 Adaugă Unite.AI la sursele tale preferate pe Google
Știința datelor este practica de a transforma datele în cunoștințe defensabile, predicții sau decizii. Combină expertiza de domeniu, statistica, calculul, ingineria datelor, vizualizarea și comunicarea. Un model poate face parte din muncă, dar disciplina începe înainte de modelare și continuă după implementare.
Întrebarea cea mai importantă nu este „Ce algoritm ar trebui să folosim?” Ci „Ce decizie susținem, ce dovezi ar răspunde la ea și cum vom ști că rezultatul rămâne util?”
Aspecte cheie
- Știința datelor este un flux de lucru de la cap la coadă bazat pe dovezi, nu un sinonim pentru învățarea automată.
- Definirea problemei, măsurarea și guvernanța datelor determină adesea succesul mai mult decât complexitatea modelului.
- Întrebările predictive și cauzale necesită presupuneri și designuri de evaluare diferite.
- O analiză implementată necesită monitorizare, documentare și comunicare adecvată utilizatorilor săi.
Începe cu o decizie și un estimand
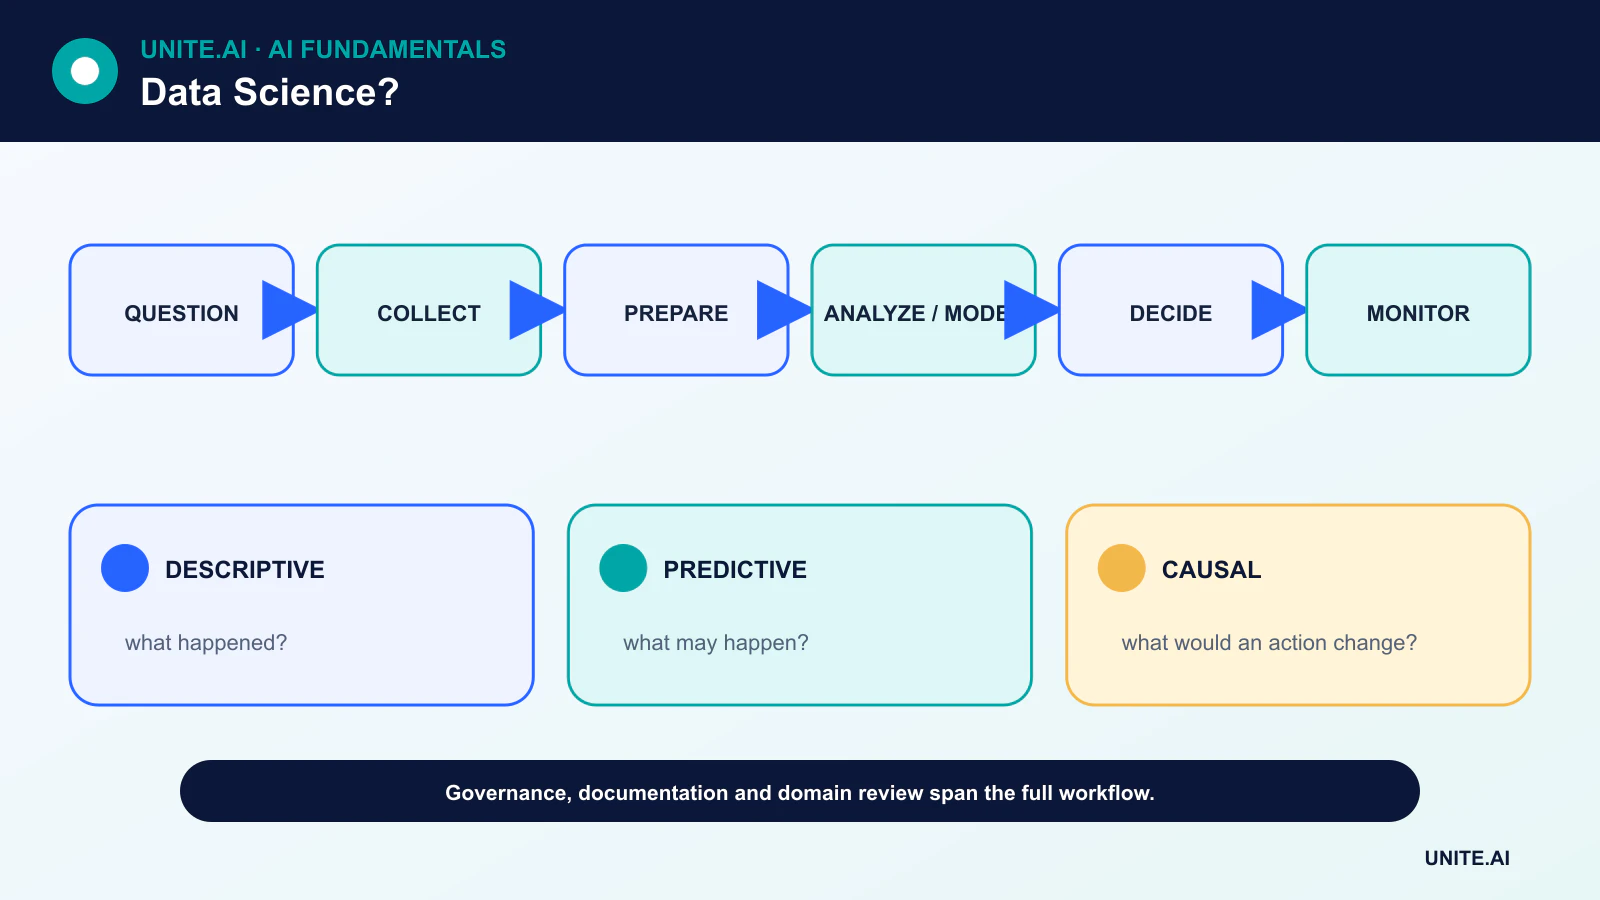
Un proiect ar trebui să identifice utilizatorul, decizia, intervenția și costul erorii. Pentru o întrebare descriptivă, ținta poate fi un rată sau o tendință. Pentru predicție, poate fi cererea viitoare sau riscul. Pentru o întrebare cauzală, estimandul descrie efectul unei intervenții definite sub presupunerile enunțate.
Obiective vagi, cum ar fi „găsește informații”, fac imposibilă evaluarea. Un obiectiv măsurabil creează o limită pentru colectarea datelor și împiedică analiza să se extindă în fiecare domeniu disponibil.
Colectează, guvernează și înțelege datele
Echipele fac inventarierea surselor, proprietății, consimțământului, retenției, liniei de proveniență și accesului. Ele diferențiază datele structurate și nestructurate, definesc unități și marcaje temporale și examinează dacă înregistrările reprezintă populația și perioada de timp de interes.
Curățarea nu înseamnă doar ștergerea rândurilor lipsă. Include rezolvarea duplicatelor, valorilor imposibile, ambiguității etichetelor, deriva schemelor, cenzurarea și îmbinările care schimbă unitatea de analiză. Fiecare transformare trebuie să fie reproductibilă și documentată.
Explorează înainte de modelare
Analiza exploratorie studiază distribuțiile, lipsurile, relațiile și posibilele artefacte de măsurare. Vizualizarea poate expune valori aberante și diferențe între subgrupuri pe care o medie rezumată le ascunde. Explorarea ar trebui să informeze ipotezele fără a fi confundată cu dovezi confirmatorii.
Ingineria caracteristicilor, reducerea dimensionalității și învățarea de reprezentare pot îmbunătăți modelarea, dar transformările trebuie să fie ajustate doar pe datele de antrenament pentru a preveni scurgerea.
Alege metodele potrivite pentru întrebare
Estimarea statistică cuantifică incertitudinea în jurul cantităților de interes. Învățarea automată este utilă când scopul principal este performanța predictivă pe date noi. Experimentele și metodele de inferență cauzală sunt necesare când obiectivul este efectul unei intervenții.
Un punct de referință ar trebui să fie suficient de simplu pentru a fi înțeles. Modelele mai complexe trebuie să-și justifice costul suplimentar printr-o performanță mai bună pe datele de testare, incertitudine calibrată, valoare operațională sau o capacitate necesară, cum ar fi procesarea imaginii sau a limbajului.
Evaluează, comunică și monitorizează
Evaluarea ar trebui să corespundă deciziei. Un clasificator poate necesita precizie, recall, calibrare și analiză pe subgrupuri în loc de simpla acuratețe; un sistem de prognoză are nevoie de backtesting conștient de timp. Supraîncărcarea și scurgerea sunt defecțiuni ale procesului, nu doar proprietăți ale modelului.
Comunicarea include presupunerile, incertitudinea, limitările și acțiunile recomandate. Odată ce un model sau un tablou de bord este utilizat, echipele monitorizează calitatea intrărilor, deriva rezultatelor, comportamentul utilizatorilor și impactul în aval. Un proces decizional retras are nevoie de un arhivă și de o proprietate clară, la fel cum unul implementat necesită un operator.
Ciclul de viață al științei datelor și întrebările analitice
Știința datelor combină cunoștințele de domeniu, statistica, calculul și comunicarea pentru a transforma datele în dovezi pentru decizii. Începe prin a distinge descrierea, diagnosticul, predicția și inferența cauzală. Un tablou de bord care raportează ce s-a întâmplat, un model care prezice cine va renunța și un experiment care estimează dacă o intervenție modifică renunțarea răspund la întrebări diferite. Definește unitatea, populația, fereastra temporală, rezultatul, acțiunea și costul erorilor înainte de a extrage datele. Multe proiecte eșuate rezolvă un proxy măsurabil care nu poate susține decizia vizată.
Achiziția necesită proveniență, permisiuni, design de eșantionare și un contract de date. Explorarea verifică distribuțiile, lipsurile, duplicatele, valorile aberante, relațiile, schimbările de măsurare și posibila scurgere. Alegerile de curățare sunt presupuneri analitice: ștergerea rândurilor lipsă, imputarea valorilor sau limitarea valorilor aberante pot schimba populația și concluzia. Versionează datele brute în mod imuabil și transformările ca cod și creează un dicționar de date cu unități și semnificații. Împarte datele de evaluare înainte de a învăța transformările sau de a testa ipoteze în mod repetat.
Modelare, inferență și reproductibilitate
Inferența statistică cuantifică incertitudinea sub presupuneri; modelarea predictivă estimează performanța pe date neincluse în antrenament; analiza cauzală necesită identificare prin design sau presupuneri defensabile. Selectează metode care se potrivesc întrebării și procesului de generare a datelor. Compară cu puncte de referință simple, folosește validare grupată sau conștientă de timp și raportează incertitudinea și sensibilitatea. O corelație ridicată sau importanța unei caracteristici nu stabilește cauzalitatea. Testarea multiplă, gradul de libertate al cercetătorului și raportarea selectivă pot fabrica modele convingătoare, astfel că preregistrarea sau o etapă clar separată de confirmare pot ajuta.
Reproductibilitatea include codul, mediul, instantaneul de date, semințele aleatoare, definițiile interogărilor și o înregistrare a deciziilor manuale. Testele automate ar trebui să acopere schemele, invariatele de business, transformările și metricile. Notebook-urile sunt valoroase pentru explorare, dar munca de producție necesită conducte modulare, revizibile. Revizuirea de către colegi ar trebui să pună la îndoială presupunerile, scurgerea, validitatea țintei și dacă rezultatele se generalizează. Comunică dimensiunile efectului, incertitudinea, limitările și contra-dovezile, nu doar semnificația statistică sau scorul unui model.
Implementare și impactul deciziei
Dacă analiza conduce un proces recurent, atribuie responsabili, monitorizează prospețimea datelor și calitatea rezultatelor și definește revenirea sau retragerea. Protejează informațiile personale și confidențiale prin minimizare, control de acces, retenție și rezultate sigure. Evaluează efectele pe subgrupuri și modul în care utilizatorii răspund la model; buclele de feedback pot schimba datele viitoare. Măsoară dacă decizia a îmbunătățit obiectivul real, nu doar dacă un model a fost implementat. Știința datelor are succes când dovezile schimbă acțiunea în mod fiabil și transparent – nu când o organizație acumulează tablouri de bord, funcționalități sau experimente fără responsabilitate.
Exemplu practic: măsurarea unei intervenții de retenție
O echipă de produs observă o retenție mai scăzută și definește un utilizator activ, o cohortă, o fereastră, excluderi și o decizie. Analiștii auditează instrumentarea, evenimentele lipsă și mixul de achiziție înainte de modelare. Cohortele descriptive identifică unde apare declinul, un model predictiv prioritizează participanții la cercetare, iar un experiment randomizat de onboarding estimează dacă schimbarea propusă îmbunătățește retenția. Acestea sunt trei analize distincte cu presupuneri și rezultate separate.
Notebook-ul, interogările, instantaneul de date, definiția metricii și planul de experiment sunt versionate și revizuite de colegi. Rezultatele raportează dimensiunea efectului și incertitudinea cu limite de protecție pentru cererea de suport și accesibilitate. Un tablou de bord monitorizează experimentul, dar nu înlocuiește analiza predeclanșată. Dacă intervenția reușește, implementarea rămâne etapizată și verifică comportamentul pe termen lung. Munca este considerată valoroasă numai dacă susține o decizie reproductibilă, nu pentru că a fost produs un model complex sau un grafic vizual atrăgător.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definește utilizatorii vizați, mediul operațional, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabilește o bază reproductibilă și un set de evaluare versionat înainte de reglare. Testează cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbarea distribuției, întreruperi ale dependențelor, utilizare incorectă și grupurile sau mediile cel mai probabil subreprezentate. Măsoară calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrează fiecare transformare și prag pentru ca un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuie autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Folosește o implementare etapizată, păstrează o soluție de rezervă sigură și verifică monitorizarea cu defecțiuni injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definește pragurile de alertă și responsabilul pentru răspuns, apoi revizuiește dovezile din lumea reală după implementare în loc să presupui că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware-ul sau obiectivele se schimbă. Un sistem întreținut are nevoie și de proceduri documentate de recuperare, învățare din incidente, ștergere și retenție, și de un punct clar în care să fie dezactivat sau înlocuit.
Întrebări frecvente
Este știința datelor aceeași cu analiza datelor?
Termenii se suprapun. Știința datelor include adesea construirea de produse de date și sisteme predictive, în timp ce analiza poate fi mai concentrată pe suport decizional descriptiv și diagnostic. Utilizarea în organizații variază.
Are toate proiectele de știință a datelor nevoie de AI?
Nu. O interogare, diagramă, experiment sau estimare statistică bine concepută poate fi mai utilă și mai de încredere decât un model complex.
Referințe principale