
Fundamentele AI
Ce este un NPU? Unități de procesare neurală explicate

 Adaugă Unite.AI la sursele tale preferate pe Google
O unitate de procesare neurală (NPU) este un accelerator specializat conceput să execute eficient operații comune ale rețelelor neuronale. În telefoane, PC-uri, vehicule, camere și sisteme încorporate, poate rula sarcini AI suportate cu consum redus de energie sau poate elibera CPU‑ul și GPU‑ul pentru alte sarcini.
NPU este un termen larg utilizat în industrie, nu o arhitectură universală. Performanța depinde de operatorii suportați, formatele numerice, memoria, compilatorul și runtime‑ul, limitele termice și de câtă parte a unei aplicații poate rămâne pe accelerator.
Aspecte cheie
- NPUs pun accent pe operații cu matrici, vectori și tensori, cu reutilizare ridicată a datelor și consum redus de energie.
- TOPS maxim nu reprezintă un benchmark de aplicație completă și poate presupune o precizie sau o raritate specifică.
- Un model poate necesita conversie, cuantizare, partiționare a graficului și fallback pentru operații neacceptate.
- Comparați latența, debitul, consumul de energie, memoria, calitatea, confidențialitatea și portabilitatea pe sarcina reală.
Rolurile CPU, GPU și NPU
CPU‑urile excelează la fluxul de control general și la compatibilitate largă. GPU‑urile oferă debit paralel programabil și ecosisteme software extinse. NPU‑urile se specializează în operații tensoriale repetate și pot include memorie locală, matrici de înmulțire‑acumulare și flux de date optimizat pentru inferență.
Sistemele eterogene programează diferite părți acolo unde se potrivesc cel mai bine. Acest aspect contează pentru edge AI, unde puterea susținută și răspunsul rapid pot fi mai importante decât debitul maxim al unui centru de date.
Compilarea și execuția modelului
Un grafic de framework este convertit într-o reprezentare intermediară, optimizat, cuantizat unde este cazul și compilat pentru operatorii suportați. Runtime‑ul poate partiționa graficul astfel încât straturile neacceptate să fie executate pe CPU sau GPU.
Transferurile între procesoare pot anula avantajele acceleratorului. Formele statice, aranjamentul, precizia, batch‑urile și reutilizarea memoriei influențează performanța. Testați artefactul compilat deoarece calitatea modelului de deep‑learning se poate modifica după conversie.
Înțelegerea TOPS și a afirmațiilor de eficiență
TOPS raportează trilioane de operații pe secundă sub anumite presupuneri. Furnizorii pot număra înmulțirea și adunarea separat, pot folosi precizie pe întregi cu biți reduși sau pot presupune raritate. Un număr mai mare nu garantează o latență mai mică pentru un anumit model.
Măsurați pornirea la rece și la cald, latența per interogare, debitul, consumul de energie, memoria maximă, limitarea termică, dimensiunea contextului sau a imaginii suportate și proporția graficului accelerat. Utilizați aceeași acuratețe și versiuni de software echivalente.
Compromisuri ale AI-ului pe dispozitiv
Execuția locală poate reduce dependența de rețea și poate păstra intrările brute pe dispozitiv, dar modelele descărcate, jurnalele, copiile de rezervă și fallback‑urile în cloud generează în continuare fluxuri de date. Livrarea securizată a modelelor și actualizările platformei rămân necesare.
NPU‑urile pot susține aplicații de vedere, audio, limbaj și senzori, inclusiv sarcini adiacente TinyML. Dezvoltatorii ar trebui să proiecteze fallback‑uri elegante și să comunice când procesarea părăsește dispozitivul.
Arhitectura NPU și operațiile suportate
Un NPU accelerează operațiile tensoriale utilizând matrici de unități de înmulțire‑acumulare, memorie locală, programarea fluxului de date și formate numerice specializate. Menținerea greutăților și activărilor aproape de unitatea de calcul reduce mișcarea costisitoare a datelor. Dispozitivele reale diferă în suportul operatorilor, ierarhia memoriei, precizia, raritatea, programabilitatea și modul în care sarcina este partajată cu CPU‑ul și GPU‑ul.
Performanța maximă este adesea promovată în TOPS, dar TOPS nu specifică precizia, utilizarea, limitele de memorie, acoperirea operatorilor sau latența de la cap la cap. Două procesoare cu același număr de titlu pot avea performanțe diferite pe același model. Evaluați modelul compilat, dimensiuni realiste de batch și secvență, preprocesarea, transferurile și modul de alimentare.
NPU‑urile sunt eficiente pentru sarcini neuronale suportate, cum ar fi vedere, vorbire, denoising, efecte de fundal și modele de limbaj compacte. Operatorii neacceptați pot reveni la CPU sau GPU, generând transferuri și latențe imprevizibile. Inspectați rapoartele compilatorului și trasările runtime‑ului pentru a confirma plasarea, în loc să presupuneți că întregul grafic folosește acceleratorul.
Conversia, cuantizarea și implementarea modelului
Implementarea trece de obicei de la un framework de antrenament prin export, optimizare a graficului, cuantizare, compilare de la furnizor și integrare în runtime. Formele statice și operatorii comuni sunt cei mai ușor de accelerat. Fluxul de control dinamic, nucleele personalizate, tensori intermediați mari și tiparele de normalizare sau atenție neacceptate pot necesita modificări ale graficului sau execuție hibridă.
Formatele pe întregi și cu precizie redusă diminuează dimensiunea modelului, lățimea de bandă, energia și latența, dar datele de calibrare trebuie să reprezinte intrările reale. Comparați cuantizarea post‑antrenament cu cea conștientă de cuantizare atunci când calitatea este sensibilă. Evaluați comportamentul pe clasă și în cel mai rău caz, deoarece acuratețea medie poate ascunde degradări în cazuri rare sau critice pentru siguranță.
Inferența pe dispozitiv îmbunătățește latența, funcționarea offline și confidențialitatea prin limitarea transferului de date, dar dispozitivul are în continuare nevoie de modele securizate, acces la date în funcție de permisiuni și mecanisme de actualizare. Protejați fișierele modelului când este cazul, semnați actualizările, dezvăluiți fallback‑ul în cloud și asigurați-vă că telemetria nu reintroduce expunerea la confidențialitate pe care arhitectura locală a încercat să o reducă.
Evaluarea performanței și compromisurile la nivel de sistem
Măsurați latența la pornirea la rece și în stare stabilă, debitul, energia per inferență, memoria, comportamentul termic, acuratețea și impactul asupra bateriei. Testele lungi dezvăluie limitările termice pe care benchmark‑urile scurte le omite. Includeți preprocesarea și postprocesarea, deoarece redimensionarea, tokenizarea, decodarea sau copierea datelor pot domina un accelerator altfel rapid.
Programarea este o problemă de sistem. CPU‑ul gestionează logica aplicației, GPU‑ul poate reda sau executa straturi neacceptate, iar NPU‑ul rulează grafice compatibile. Sarcinile concurente de cameră, audio, afișaj și AI concurează pentru lățimea de bandă a memoriei și pentru energie. Testați scenariul complet al utilizatorului în loc de un model izolat într-un instrument al furnizorului.
Portabilitatea rămâne limitată între compilatoare și runtime‑uri. Preferă reprezentări standard ale modelului acolo unde funcționează, izolează codul specific furnizorului în spatele interfețelor, păstrează ieșirile de referință și menține acoperirea testelor pe dispozitiv. Alege hardware‑ul pe baza sarcinilor validate, suportului software, orizontului de actualizări și costului total al sistemului — nu pe baza unei singure specificații a acceleratorului.
Exemplu practicat: implementarea unui model de vedere pe un laptop cu NPU
O echipă antrenează un model de segmentare pentru efecte de fundal, îl exportă într-un format de interschimb suportat, înlocuiește operatorii neacceptați și calibrează cuantizarea pe întregi cu camere, iluminare, tonuri de piele, îmbrăcăminte și fundaluri reprezentative. Compilatorul furnizorului raportează care noduri rulează pe NPU și care fac fallback. Echipa tratează orice trecere la fallback ca un cost de sistem, deoarece transferurile de tensor pot domina un kernel individual rapid.
Benchmark‑ul măsoară preprocesarea camerei, execuția modelului, compunerea, memoria, pornirea la rece, latența în stare stabilă, stabilitatea cadrelor, consumul și limitarea termică în timpul unui apel video real. Rezultatele sunt comparate cu căile CPU și GPU la aceeași calitate a ieșirii. Aplicația folosește detectarea capabilităților și un fallback testat în loc să presupună că acceleratorul există sau că suportă același grafic după o actualizare a driverului.
Testarea de lansare acoperă modele de dispozitive, versiuni de sistem de operare și driver, sarcini concurente, moduri de baterie și intrări defectuoase. Pachetele de model sunt semnate și versionate; telemetria înregistrează performanța și erorile fără a colecta video inutil. Produsul explică când procesarea rămâne pe dispozitiv și când sunt utilizate funcții în cloud. NPU‑ul își câștigă locul prin îmbunătățirea experienței complete în condiții realiste, nu prin atingerea unui benchmark izolat de TOPS sau kernel.
Lista de verificare pentru implementare practică
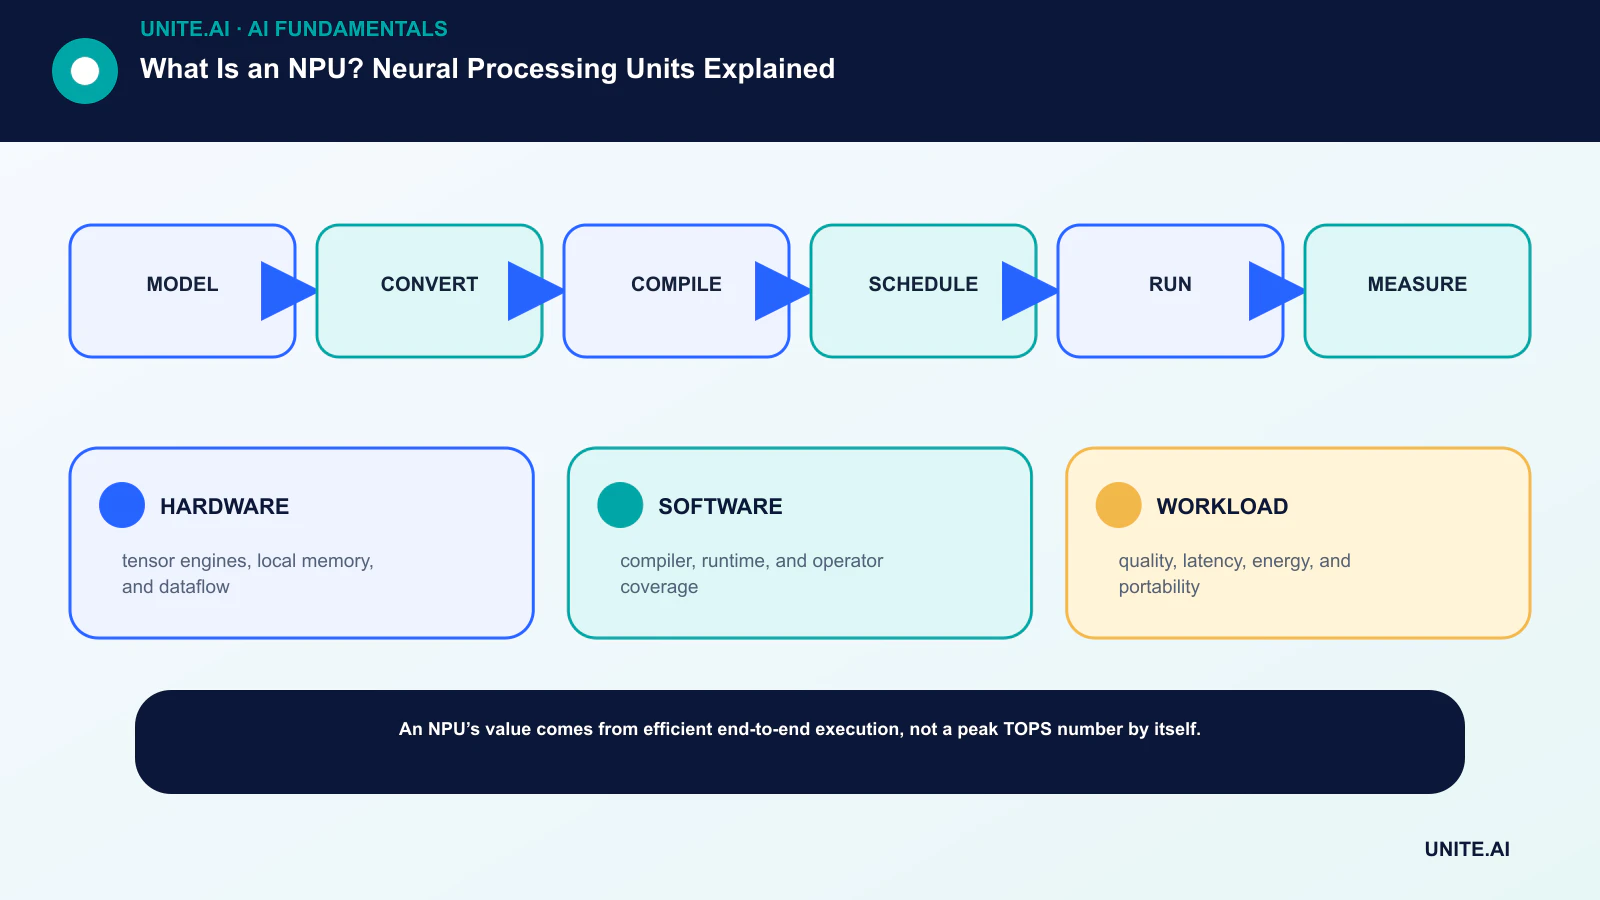
Transformați conceptul într-un flux de lucru delimitat și testabil: model → conversie → compilare → programare → execuție → măsurare. Numiți un responsabil, documentați datele și dependențele, stabiliți o linie de bază simplă, definiți criterii de acceptare și oprire, testați eșecuri reprezentative și definiți monitorizarea, revenirea și revizuirea înainte de a extinde domeniul. Înregistrați versiunile și presupunerile pentru ca o altă echipă să poată reproduce rezultatul și să înțeleagă ce s‑a schimbat.
Înainte de lansare, efectuați o revizuire documentată a pregătirii cu persoanele care construiesc, operează, securizează și sunt afectate de sistem. Testați cazuri normale, condiții limită, eșecuri de dependență și utilizări incorecte; păstrați dovezile și riscurile nerezolvate. Definiți cine poate aproba lansarea, modifica un prag, anula o ieșire sau opri funcționarea. Reexaminați decizia după ce sosesc date din lumea reală, deoarece un pilot tehnic de succes nu garantează performanță fiabilă la scară mai largă.
- HARDWARE: motoare de tensor, memorie locală și flux de date.
- SOFTWARE: compilator, runtime și acoperirea operatorilor.
- WORKLOAD: calitate, latență, consum de energie și portabilitate.
Întrebări frecvente
Este un NPU mai rapid decât un GPU?
Depinde de model, precizie, suportul operatorilor, dimensiunea batch‑ului, limita de putere și software. Un NPU poate fi mai eficient pentru o sarcină pe dispozitiv suportată, în timp ce un GPU este mai rapid sau mai flexibil în alte cazuri.
Un NPU păstrează toate datele AI private?
Nu. Permite procesarea locală, dar aplicația poate totuși să trimită date sau rezultate către servicii cloud. Confidențialitatea depinde de arhitectura completă și de politică.
Referințe principale












