
Fundamentele AI
Ce este interpretabilitatea mecanistică? Cum analizează cercetătorii modelele AI

 Adaugă Unite.AI la sursele tale preferate pe Google
Interpretabilitatea mecanistică studiază modul în care componentele învățate dintr-o rețea neurală produc în mod cauzal comportamentul. În loc să se coreleze doar intrările cu ieșirile, cercetătorii formulează ipoteze despre caracteristici, capete de atenție, neuroni și circuite, apoi intervine pentru a le testa.
Domeniul a generat explicații detaliate pentru comportamente selectate în modele mici și medii, dar o descriere completă și fidelă a unui model de ultimă generație rămâne de neatins. Explicațiile automate și vizualizările atractive pot fi puncte de plecare utile, nu dovezi.
Aspecte principale
- Caracteristicile sunt modele reprezentate; circuitele sunt componente interacționale propuse pentru a implementa un calcul.
- Patch‑area activării, ablația și trasarea cauzală testează dacă o componentă modifică un comportament.
- Suprapunerea înseamnă că un neuron poate participa la multe caracteristici; autoencoderele rare încearcă o bază de caracteristici diferită.
- Metodele de interpretabilitate necesită adevăruri de bază, teste falsificabile, acoperire și evaluare față de explicații alternative.
De la reprezentare la mecanism
Interogarea întreabă dacă informația poate fi decodificată dintr-o activare. Atribuirea estimează care intrări sau componente sunt relevante. Munca mecanistică merge mai departe, propunând un calcul intern și verificând dacă intervențiile modifică comportamentul intermediar și final așteptat.
Acest lucru îl face legat, dar mai restrâns decât AI explicabilă. O explicație post-hoc pentru o decizie nu este neapărat un algoritm inginerizat invers în interiorul modelului.
Circuite și intervenții cauzale
Cercetătorii pot identifica un cap de atenție sau o caracteristică asociată cu o sarcină, o pot abla, pot patch-ui activările dintr-o altă rulare sau pot urmări cum informația se deplasează prin straturi. O ipoteză bună prezice comportamentul pe exemple noi și rezistă controalelor.
Intervențiile pot crea stări în afara distribuției, astfel încât o schimbare de comportament nu dezvăluie automat calculul natural. Folosiți multiple metode, controale comparabile și efecte cantitative în loc de un singur prompt ilustrativ.
Suprapunere și caracteristici rare
Rețelele neuronale pot reprezenta mai multe caracteristici decât dimensiunile individuale prin suprapunere. Un neuron poate, prin urmare, să se activeze pentru mai multe tipare nelegate, făcând etichetele la nivel de neuron înșelătoare.
Autoencoderele rare învață un dicționar mai mare de caracteristici din activările modelului. Ele pot face tiparele mai separabile, dar raritatea aleasă, datele de antrenament, eroarea de reconstrucție și etichetele automate influențează ce este recuperat. Caracteristicile rețelei neuronale necesită în continuare validare cauzală.
Siguranță, depanare și limitări
Instrumentele mecanistice pot ajuta la identificarea faptelor memorate, a părtinirilor, a strategiilor înșelătoare sau a circuitelor defecte și pot susține editarea sau monitorizarea. Aceleași instrumente pot omite calcule distribuite, rare sau dependente de context.
Tratați constatările ca dovezi delimitate: versiunea modelului, sarcina, setul de date, stratul, intervenția, efectul și incertitudinea. Conectați interpretarea la evaluări comportamentale, red‑teaming și guvernanța AI responsabilă în loc să o folosiți ca un certificat de siguranță universal.
Reprezentări, circuite și dovezi cauzale
Interpretabilitatea mecanistică studiază modul în care calculele interne generează comportamentul modelului. Cercetătorii inspectează activările, greutățile, atenția și caracteristicile intermediare, apoi formulează ipoteze despre reprezentări și circuite. O reprezentare nu este neapărat stocată într-un singur neuron; poate fi distribuită pe direcții, straturi, tokenuri și combinații dependente de context.
Autoencoderele rare încearcă să descompună activările dense într-un set mai mare de caracteristici care se activează selectiv. Etichetele caracteristicilor sunt interpretări umane ale exemplelor observate, nu adevăruri de bază. Eroarea de reconstrucție, raritatea, divizarea caracteristicilor, absorbția și caracteristicile moarte influențează ce dezvăluie descompunerea și ce omite.
Corelația este insuficientă pentru o afirmație mecanistică. Patch‑area activării, ablația, trasarea cauzală, ghidarea și intervențiile țintite asupra greutăților testează dacă o componentă modifică comportamentul conform predicției. Intervențiile pot crea, de asemenea, stări în afara distribuției, astfel încât rezultatele necesită controale, analiză doză‑răspuns, explicații alternative și replicare pe diferite prompturi și modele.
Un flux de lucru riguros pentru interpretabilitate
Începeți cu un comportament măsurat precis și cu un set de date care separă ipotezele concurente. Localizați straturile, pozițiile, componentele sau caracteristicile relevante; inspectați mecanismele candidate; interveniți; și testați dacă circuitul propus prezice cazuri noi. Păstrați exemplele exploratorii separate de evaluarea confirmatorie pentru a reduce biasul de selecție.
Instrumentele automate pot clasifica neuroni, caracteristici, capete sau căi, în timp ce modelele lingvistice pot propune descrieri. Automatizarea crește acoperirea, dar poate fabrica povești plauzibile. Evaluați explicațiile pe exemple de activare reținute și pe predicții cauzale, înregistrați incertitudinea și faceți artefactele reproductibile cu versiunea modelului, tokenizer‑ul, prompturile și codul.
Mecanismele pot fi polisemantice, redundante, neliniare și distribuite. Eliminarea unei componente poate fi compensată de altele, în timp ce o caracteristică poate participa la mai multe comportamente. Constatările negative sunt informative: un circuit aparent care eșuează în afara exemplelor curate ar trebui restrâns sau respins, nu salvat cu o explicație tot mai vagă.
Aplicații, limitări și afirmații de siguranță
Interpretabilitatea poate ajuta la depanarea halucinațiilor, a părtinirilor, a memorării, a comportamentului de tip jailbreak sau a generalizării neașteptate; la compararea modelelor; și la generarea de ipoteze științifice. De asemenea, poate identifica caracteristici pentru monitorizare sau intervenție. Aceste utilizări necesită validare specifică sarcinii, deoarece o vizualizare de cercetare utilă nu este automat un control de producție fiabil.
Absența unei caracteristici detectate nu dovedește absența unei capacități sau intenții, iar o caracteristică lizibilă nu dovedește că modelul o folosește într-un răspuns dat. Instrumentele observă o proiecție a calculului cu acoperire limitată. Afirmațiile de siguranță trebuie să specifice sensibilitatea detectării, fals‑pozitivele, distribuția, adversarul și punctele oarbe cunoscute.
Utilizați interpretabilitatea alături de evaluări comportamentale, red‑teaming, guvernanța datelor, controale de acces, monitorizare și răspuns la incidente. Publicați metode și contraexemple când este posibil. Domeniul progresează rapid, dar tehnicile actuale nu oferă o explicație completă și fidelă a raționamentului modelelor de frontieră sau o garanție generală de aliniere.
Exemplu practic: testarea unui circuit propus al modelului
Presupunem că un model pare să folosească un set de capete de atenție și caracteristici pentru a rezolva un complement indirect într-o propoziție. Cercetătorii definesc un set de date controlat cu nume, poziții, distrageri și contraexemple variate, apoi măsoară comportamentul. Inspecția activărilor identifică componente candidate, dar ipoteza este scrisă înainte de intervenție: ce informație poartă fiecare componentă, unde se mută și cum ar trebui modificarea ei să altereze ieșirea.
Patch‑area activării și ablația testează necesitatea și suficiența pe exemple reținute. O editare țintită care schimbă tokenul prezis în direcția așteptată susține mecanismul; deteriorarea largă a performanței nu o susține. Controalele patch-uiesc poziții și componente irelevante, variază magnitudinea intervenției și compară circuite alternative. Echipa publică cazuri negative în care explicația eșuează și evită atribuirea unui scop lizibil din corelație singură.
Pentru a susține o aplicație de siguranță, metoda trebuie să detecteze comportamentul relevant cu sensibilitate cunoscută sub prompturi realiste și adaptare adversarială. Monitoarele de caracteristici sunt evaluate pentru fals‑pozitive, evaziune, actualizări ale modelului și relevanță cauzală. Dovezile de interpretabilitate pot ghida depanarea și teste suplimentare, dar aplicarea rămâne în controalele externe și monitorizarea comportamentală. Un diagramă de circuit convingătoare este o ipoteză științifică cu dovezi — nu o explicație completă a unui model sau o garanție privind comportamentul nevăzut.
Listă de verificare pentru implementare practică
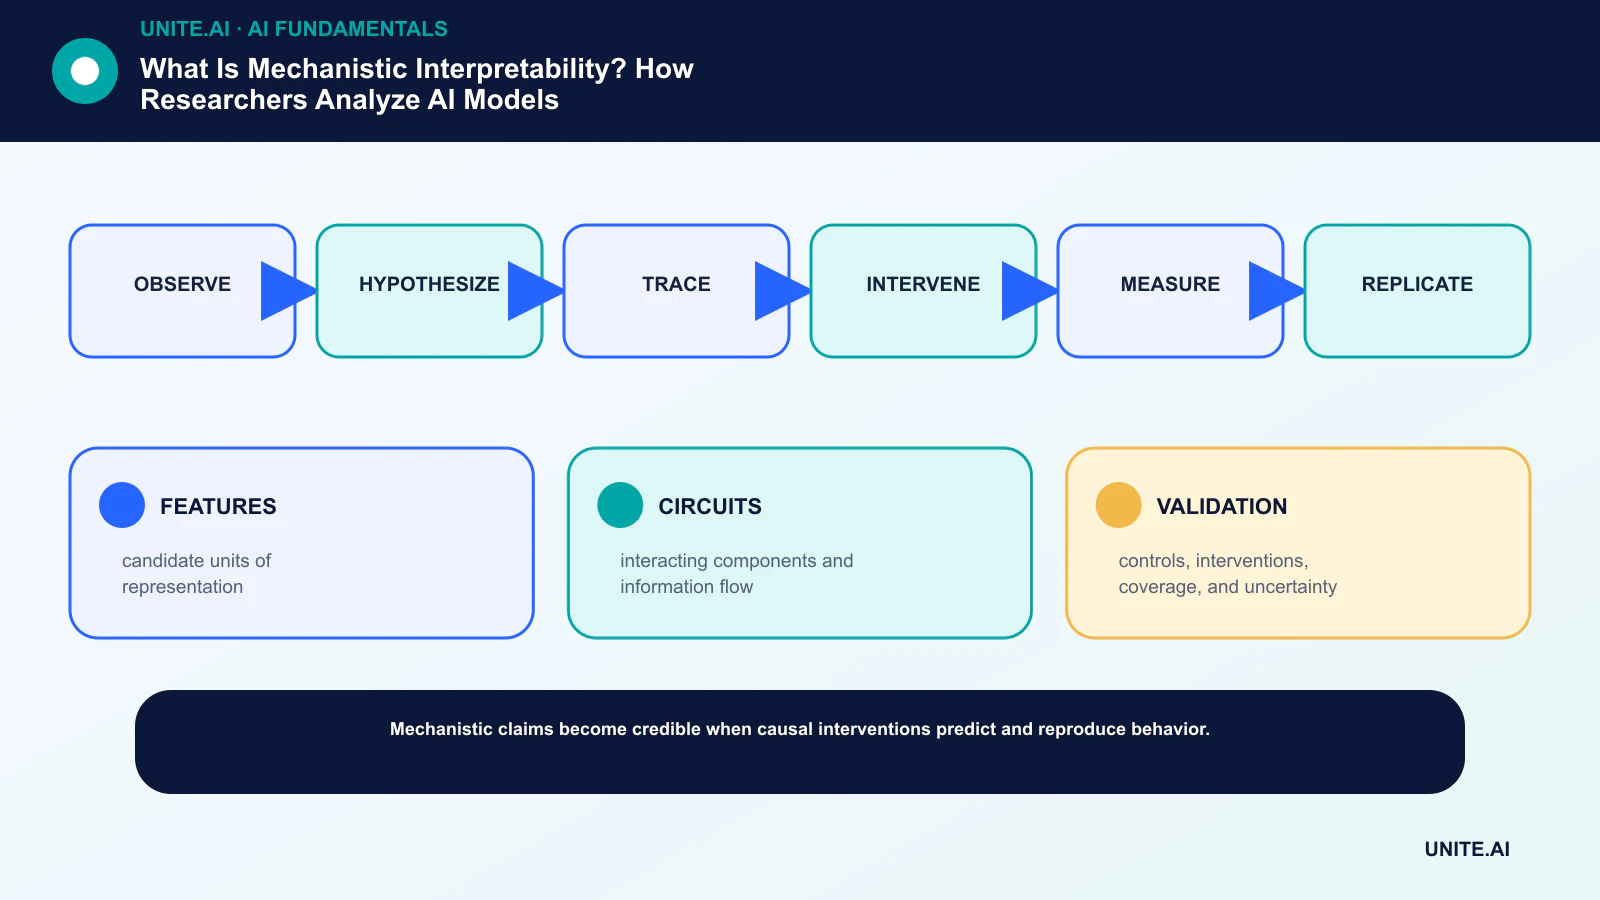
Transformați conceptul într-un flux de lucru delimitat și testabil: observați → formulați ipoteze → trasați → interveniți → măsurați → replicați. Numiți un responsabil, documentați datele și dependențele, stabiliți o linie de bază simplă, definiți criterii de acceptare și oprire, testați eșecuri reprezentative și definiți monitorizarea, revenirea și revizuirea înainte de a extinde domeniul. Înregistrați versiunile și presupunerile pentru ca o altă echipă să poată reproduce rezultatul și să înțeleagă ce s‑a schimbat.
Înainte de lansare, efectuați o revizuire documentată a pregătirii cu persoanele care construiesc, operează, securizează și sunt afectate de sistem. Testați cazuri normale, condiții limită, eșecuri ale dependențelor și utilizări abuzive; păstrați dovezile și riscurile nerezolvate. Definiți cine poate aproba lansarea, modifica un prag, suprascrie o ieșire sau opri funcționarea. Reexaminați decizia după ce sosesc date din lumea reală, deoarece un pilot tehnic de succes nu garantează o performanță fiabilă la scară mai largă.
- FUNCȚII: unități candidate de reprezentare.
- CIRCUITE: componente interacționale și flux de informație.
- VALIDARE: controale, intervenții, acoperire și incertitudine.
Întrebări frecvente
Este interpretabilitatea mecanistică aceeași cu citirea greutăților modelului?
Nu. Greutățile brute nu sunt auto‑explicative. Cercetătorii analizează activările, caracteristicile, componentele și intervențiile pentru a construi și testa ipoteze cauzale.
Pot autoencoderele rare să explice pe deplin un LLM?
Nu. Ele oferă o bază de caracteristici candidate și pot susține analiza circuitelor, dar acoperirea, fidelitatea, reconstrucția, etichetarea și scalabilitatea rămân probleme deschise.
Referințe principale












