
Fundamentele AI
Ce este AI explicabil?

 Adaugă Unite.AI la sursele tale preferate pe Google
AI explicabil (XAI) cuprinde metode și practici care ajută oamenii să înțeleagă comportamentul sau rezultatul unui sistem AI. O explicație poate descrie intrările influente, prezenta un exemplu similar, oferi o schimbare contrafactuală, rezuma o regulă globală sau comunica când sistemul nu știe.
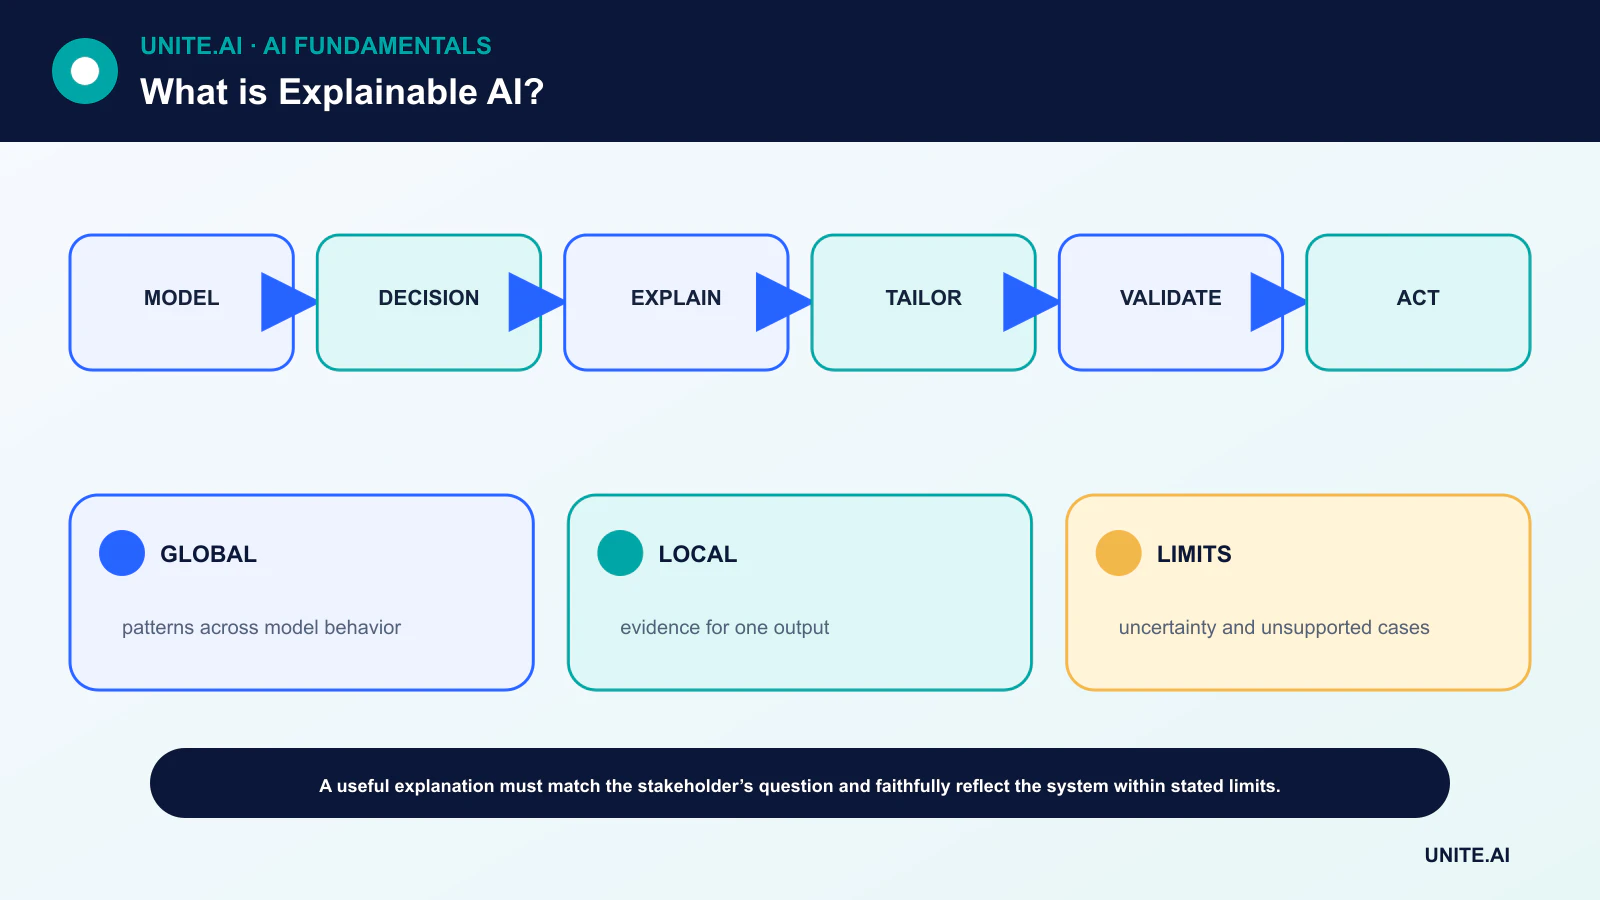
Nicio explicație nu este universală cea mai bună. Un dezvoltator care depanează un model, un auditor care testează conformitatea cu politica și o persoană afectată de o decizie au nevoie de dovezi diferite. Prin urmare, explicațiile trebuie evaluate pentru acuratețe, sens și utilizarea intenționată — nu doar pentru atractivitatea vizuală.
Aspecte cheie
- Transparența descrie informațiile disponibile; interpretabilitatea se referă la sens; explicația comunică dovezi sau motive.
- Metodele globale rezumă un model, în timp ce metodele locale se referă la o predicție sau la o regiune mică.
- Explicațiile post-hoc pot fi utile, dar pot fi instabile sau neconforme cu modelul de bază.
- O explicație nu demonstrează echitatea, cauzalitatea, robustețea sau corectitudinea.
Patru principii pentru explicații utile
NIST propune ca un sistem să ofere o explicație, să o facă semnificativă pentru utilizatorul său țintă, să se asigure că reflectă cu acuratețe procesul sistemului și să comunice limitele cunoașterii sale. Aceste principii separă existența unei explicații de calitatea acesteia.
Sensul este specific publicului. Un cod de motivare concis poate ajuta un solicitant, în timp ce un dezvoltator de model poate avea nevoie de distribuții, comportamentul caracteristicilor și grupuri de eșecuri. Ambele trebuie să fie legate de același sistem documentat și de contextul decizional.
Metode intrinseci și post-hoc
Un model liniar rar sau un arbore decizional constrâns poate fi direct interpretabil în cadrul domeniului său valid. Un model complex poate, în schimb, să folosească atribuirea de caracteristici post-hoc, un substitut local, exemple, hărți de saliență sau contrafactuale.
Simplitatea intrinsecă nu este automat fidelă atunci când caracteristicile sunt prost definite sau fluxul este ascuns. Complexitatea post-hoc nu este automat înșelătoare. Metoda trebuie testată în raport cu întrebarea la care se dorește să răspundă.
Atribuirea caracteristicilor și intrările corelate
Metodele de atribuire alocă părți ale unei ieșiri către caracteristicile de intrare sub presupuneri explicite. LIME ajustează un substitut local simplu în jurul unei predicții; metodele legate de SHAP conectează atribuțiile aditive la conceptele de valoare Shapley.
Caracteristicile corelate pot împărți sau schimba atribuțiile, iar o atribuire mare nu reprezintă un efect cauzal. Modificarea unei caracteristici în izolare poate genera o persoană, imagine sau tranzacție imposibilă. Explicațiile ar trebui să menționeze ipotezele de bază, eșantionare și dependență.
Contrafactuale, exemple și comportament global
Un contrafactual întreabă ce schimbare fezabilă ar modifica un rezultat. Constrângerile sunt esențiale: o explicație acționabilă nu ar trebui să recomande schimbări imuabile, ilegale sau nerealiste. Metodele bazate pe exemple afișează prototipuri sau cazuri de antrenament influente, dar pot expune date private.
Analiza globală examinează performanța, dependența parțială, monotonia, interacțiunile și comportamentul subgrupurilor. Pentru ansambluri precum gradient boosting, combinați rezumatele cu dovezi locale și teste directe ale constrângerilor așteptate.
Validați explicația și sistemul
Testați fidelitatea, stabilitatea la perturbări mici, consistența între intrări echivalente, înțelegerea de către utilizator și dacă explicația susține o decizie adecvată. Testele adversariale ar trebui să verifice dacă o explicație convingătoare poate însoți o ieșire greșită sau manipulată.
XAI face parte dintr-o evaluare mai largă: calitatea reținută, calibrarea, echitatea, confidențialitatea, securitatea, monitorizarea și mecanismele de contestație. O explicație poate susține responsabilitatea, dar nu poate înlocui guvernanța responsabilă.
Țintele explicației și familiile de metode
AI explicabil ar trebui să înceapă cu o întrebare și un public: de ce a avut loc o decizie, cum se comportă în general modelul, ce dovezi l-au influențat, ce ar schimba rezultatul sau dacă s-a respectat o politică. Explicațiile locale se referă la o predicție; explicațiile globale rezumă comportamentul mai larg. Modelele intrinsec interpretabile expun coeficienți, reguli sau structuri, în timp ce metodele post-hoc aproximează modele complexe. O explicație a comportamentului modelului nu este automat o explicație cauzală a lumii sau o justificare că o decizie este echitabilă.
Metodele de atribuire a caracteristicilor includ gradienti, gradienti integrați, valori de tip SHAP, permutare și modele substitut locale. Explicațiile bazate pe exemple recuperează cazuri influente sau similare; contrafactualele propun schimbări asociate cu o ieșire diferită; metodele de concept leagă reprezentările interne de categoriile umane. Fiecare are presupuneri privind bazele, independența caracteristicilor, liniaritatea locală sau accesul la model. Variabilele corelate, interacțiunile și preprocesarea pot face atribuțiile instabile sau înșelătoare. Comparați metodele și perturbați intrările pentru a testa dacă o explicație prezice comportamentul.
Evaluare și factori umani
Evaluați fidelitatea — dacă explicația se potrivește modelului — separat de plauzibilitatea pentru o persoană. Testați stabilitatea, sensibilitatea, completitudinea, raritatea și utilitatea pentru o sarcină definită, cum ar fi depanarea sau contestația. Studiile umane necesită participanți reprezentativi și ar trebui să măsoare calitatea deciziei, detectarea erorilor, încrederea și timpul, nu dacă utilizatorii spun că un grafic este clar. O explicație convingătoare poate crește încrederea într-un model greșit, astfel că interfețele trebuie să afișeze incertitudinea, alternativele și limitările.
Contrafactualele trebuie să fie fezabile, acționabile și să nu recomande schimbarea trăsăturilor protejate sau imuabile. Explicațiile pot scurge informații despre model sau personale și pot ajuta atacatorii să reconstruiască deciziile. Aplicați controale de acces și minimizarea ieșirilor. Pentru utilizări reglementate sau cu impact ridicat, păstrați proveniența datelor, versiunea modelului, pragul și logica deciziei reale; o grafică generică de importanță a caracteristicilor nu poate înlocui un motiv legal semnificativ sau o revizuire umană.
Utilizarea explicațiilor în mod responsabil
Selectați modelul cel mai simplu care satisface cerințele de performanță și operaționale, dar nu sacrificați validitatea pentru o interpretabilitate superficială. Combinați explicațiile cu testarea subgrupurilor, verificări de robustețe, analiză cauzală acolo unde este relevantă și monitorizarea rezultatelor. Documentați publicul țintă și inferențele invalide. Dacă o explicație se modifică după o perturbare inofensivă, investigați înainte de implementare. Explicabilitatea este o dovadă despre un sistem sub o metodă; este valoroasă pentru depanare, supraveghere și comunicare, dar nu certifică adevărul, echitatea, siguranța sau înțelegerea.
Exemplu practic: explicarea unui model de risc de credit
Un creditor definește mai întâi publicul și motivul necesar: solicitanții au nevoie de factori de decizie preciși și de o cale de corecție, în timp ce dezvoltatorii au nevoie de diagnosticare. O bază interpretabilă calibrată este comparată cu un model boostat. Atribuțiile locale, contrafactualele și analiza erorilor globale sunt testate pentru fidelitate, stabilitate, comportamentul caracteristicilor corelate și utilitate. Explicațiile nu pot recomanda schimbarea vârstei, dizabilității sau a alteia trăsături imuabile și nu sunt prezentate ca efecte cauzale.
Registrul deciziei de producție păstrează datele sursă, transformarea caracteristicilor, modelul, pragul, politica și acțiunea umană. Solicitanții pot contesta date incorecte și pot primi o revizuire semnificativă. Monitorizarea verifică stabilitatea rezultatului și a explicației între grupuri și actualizările modelului. Dacă o explicație plauzibilă se modifică în urma unei perturbări inofensive a caracteristicii sau omite o regulă de politică decisivă, implementarea se oprește. Explicabilitatea completează validarea și drepturile procedurale; nu justifică un obiectiv invalid, rezultate discriminatorii sau lipsa autorității umane responsabile.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o bază reproducibilă și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizare abuzivă și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o lansare etapizată, păstrați o alternativă sigură și verificați monitorizarea cu defecțiuni injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți pragurile de alertă și un responsabil de răspuns, apoi revizuiți dovezile din viața reală după implementare, în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Sunt hărțile de atenție explicații?
Pot fi semnale de diagnostic, dar greutățile de atenție singure nu garantează că reprezintă fidel motivele pentru ieșirea unui model.
Necesită AI explicabil un model simplu?
Nu întotdeauna. Modelele complexe pot fi analizate cu metode post-hoc, dar acele explicații necesită validare independentă și limite clar enunțate.
Referințe principale












