
Unghiul lui Anderson
Aducerea analogiilor vizuale în inteligența artificială

 Adaugă Unite.AI la sursele tale preferate pe Google
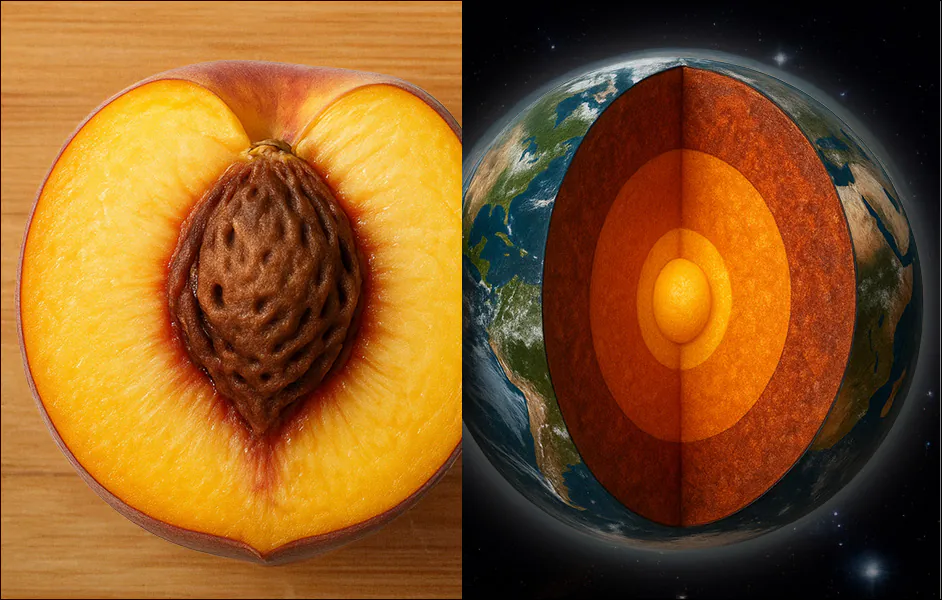
actuale de inteligență artificială nu recunosc “similitudinile relationale” dintre imagini, cum ar fi modul în care straturile Pământului sunt similare cu cele ale unei piersici, lipsindu-le un aspect cheie al modului
Deși există multe Modelele în care oamenii percepează imaginile. modele de viziune computerizată capabile să compareze imagini și să găsească similitudini între ele, generația actuală de sisteme comparative are versuri o capacitate de imaginație redusă sau inexistentă. Luați în considerare câteva cântecul clasic din aniidin
“obiecte”, dezvoltăm o Ca un carusel care se învârte, alergând în jurul lunii Ca un ceas a cărui mâini se mișcă pe fețele sale Și lumea este ca o măr care se învârte în liniște în
1960, : Windmills of Your Mind Asemenea comparații reprezintă un domeniu de aluzie poetică care este semnificativ pentru oameni într-un mod mult dincolo de expresia artistică; mai degrabă, este legat de modul în care dezvoltăm sistemele noastre perceptive; pe măsură ce creăm domeniul nostru de spațiu capacitate de similitudinevizuală , astfel încât – de exemplu – secțiunile care prezintă o piersică și planeta Pământ, sau recurențele fractale cum ar fi spiralele de cafea și ramurile galaxiilor, înregistrează ca analogice pentru noi. În acest fel, putem deduce legături între obiecte și tipuri de obiecte aparent neconectate și infernăm sisteme (cum ar fi gravitația, impulsul și coeziunea suprafeței) care pot fi aplicate la diverse domenii la diverse scară.
Viziunea
Chiar și cele mai recente generații de sisteme de comparație a imaginilor, cum ar fiLPIPSși DINO, care sunt informate de feedback-ul uman, efectuează doar comparații literale de suprafață. Capacitatea lor de a găsi fețe care nu există – adică pareidolie – nu reprezintă mecanismele de similitudine vizuală pe care le dezvoltă oamenii, ci se datorează faptului că algoritmii de căutare a fețelor utilizează caracteristici

rezultate false pozitive pentru recunoașterea facială în setul de date ‘Faces with Things’. Sursă Pentru a determina dacă mașinile pot dezvolta cu adevărat capacitatea noastră destinat să formezede a recunoaște similitudini vizuale, cercetătorii din SUA au efectuat un studiu despre , creând și antrenând un nou set de date


dezvoltat pentru setul de date facilitează annotații neobișnuit de abstracte, proiectate pentru a săforța sistemele de IA se concentreze pe caracteristici de bază,maidegrabă

din știința cognitivă, în special teoria Structurii-Mapping (un studiu despre analogie) și definiția lui Amos Tversky despre similitudine relațională și similitudine de atribut . De pe site-ul proiectului asociat, un

similitudinea de atribut
dar similitudinea relațională necesită abstracție conceptuală, adesea susținută de limbaj sau cunoștințe anterioare. Acest lucru sugerează că recunoașterea similitudinii relationale necesită mai întâi înțelegerea imaginii, apelând la cunoștințe și abstractizând structura sa subiacentă.’ articol
perceptual, se intitulează și vine Relațională site alcu un Similitudine Vizuală proiectului (a se vedea videoul încorporat la sfârșitul acestui articol).
Metodă
Cercetătorii au folosit unul dintre cele mai cunoscute seturi de date hiperscalabile ca punct de plecare pentru colecția lor –

Au fost extrase 114.000 de imagini care conțin probabil structuri relationale elastice din LAION-2B, implicând filtrarea multor imagini de calitate scăzută prezente în setul de date minim curat. Pentru a crea o conductă pentru acest proces de selecție, autorii au utilizat Qwen2.5-VL-7B , folosind 1.300de exemple pozitive și 11.000 de exemple negative etichetate de oameni:

Articolul afirmă: Pentru
vreun model relațional, logică sau structură în această imagine care ar putea fi utilă pentru crearea sau legarea de o altă imagine?”. Modelul finetuned obține 93% acord cu judecățile umane, și atunci când este aplicat la LAION-2B, produce N = 114k imagini identificate ca fiind relațional interesante.’ Rezultatele au arătat
a genera etichete relationale, cercetătorii au solicitat modelului Qwen să descrie logica comună din spatele seturilor de imagini fără a numi obiecte specifice. Această abstracție a fost dificil de obținut atunci când modelul a văzut doar o imagine, dar a devenit fezabilă atunci când multiple exemple au demonstrat modelul subiacent. ‘Annotatorii au fost instruiți: “Puteți vedea care grupuri când sunt combinate.corespund diferitelor tipuri de similitudine: unele imagini erau atât relațional, cât și vizual similare, altele împărtășeau logică relațională, dar nu aparență; restul nu a prezentat niciunul dintre acestea. Această analiză sugerează că cele două tipuri de similitudine joacă roluri distincte și oferă o structură mai bogată atunci
Date și Teste
După extragerea caracteristicilor relationale cu Qwen2.5-VL-7B, un model a fost finetuned pe date utilizând LoRA, timp de 15.000 de pași, prin opt A100 GPU*. Pentru partea de text, capționările relationale au fost încorporate utilizând all-MiniLM-L6-v2 din biblioteca Sentence-Transformers . Setul de date de 114.000 de imagini cu capționări a fostîmpărțit în 100.000 pentru antrenare și 14.000 pentru evaluare. Pentru a testa sistemul, a fost utilizată o configurație de recuperare: dată o imagine de întrebare, modelul trebuia să găsească o altă imagine dintr-un set de 28.000 de articole care să exprime aceeași idee relațională. Setul de recuperare a inclus 14.000 de imagini de evaluare și 14.000 de exemple suplimentare din LAION-2B, cu 1.000 de întrebări selectate aleator din setul de evaluare pentru benchmarking. Pentru a evalua calitatea recuperării, GPT-4o a fost utilizat pentru a evalua similitudinea relațională între fiecare imagine de întrebare și imagine recuperată pe o scară de la 0 la 10. Un studiu uman separat a fost efectuat și pentru a evalua preferința utilizatorilor (a se vedea mai jos). Fiecare participant a fost prezentat cu o imagine de întrebare anonimă, împreună cu două candidați, unul recuperat de metoda propusă și celălalt de o bază. Participanții au fost rugați să spună care imagine este mai relațional similară cu imaginea de întrebare, sau dacă ambele sunt la fel de apropiate. Pentru fiecare bază, au fost create 300 de tripleți și evaluate de cel puțin trei persoane, ceea ce a dus la aproximativ 900 de răspunsuri. Abordarea relsim a fost comparată cu mai multe metode de similitudine de imagine stabilite, inclusiv LPIPSși DINO menționateanterior, precum și Două variante de recuperare au fost evaluate, cu CLIP bazat pe recuperarea text-Imagine (CLIP-T) utilizat pentru recuperarea text-Imagine, și Qwen-T utilizând recuperarea text-text. Ambele metode bazate pe capționări au utilizat modelul Qwen preantrenat original, și nu versiunea finetuned pe logică relațională. Acest lucru a permis autorilor să izoleze efectul antrenamentului pe baza grupului, deoarece modelul finetuned fusese expus la seturi de imagini, și nu la exemple izolate. dreamsim și CLIP-I . În plus față de bazele care calculează direct scoruri de similitudine între perechi de imagini, cum ar fi LPIPS, DINO, dreamsim și CLIP-I, autorii au testat și metode bazate pe capționări în care Qwen a fost utilizat pentru a genera o capționare anonimă sau abstractă pentru fiecare imagine; aceasta a servit apoi ca întrebare de recuperare.
Metrici Existente și Similitudine Relațională
Autorii au testat inițial dacă metricile existente ar putea capta similitudinea relațională:

rezultate, autorii afirmă: ‘(LPIPS), care se concentrează
pur pe similitudinea perceptuală, obține cel mai mic scor (4,56). (DINO) performează doar puțin mai bine (5,14), probabil pentru că este antrenat în mod autosuficient pe date de imagine. (CLIP-I) oferă cele mai bune rezultate dintre baze (5,91), probabil pentru că unele abstracții sunt uneori prezente în capționările de imagini. În studiul cu participanți umani, oamenii au preferat constant metoda relsim
noastră, deoarece obținerea unui scor mai bun poate necesita capacitatea de a ajunge la abstracții și mai înalte, cum ar fi cele din capționările anonime.’ Scoruri de similitudine relațională atribuite de GPT-4o pentru
față de toate bazele: ‘Cu toate acestea, CLIP-I tot subperformează în comparație cu metoda

similitudinea relațională și
foarte încurajator, deoarece demonstrează nu numai că modelul nostru, , poate recupera cu succes esteimagini relațional similare, ci și confirmă, din nou, faptul că oamenii percep similitudinea relațională – și nu doar similitudinea de atribut!’ )
cea de atribut pot completa una alta, cercetătorii au utilizat o metodă de visualizare combinată. O singură imagine de întrebare ( relsim ‘Acest lucruatribut: ‘Un câine ținând oa fost comparată cu 3.000 de imagini aleatorii, iar similitudinea a fost calculată utilizând atât modele relationale, cât și de

vizuale. Vă rugăm să consultați articolul sursă pentru o rezoluție mai bună. Rezultatele au arătat grupuri care corespund diferitelor tipuri de similitudine: unele imagini erau atât relațional, cât și vizual similare, altele împărtășeau logică relațională, dar nu aparență; restul nu a prezentat niciunul dintre acestea. Această analiză sugerează că cele două tipuri de similitudine joacă roluri distincte și oferă o structură mai bogată atunci când sunt combinate.
Cazuri de Utilizare
Articolul explorează și câteva posibile cazuri de utilizare pentru similitudinea relațională, inclusiv , care Recuperarea relațională returnează imaginipermite căutarea de imagini mai aliniată cu modul creativ în care oamenii privesc lumea: recuperarea de imagini relationale

diferă. O altă imagine de întrebareposibilitate este , care ar permite sinteza de întrebări care utilizează structuri relationale în loc de descrieri directe. Într-o comparație a rezultatelor obținute de la generația actuală de modele de text-la-imagine de ultimă oră, putem vedea că rezultatele unei astfel de abordări sunt probabil să fie mai diverse: generarea de imagini analogice Dată o

Concluzie
Sistemele generative de inteligență artificială ar fi, pare-se, notabil îmbunătățite prin capacitatea de a incorpora reprezentări abstracte în conceptualizările lor. Așa cum stau lucrurile, solicitarea de imagini bazate pe concepte, cum ar fi “furie” sau “fericire”, are tendința de a returna imagini stilizate din imaginile cele mai populare sau mai numeroase care aveau aceste asocieri în setul de date; ceea ce este memorare mai degrabă decât abstracție. Probabil că acest principiu ar putea fi și mai benefic dacă ar putea fi aplicat la scrierea generativă – în special la outputul analitic, speculativ sau ficțional. (/video) Apăsați pentru a juca. Sursă
* Un A100 avea
poate 40Gb sau 80GB de VRAM; acest lucru nu este specificat în articol. ** Citările autorilor sunt
redundante și excluse. Publicat pentru
prima dată marți, 16 decembrie 2025


