
Modele și platforme AI
Ghid complet pentru fine-tuning-ul modelelor de limbaj mari

De
Aayush Mittal Mittal Adaugă Unite.AI la sursele tale preferate pe Google

Modelele de limbaj mari (LLM) precum GPT-4, LaMDA, PaLM și altele au cucerit lumea cu abilitatea lor remarcabilă de a înțelege și de a genera texte asemănătoare cu cele umane pe o gamă vastă de subiecte. Aceste modele sunt pre-antrenate pe seturi de date masive care cuprind miliarde de cuvinte de pe internet, cărți și alte surse.
Această fază de pre-antrenare îmbibă modelele cu cunoștințe generale extinse despre limbaj, subiecte, abilități de raționament și chiar anumite prejudecăți prezente în datele de antrenare. Cu toate acestea, în ciuda amploarea lor incredibilă, aceste LLM pre-antrenate lipsesc de expertiză specializată pentru domenii sau sarcini specifice.
Aici intervine fine-tuning-ul – procesul de adaptare a unui LLM pre-antrenat pentru a excela într-o anumită aplicație sau sarcină. Prin antrenarea suplimentară a modelului pe un set de date mai mic, specific sarcinii, putem ajusta capacitățile sale pentru a se potrivi cu nuanțele și cerințele acelui domeniu.
Fine-tuning-ul este analog transferului de cunoștințe al unui generalist bine educat pentru a crea un expert într-un anumit domeniu. În acest ghid, vom explora ce este, de ce și cum se face fine-tuning-ul LLM.

Fine-tuning Modele de Limbaj Mari
Ce este Fine-Tuning-ul?
La nivel fundamental, fine-tuning-ul implică luarea unui model pre-antrenat mare și actualizarea parametrilor săi utilizând o a doua fază de antrenare pe un set de date adaptat pentru sarcina sau domeniul țintă. Acest lucru permite modelului să învețe și să interiorizeze nuanțele, modelele și obiectivele specifice acelui domeniu mai restrâns.
În timp ce pre-antrenarea capturează o înțelegere largă a limbajului dintr-un corpus de text imens și divers, fine-tuning-ul specializează această competență generală. Este similar cu transformarea unui om al Renașterii într-un expert într-o industrie.
Greutățile modelului pre-antrenat, care codifică cunoștințele sale generale, sunt folosite ca punct de plecare sau inițializare pentru procesul de fine-tuning. Modelul este apoi antrenat mai departe, dar de data aceasta pe exemple direct relevante pentru aplicația finală.
Prin expunerea modelului la această distribuție de date specializată și ajustarea parametrilor modelului în consecință, facem ca LLM să fie mai precis și mai eficient pentru sarcina țintă, beneficiind în același timp de capacitățile pre-antrenate ca fundament.
De ce Fine-Tuning?
Există mai multe motive cheie pentru care ați dori să faceți fine-tuning-ul unui model de limbaj mare:
- Customizare Domeniu: Fiecare domeniu, de la juridic la medicină și inginerie software, are convențiile sale lingvistice nuanțate, jargon și contexte. Fine-tuning-ul permite personalizarea unui model general pentru a înțelege și a produce texte adaptate domeniului specific.
- Specializare Sarcină: LLM pot fi fine-tune pentru diverse sarcini de procesare a limbajului natural, cum ar fi rezumarea textului, traducerea automată, răspunsul la întrebări etc. Această specializare crește performanța pe sarcina țintă.
- Conformitate cu Datele: Industriile puternic reglementate, cum ar fi sănătatea și finanțele, au cerințe stricte de confidențialitate a datelor. Fine-tuning-ul permite antrenarea LLM pe date proprietare ale organizației, protejând în același timp informațiile sensibile.
- Date Etichetate Limitate: Obținerea unor seturi de date mari etichetate pentru antrenarea modelului de la zero poate fi dificilă. Fine-tuning-ul permite obținerea unei performanțe puternice pe sarcină, chiar și cu exemple supervizate limitate, prin valorificarea capacităților modelului pre-antrenat.
- Actualizarea Modelului: Pe măsură ce apar noi date în timp, într-un anumit domeniu, puteți face fine-tuning-ul modelului pentru a încorpora cunoștințele și capacitățile cele mai recente.
- Mitigarea Prejudecăților: LLM pot prelua prejudecăți societale din datele de antrenare largi. Fine-tuning-ul pe seturi de date curate poate ajuta la reducerea și corectarea acestor prejudecăți nedorite.
În esență, fine-tuning-ul podidește golul dintre un model general, larg, și cerințele focalizate ale unei aplicații specializate. Îmbunătățește acuratețea, siguranța și relevanța ieșirilor modelului pentru sarcini țintă.
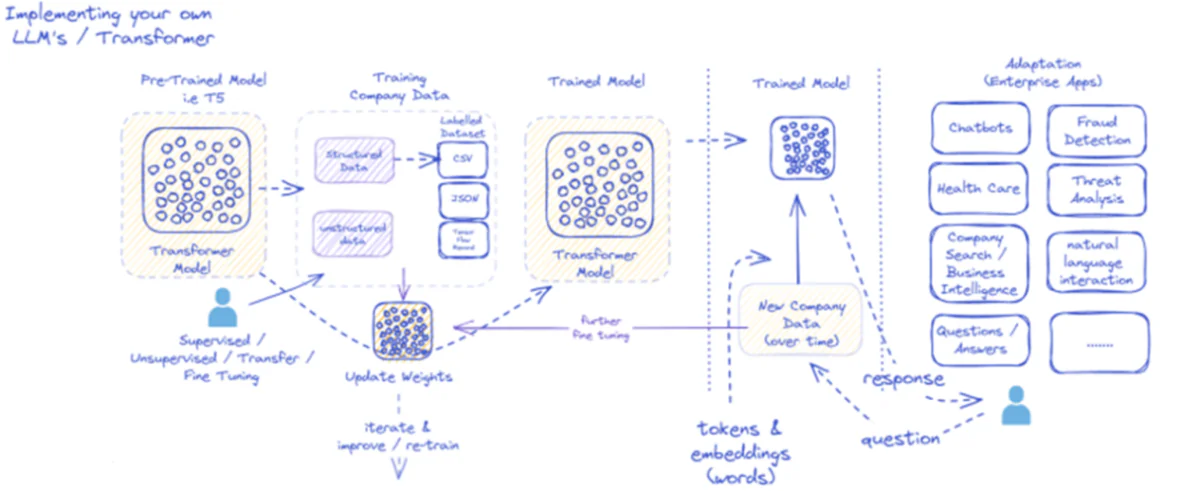
Fine-tuning Modele de Limbaj Mari
Diagrama oferită descrie procesul de implementare și utilizare a modelelor de limbaj mari (LLM) pentru aplicații enterprise. Inițial, un model pre-antrenat, cum ar fi T5, este alimentat cu date structurate și nestructurate ale companiei, care pot veni în diverse formate, cum ar fi CSV sau JSON. Aceste date suferă procese de antrenare supervizate, nesuspervizate sau de transfer, îmbunătățind relevanța modelului pentru nevoile specifice ale companiei.
Odată ce modelul este fine-tune cu datele companiei, greutățile sale sunt actualizate în consecință. Modelul antrenat trece apoi prin cicluri suplimentare de antrenare, îmbunătățind continuu răspunsurile sale pe măsură ce primesc noi date ale companiei. Procesul este iterativ și dinamic, modelul învățând și reantrenându-se pentru a se adapta la evoluția modelelor de date.
Ieșirea acestui model antrenat – tokeni și încorporări reprezentând cuvinte – este apoi implementată pentru diverse aplicații enterprise. Aceste aplicații pot varia de la chatbot-uri la sănătate, fiecare necesitând ca modelul să înțeleagă și să răspundă la întrebări specifice industriei. În finanțe, aplicațiile includ detectarea fraudelor și analiza amenințărilor; în sănătate, modelele pot asista la întrebări ale pacienților și la diagnosticări.
Capacitatea modelului antrenat de a procesa și răspunde la noi date ale companiei pe parcursul timpului asigură că utilitatea sa este menținută și crește. Ca urmare, utilizatorii enterprise pot interacționa cu modelul prin aplicații, punând întrebări și primind răspunsuri informate care reflectă antrenarea și fine-tuning-ul modelului pe date specifice domeniului.
Acestă infrastructură susține o gamă largă de aplicații enterprise, demonstrând versatilitatea și adaptabilitatea LLM atunci când sunt implementate și menținute corespunzător într-un context de afaceri.
Abordări de Fine-Tuning
Există două strategii principale atunci când vine vorba de fine-tuning-ul modelelor de limbaj mari:
1) Fine-Tuning Completa Modelului
În abordarea de fine-tuning complet, toți parametrii (greutăți și bias) ai modelului pre-antrenat sunt actualizați în timpul celei de-a doua faze de antrenare. Modelul este expus la setul de date etichetate specific sarcinii, iar procesul standard de antrenare optimizează întregul model pentru acea distribuție de date.
Acest lucru permite modelului să facă ajustări mai cuprinzătoare și să se adapteze holistic la sarcina sau domeniul țintă. Cu toate acestea, fine-tuning-ul complet are și unele dezavantaje:
- Necesită resurse computaționale semnificative și timp pentru antrenare, asemănător cu faza de pre-antrenare.
- Cerințele de stocare sunt ridicate, deoarece trebuie să mențineți o copie separată a modelului fine-tune pentru fiecare sarcină.
- Există riscul de “uitare catastrofică”, în care fine-tuning-ul cauzează modelului să piardă unele dintre capacitățile generale învățate în timpul pre-antrenării.
În ciuda acestor limitări, fine-tuning-ul complet rămâne o tehnică puternică și larg utilizată atunci când resursele permit și sarcina țintă se abate semnificativ de la limbajul general.
2) Metode Eficiente de Fine-Tuning
Pentru a depăși provocările computaționale ale fine-tuning-ului complet, cercetătorii au dezvoltat strategii eficiente care actualizează doar un subset mic de parametri ai modelului în timpul fine-tuning-ului. Aceste tehnici parametric eficiente echilibrează specializarea și reducerea cerințelor de resurse.
Unele metode populare de fine-tuning eficient includ:
Prefix-Tuning: Aici, un număr mic de vectori sau “prefixe” specifici sarcinii sunt introduși și antrenați pentru a condiționa atenția modelului pre-antrenat pentru sarcina țintă. Doar aceste prefixe sunt actualizate în timpul fine-tuning-ului.
LoRA (Low-Rank Adaptation): LoRA injectează matrice low-rank antrenabile în fiecare strat al modelului pre-antrenat în timpul fine-tuning-ului. Aceste ajustări low-rank ajută la specializarea modelului cu mult mai puțini parametri antrenabili decât fine-tuning-ul complet.
Da, pot oferi o explicație detaliată a LoRA (Low-Rank Adaptation) împreună cu formularea matematică și exemple de cod. LoRA este o tehnică populară de fine-tuning parametric eficient (PEFT) care a câștigat o tracțiune semnificativă în domeniul adaptării modelelor de limbaj mari (LLM).
Ce este LoRA?
LoRA este o metodă de fine-tuning care introduce un număr mic de parametri antrenabili în modelul pre-antrenat, permițând o adaptare eficientă la sarcini downstream, păstrând în același timp majoritatea cunoștințelor originale ale modelului. În loc de a face fine-tuning-ul tuturor parametrilor LLM, LoRA injectează matrice low-rank specifice sarcinii în straturile modelului, permițând economii semnificative de calcul și memorie în timpul procesului de fine-tuning.
Formularea Matematică
LoRA (Low-Rank Adaptation) este o metodă de fine-tuning pentru modele de limbaj mari (LLM) care introduce o actualizare low-rank a matricelor de greutate. Pentru o matrice de greutate 0∈W0∈Rd×k, LoRA adaugă o matrice low-rank BA, cu A∈Rr×k și B∈Rd×r, unde r este rangul. Această abordare reduce semnificativ numărul de parametri antrenabili, permițând o adaptare eficientă la sarcini downstream cu resurse computaționale minime. Matricea de greutate actualizată este dată de W=W0+B⋅A.
Această actualizare low-rank poate fi interpretată ca o modificare a matricei de greutate originală $W_{0}$ prin adăugarea unei matrice low-rank $BA$. Avantajul cheie al acestei formulări este că, în loc de a actualiza toți $d \times k$ parametri în $W_{0}$, LoRA necesită doar optimizarea a $r \times (d + k)$ parametri în $A$ și $B$, reducând semnificativ numărul de parametri antrenabili.
Iată un exemplu în Python, folosind biblioteca peft pentru a aplica LoRA la un LLM pre-antrenat pentru clasificarea textului:
</div>
<div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color="">from</span> transformers <span class="token" data-darkreader-inline-color="">import</span> AutoModelForSequenceClassification
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color="">from</span> peft <span class="token" data-darkreader-inline-color="">import</span> get_peft_model<span class="token" data-darkreader-inline-color="">,</span> LoraConfig<span class="token" data-darkreader-inline-color="">,</span> TaskType
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Încărcarea modelului pre-antrenat</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">model <span class="token" data-darkreader-inline-color="">=</span> AutoModelForSequenceClassification<span class="token" data-darkreader-inline-color="">.</span>from_pretrained<span class="token" data-darkreader-inline-color="">(</span><span class="token" data-darkreader-inline-color="">"bert-base-uncased"</span><span class="token" data-darkreader-inline-color="">,</span> num_labels<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">2</span><span class="token" data-darkreader-inline-color="">)</span>
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Definirea configurării LoRA</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">peft_config <span class="token" data-darkreader-inline-color="">=</span> LoraConfig<span class="token" data-darkreader-inline-color="">(</span>task_type<span class="token" data-darkreader-inline-color="">=</span>TaskType<span class="token" data-darkreader-inline-color="">.</span>SEQ_CLS<span class="token" data-darkreader-inline-color="">, </span>r<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">8</span><span class="token" data-darkreader-inline-color="">,</span> <span class="token" data-darkreader-inline-color=""># Rangul actualizării low-rank</span>
lora_alpha<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">16</span><span class="token" data-darkreader-inline-color="">,</span></code><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Factor de scalare pentru actualizarea low-rank</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""> target_modules<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">[</span><span class="token" data-darkreader-inline-color="">"q_lin"</span><span class="token" data-darkreader-inline-color="">,</span> <span class="token" data-darkreader-inline-color="">"v_lin"</span><span class="token" data-darkreader-inline-color="">]</span><span class="token" data-darkreader-inline-color="">,</span> <span class="token" data-darkreader-inline-color=""># Aplicarea LoRA pe straturile de întrebare și valoare</span>
<span class="token" data-darkreader-inline-color="">)</span>
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Crearea modelului LoRA</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">model <span class="token" data-darkreader-inline-color="">=</span> get_peft_model<span class="token" data-darkreader-inline-color="">(</span>model<span class="token" data-darkreader-inline-color="">,</span> peft_config<span class="token" data-darkreader-inline-color="">)</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Fine-tuning-ul modelului cu LoRA</span>
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># ... (codul de antrenare este omis pentru concizie)</span></code></div>
</div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">
În acest exemplu, încărcăm un model pre-antrenat BERT pentru clasificarea secvențială și definim o configurare LoRA. Parametrul r specifică rangul actualizării low-rank, iar lora_alpha este un factor de scalare pentru actualizarea. Parametrul target_modules indică care straturi ale modelului ar trebui să primească actualizările low-rank. După crearea modelului LoRA, putem continua cu procesul de fine-tuning utilizând procedura standard de antrenare.
Straturi de Adaptare: Asemănător cu LoRA, dar în loc de actualizări low-rank, straturi subțiri “de adaptare” sunt inserate în interiorul fiecărui bloc de transformator al modelului pre-antrenat. Doar parametrii acestor câteva straturi compacte noi sunt antrenați.
Reglarea Prompt-ului: Această abordare ține modelul pre-antrenat complet înghețat. În schimb, sunt introduse încorporări “prompt” antrenabile ca intrare pentru a activa cunoștințele pre-antrenate ale modelului pentru sarcina țintă.
Aceste metode eficiente pot oferi reduceri de până la 100 de ori ale calculului în comparație cu fine-tuning-ul complet, menținând în același timp performanțe competitive pe multe sarcini. Ele reduc, de asemenea, nevoile de stocare, evitând duplicarea completă a modelului.
Cu toate acestea, performanța lor poate fi în urma fine-tuning-ului complet pentru sarcini care sunt foarte diferite de limbajul general sau care necesită o specializare mai holistică.
Procesul de Fine-Tuning
Indiferent de strategia de fine-tuning, procesul general pentru specializarea unui LLM urmează un cadru standard:
- Pregătirea Datelor: Veți avea nevoie să obțineți sau să creați un set de date etichetate care să asocieze intrări (prompt-uri) cu ieșiri dorite pentru sarcina dvs. țintă. Pentru sarcini de generare de texte, cum ar fi rezumarea, aceasta ar fi perechi de texte de intrare și rezumate.
- Împărțirea Datelor: Urmând cele mai bune practici, împărțiți setul dvs. de date etichetate în seturi de antrenare, validare și testare. Acest lucru separă datele pentru antrenarea modelului, reglarea hiperparametrilor și evaluarea finală.
- Reglarea Hiperparametrilor: Parametri precum rata de învățare, dimensiunea lotului și programul de antrenare trebuie reglați pentru fine-tuning-ul cel mai eficient pe datele dvs. Acest lucru implică, de obicei, un set mic de validare.
- Antrenarea Modelului: Utilizând hiperparametrii reglați, rulați procesul de optimizare a fine-tuning-ului pe setul complet de antrenare până când performanța modelului pe setul de validare încetează să se îmbunătățească (oprirea timpurie).
- Evaluarea: Evaluați performanța modelului fine-tune pe setul de testare separat, ideal compus din exemple din lumea reală pentru sarcina țintă, pentru a estima eficacitatea în lumea reală.
- Implementarea și Monitorizarea: Odată ce este satisfăcător, modelul fine-tune poate fi implementat pentru inferență pe intrări noi. Este crucial să monitorizați performanța și acuratețea sa pe parcursul timpului pentru a detecta derivarea conceptului.
Deși acest lucru descrie procesul general, multe nuanțe pot afecta succesul fine-tuning-ului pentru un anumit LLM sau sarcină. Strategii precum învățarea curriculum, fine-tuning-ul multi-sarcină și promptarea cu puține exemple pot îmbunătăți și mai mult performanța.
În plus, metodele eficiente de fine-tuning implică considerații suplimentare. De exemplu, LoRA necesită tehnici precum condiționarea ieșirilor modelului pre-antrenat prin intermediul unui strat de combinare. Reglarea prompt-ului necesită proiectarea atentă a prompt-urilor pentru a activa comportamentele corecte.
Fine-Tuning Avansat: Incorporarea Feedback-ului Uman
În timp ce fine-tuning-ul standard utilizând seturi de date etichetate este eficient, o frontieră interesantă este antrenarea LLM direct utilizând preferințele și feedback-ul uman. Această abordare “om în buclă” utilizează tehnici din învățarea prin întărire:
PPO (Optimizarea Proximală a Politicii): Aici, LLM este tratat ca un agent de învățare prin întărire, cu ieșirile sale fiind “acțiuni”. Un model de recompensă este antrenat pentru a prezice ratinguri umane sau scoruri de calitate pentru aceste ieșiri. PPO optimizează apoi LLM pentru a genera ieșiri care maximizează scorurile modelului de recompensă.
RLHF (Învățarea prin Întărire din Feedback-Uman): Aceasta extinde PPO prin incorporarea directă a feedback-ului uman în procesul de învățare. În loc de un model de recompensă fix, recompensele vin din evaluări umane iterative ale ieșirilor LLM pe parcursul fine-tuning-ului.
Deși computațional intensiv, aceste metode permit modelări mai precise ale comportamentului LLM pe baza caracteristicilor dorite evaluate de oameni, dincolo de ceea ce poate fi capturat într-un set de date static.
Companii precum Anthropic au utilizat RLHF pentru a îmbunătăți modelele lor de limbaj, cum ar fi Claude, cu adevăr, etică și conștientizare a siguranței, dincolo de competența sarcinii.
Riscuri și Limitări Potențiale
În timp ce sunt extrem de puternice, fine-tuning-ul LLM implică riscuri care trebuie gestionate cu atenție:
Amplificarea Prejudecăților: Dacă datele de fine-tuning conțin prejudecăți societale legate de gen, rasă, vârstă sau alte atribute, modelul poate amplifica aceste prejudecăți nedorite. Curățarea seturilor de date reprezentative și lipsite de prejudecăți este crucială.
Derivarea Faptică: Chiar și după fine-tuning pe date de înaltă calitate, modelele de limbaj pot “halucina” fapte incorecte sau ieșiri incompatibile cu exemplele de antrenare pe parcursul conversațiilor mai lungi sau a prompt-urilor. Metode de recuperare a faptelor pot fi necesare.
Provocări de Scalabilitate: Fine-tuning-ul complet al unor modele uriașe, cum ar fi GPT-3, necesită resurse computaționale imense care pot fi inaccesibile pentru multe organizații. Metodele eficiente de fine-tuning atenuează parțial această problemă, dar au compromisuri.
Uitarea Catastrofică: În timpul fine-tuning-ului complet, modelele pot experimenta uitarea catastrofică, în care pierd unele dintre capacitățile generale învățate în timpul pre-antrenării. Învățarea multi-sarcină poate fi necesară.
Riscuri de Proprietate Intelectuală și Confidențialitate: Datele proprietare utilizate pentru fine-tuning pot fi divulgate în ieșirile modelului de limbaj publicat, reprezentând riscuri. Tehnici de confidențialitate diferențiată și de atenuare a pericolelor informaționale sunt domenii active de cercetare.
În general, deși sunt extrem de utile, fine-tuning-ul necesită atenție la calitatea datelor, considerații de identitate, mitigarea riscurilor și echilibrarea compromisurilor de performanță și eficiență, în funcție de cerințele sarcinii.
Viitorul: Personalizarea Modelului de Limbaj la Scară
Privind spre viitor, progresele în fine-tuning și tehnici de adaptare a modelului vor fi cruciale pentru deblocarea potențialului complet al modelelor de limbaj mari în diverse aplicații și domenii.
Metode mai eficiente care permit fine-tuning-ul chiar și a unor modele mai mari, cum ar fi PaLM, cu resurse limitate, ar putea democratiza accesul. Automatizarea pipeline-urilor de creare a seturilor de date și ingineria prompt-urilor ar putea simplifica specializarea.
Tehnici de auto-antrenare pentru a face fine-tuning-ul din date brute fără etichete ar putea deschide noi frontiere. Abordări compozite pentru a combina sub-modele fine-tune antrenate pe sarcini sau seturi de date diferite ar putea permite construirea de modele puternic personalizate la cerere.
În cele din urmă, pe măsură ce LLM devin mai omniprezente, capacitatea de a le personaliza și specializa în mod fluent pentru fiecare caz de utilizare imaginabil va fi critică. Fine-tuning-ul și strategiile de adaptare a modelului sunt pași cheie în realizarea viziunii modelelor de limbaj mari ca asistenți AI flexibili, siguri și puternici care sporesc capacitățile umane în fiecare domeniu și întreprindere.
Am petrecut ultimii cinci ani scufundându-mă în lumea fascinantă a Machine Learning și Deep Learning. Pasinea și expertiza mea m-au condus să contribui la peste 50 de proiecte diverse de inginerie software, cu un focus deosebit pe AI/ML. Curiozitatea mea în continuare m-a atras și spre Natural Language Processing, un domeniu pe care sunt dornic să îl explorez mai departe.

Descoperă mai multe


Laboratoarele au dovedit că Cutia de nisip a agentului dvs. este doar o sugestie


New York a transformat lupta reală a inteligenței artificiale într-o luptă pentru utilizarea terenurilor


De ce agenții AI trec testele de calificare și totuși eşuează în producție


Cel mai bun model OpenAI a fost lansat în spatele unei porți guvernamentale


Delincvența IA din cauza suprainstruirii, nu a finisării, arată cercetarea

Laboratorul Thinking Machines lansează primul model cu interacțiune în timp real de 200ms


