
Fundamentele AI
Ce este recunoașterea vocală conversațională (CSR)?

 Adaugă Unite.AI la sursele tale preferate pe Google
Recunoașterea vocală conversațională (CSR) extinde recunoașterea automată a vorbirii dincolo de transcrierea izolată prin utilizarea contextului dialogic, semnalelor de preluare a cuvântului, informațiilor despre vorbitor și procesării cu latență redusă. Scopul este de a susține o interacțiune în timp real în care cuvintele, sincronizarea, întreruperile și schimburile anterioare contează.
CSR este o etichetă emergentă de produs și cercetare, nu o clasă de model standardizată. Un sistem puternic combină ASR în flux cu delimitarea finalului, gestionarea vorbitorului, modelarea lingvistică contextuală, starea dialogului și o politică de răspuns, apoi evaluează experiența de la cap la cap.
Puncte cheie
- Recunoașterea în flux emite ipoteze provizorii și le revizuiește pe măsură ce ajunge mai mult audio.
- Delimitarea finalului și prezicerea schimbului sunt separate de acuratețea transcrierii.
- Istoricul conversației și cuvintele cheie pot îmbunătăți recunoașterea, dar pot și propaga erorile anterioare.
- Evaluați latența, întreruperile, vorbitorii, accentele, zgomotul, confidențialitatea și finalizarea sarcinii — nu doar rata de eroare a cuvintelor.
De la ASR la dialog în timp real
ASR tradițional ASR transformă audio în text. Un sistem conversațional trebuie să decidă când să asculte, când un schimb este complet, dacă vorbirea este adresată sistemului și cum să recupereze când transcrierea sau răspunsul său este greșit.
Modelele în flux procesează cadre incremental și produc transcrieri parțiale. Latența scăzută îmbunătățește receptivitatea, dar angajamentul prematur poate crește revizuirile sau erorile. Aplicația are nevoie de o politică pentru text stabil versus provizoriu.
Preluarea cuvântului, suprapunerea și vorbitorii
Durata tăcerii singură este un semnal slab de delimitare a finalului. Finalizarea lexicală, prosodia, sincronizarea, privirea și starea dialogului pot ajuta la prezicerea dacă o persoană deține sau cedează cuvântul. Intervenția (Barge-in) permite utilizatorului să întrerupă vorbirea sintetizată fără a pierde contextul.
Vocile suprapuse și diarizarea rămân dificile. Sistemele ar trebui să păstreze incertitudinea vorbitorului, să evite atribuirea unei afirmații persoanei greșite și să ofere o cale de corecție — în special pentru înregistrări utilizate în sănătate, finanțe sau activități juridice.
Recunoaștere contextuală
Schimburile anterioare pot clarifica nume și referințe; listele de cuvinte cheie pot influența recunoașterea spre termeni de domeniu. Modelele de limbaj vocal pot codifica contextul audio și textual într-un cadru comun de prompting sau atenție.
Contextul poate, de asemenea, să consolideze o transcriere greșită anterioară sau să scurgă informații între sesiuni. Limitați istoricul la scopul curent, separați metadatele de încredere de vorbirea utilizatorului și folosiți context transformer cu reguli explicite de retenție și acces.
Evaluare și implementare responsabilă
Raportați rata de eroare a cuvintelor în flux, latența primului token și a finalizării, rata de revizuire, erorile de delimitare, succesul intervenției, atribuirea vorbitorului și finalizarea sarcinii. Testați microfoane reale, zgomot, accente, schimb de cod, dizabilități și vorbire încărcată emoțional.
Datele vocale pot identifica sau dezvălui informații sensibile. Aplicați consimțământ, minimizare, criptare, limite de retenție și revizuire umană. Conectați răspunsurile generate la controalele de siguranță ale chatbot, deoarece o transcriere precisă nu face ca un răspuns să fie corect sau autorizat.
De la intrarea acustică la starea conversațională
Un sistem de vorbire conversațională captează audio, aplică condiționarea semnalului, detectează vorbirea, recunoaște cuvinte sau unități semantice, identifică vorbitorii când este necesar și actualizează starea dialogului. Sistemele în flux produc ipoteze parțiale înainte ca enunțul să se încheie. Aceste ipoteze pot să se schimbe, astfel încât componentele ulterioare trebuie să distingă rezultatele provizorii de cele finale.
Detectarea activității vocale și delimitarea finalului decid când începe vorbirea și când utilizatorul a terminat. Pragurile fixe de tăcere eșuează la vorbitori lenți, zgomot de fond și pauze de gândire. Modelele de preluare a cuvântului pot folosi cuvinte, prosodie, privire și context dialogic, dar trebuie să echilibreze răspunsul rapid cu întreruperea vorbitorului.
Diarizarea răspunde la întrebarea cine a vorbit când; recunoașterea vorbitorului estimează identitatea; separarea sursei izolează vocile suprapuse. Acestea sunt sarcini diferite cu riscuri diferite. În întâlniri, sănătate și servicii pentru clienți, atribuirea cuvintelor corecte persoanei corecte poate conta la fel de mult ca rata de eroare a cuvintelor din transcriere.
Context, suprapunere, emoție și recuperarea interacțiunii
Contextul conversațional rezolvă pronumele, elipsa, corecțiile, termeni de domeniu și referințele la schimburile anterioare. Un sistem poate combina dovezile acustice cu istoricul dialogului și cunoștințele recuperate, dar contextul anterior poate, de asemenea, să influențeze recunoașterea spre o așteptare incorectă. Păstrați dovezile audio și încrederea astfel încât contextul să nu suprascrie în tăcere incertitudinea.
Dialogul natural include canale de răspuns, întreruperi, începuturi false, râsete, schimb de cod și vorbire simultană. Un agent receptiv are nevoie de gestionarea intervenției: opri sau reduce ieșirea, captura noua vorbire a utilizatorului, decide dacă întreruperea schimbă intenția și recupera fără a duplica sau pierde o acțiune.
Prosodia și semnalele paralingvistice pot indica accentuare sau incertitudine, dar inferența emoției, sănătății sau intenției din voce este predispusă la erori și depinde cultural. Folosiți astfel de estimări cu prudență, dezvăluiți-le unde este potrivit și nu luați decizii consecvente bazate pe o etichetă emoțională neverificată.
Evaluare, confidențialitate și proiectare pentru producție
Rata de eroare a cuvintelor rămâne utilă, dar evaluarea conversațională ar trebui să măsoare și atribuirea vorbitorului, acuratețea entităților, succesul sarcinii semantice, stabilitatea ipotezelor parțiale, latența de delimitare, succesul întreruperii, recuperarea și rata de corecție a utilizatorului. Segmentați pe accent, limbă, dispozitiv, zgomot, suprapunere, stil de vorbire și condiții de rețea.
Arhitectura în flux necesită buffer-e limitate, presiune înapoi, reconectare, numere de secvență și finalizare explicită. Păstrați bugetele de latență ale modelului și ale dialogului separate, urmăriți fiecare etapă și testați rețelele degradate. Când un sistem declanșează acțiuni, confirmați intenția cu impact ridicat și faceți încercările de reîncercare idempotente, astfel încât audio repetat sau reconectările să nu duplicateze tranzacțiile.
Vorbirea conține identitate, conținut, mediu și informații despre spectatori. Minimizați retenția, criptați transportul și stocarea, controlați accesul, definiți ștergerea și distingeți audio de transcrierile și încorporările derivate. Oferiți indicatoare vizibile de înregistrare și alternative când consimțământul lipsește. Un model local poate reduce transferul, dar necesită în continuare permisiune și controale de ciclu de viață.
Exemplu practic: un agent vocal care gestionează întreruperea și corecția
Un apelant spune, „Rezervă marți — nu, miercuri după-amiaza”, în timp ce agentul începe să răspundă după „marți”. Recunoașterea în flux emite transcrieri parțiale în schimbare, delimitarea finalului detectează vorbirea continuă, iar intervenția oprește ieșirea. Starea dialogului marchează data anterioară ca suprascrisă în loc să creeze două cereri. Confirmarea entității se concentrează pe data și ora corectate, în timp ce sistemul păstrează încrederea și dovezile pentru interpretarea finală.
Arhitectura separă captarea audio, detectarea vorbirii, recunoașterea în flux, gestionarea vorbitorului, politica dialogului, execuția instrumentului și sinteza. Numerele de secvență și finalizarea împiedică rezultatele parțiale târzii să suprascrie transcrierea finală. Instrumentul de rezervare acceptă o cerere structurată, verifică autorizarea și disponibilitatea și folosește o cheie de idempotentă. O rezervare consecventă este citită înapoi și confirmată înainte de execuție; o reconectare nu poate repeta în tăcere.
Testarea combină acuratețea cuvintelor și a entităților cu latența de delimitare, succesul întreruperii, gestionarea corecției, atribuirea vorbitorului, finalizarea sarcinii și rata de acțiuni duplicate. Scenariile acoperă zgomot, suprapunere, accente, schimb de cod, vorbire lentă, dispozitive asistive, rețele slabe și atacuri sintetice. Retenția audio este minimizată și divulgată, datele despre spectatori sunt gestionate explicit, iar utilizatorii pot trece la text sau la un om. Inteligența conversațională este măsurată prin recuperare sigură și rezultat, nu doar prin acuratețea transcrierii.
Listă de verificare pentru implementare practică
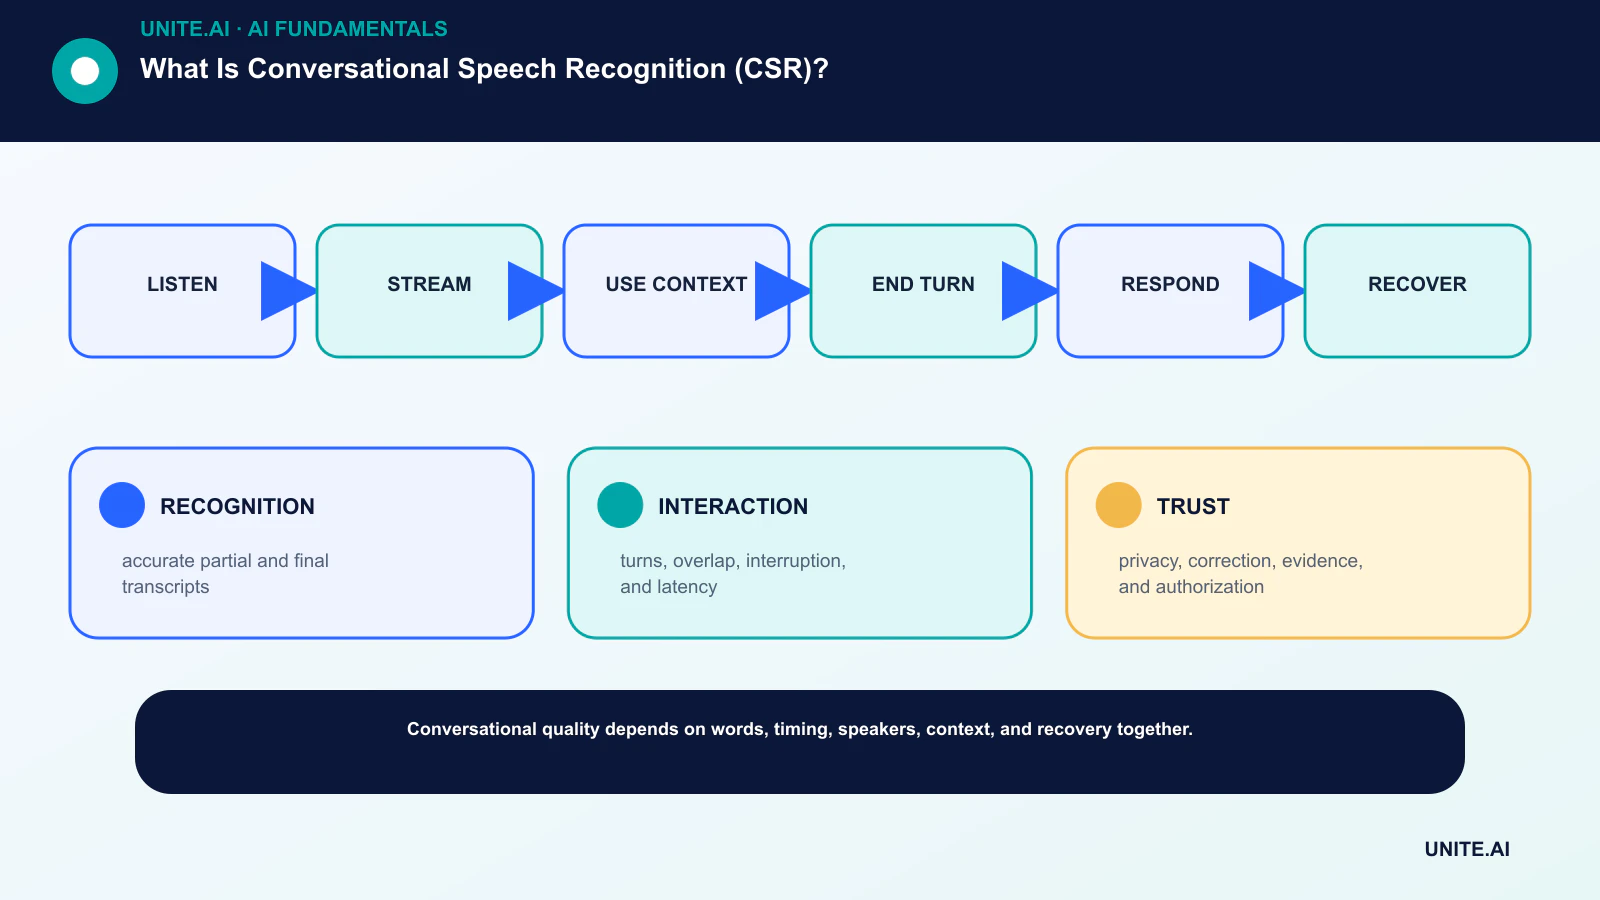
Transformați conceptul într-un flux de lucru limitat și testabil: ascultați → flux → folosiți contextul → încheiați schimbul → răspundeți → recuperați. Stabiliți un responsabil, documentați datele și dependențele, creați un punct de referință simplu, definiți criterii de acceptare și oprire, testați eșecuri reprezentative și definiți monitorizarea, revenirea și revizuirea înainte de a extinde domeniul. Înregistrați versiunile și presupunerile astfel încât o altă echipă să poată reproduce rezultatul și să înțeleagă ce s‑a modificat.
Înainte de lansare, efectuați o revizuire de pregătire documentată cu persoanele care construiesc, operează, securizează și sunt afectate de sistem. Testați cazuri normale, condiții limită, eșecuri de dependență și utilizări incorecte; păstrați dovezile și riscurile nerezolvate. Definiți cine poate aproba lansarea, modifica un prag, anula o ieșire sau opri funcționarea. Reevaluați decizia după ce sosesc date din lumea reală, deoarece un pilot tehnic de succes nu garantează performanță fiabilă la scară mai largă.
- RECONEȘTERE: transcrieri parțiale și finale precise.
- INTERACȚIE: schimburi, suprapuneri, întreruperi și latență.
- ÎNCREDERE: confidențialitate, corecție, dovezi și autorizare.
Întrebări frecvente
Este CSR diferit de ASR?
ASR este componenta de conversie vorbire‑text. CSR folosește ASR plus context dialogic, sincronizare, vorbitor și gestionarea delimitării, și politici de interacțiune pentru conversații în timp real.
Un nivel mai scăzut al ratei de eroare a cuvintelor garantează un agent vocal mai bun?
Nu. Un sistem poate transcrie cu acuratețe, dar să întrerupă utilizatorii, să răspundă lent, să atribuie greșit vorbitorii sau să ia o acțiune greșită. Sunt necesare metrici de interacțiune de la cap la cap.
Referințe principale












