
Entrevistas
Zaid Al Hamani, CEO e Fundador da Boost Security – Série de Entrevistas

 Adicione Unite.AI às suas fontes preferidas no Google
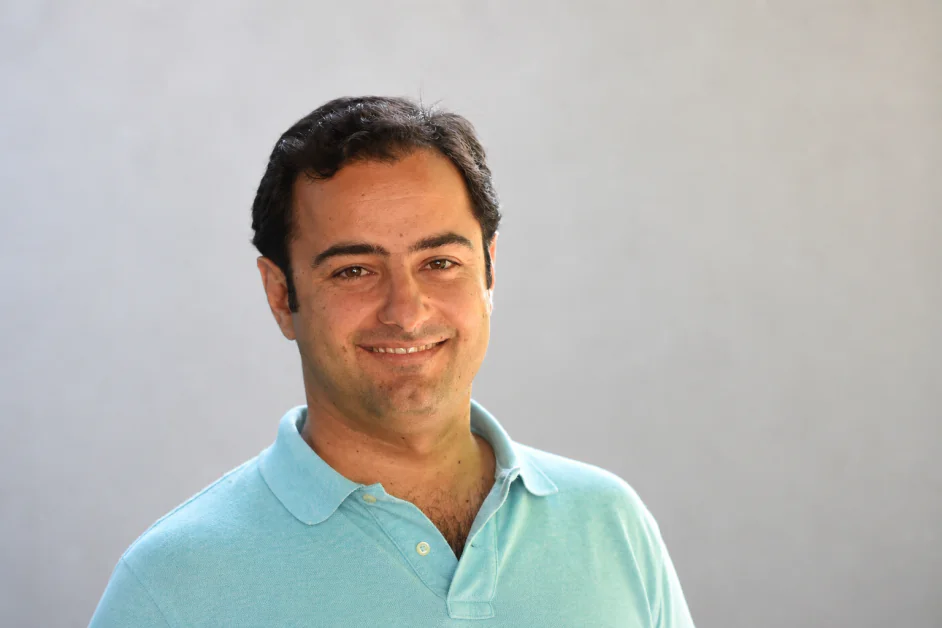
Zaid Al Hamani, CEO e Fundador da Boost Security, é um líder em cibersegurança e DevSecOps com mais de duas décadas de experiência em construir e expandir operações tecnológicas globais. Desde a fundação da Boost Security em 2020, ele se concentrou em modernizar a forma como as organizações protegem o desenvolvimento de software, aproveitando funções anteriores, incluindo VP de Segurança de Aplicativos na Trend Micro e Co-Fundador/CEO da IMMUNIO. Anteriormente, ele ocupou cargos de liderança sênior na Canonical, liderando iniciativas de produto, engenharia e suporte global, e na SITA, onde gerenciou operações de TI em larga escala e críticas. Sua carreira reflete um forte histórico de construir equipes, otimizar sistemas e promover práticas de segurança modernas.
Boost Security é uma empresa de cibersegurança focada em proteger a cadeia de suprimentos de software moderna por meio de uma plataforma DevSecOps orientada ao desenvolvedor. Sua tecnologia se integra diretamente aos pipelines de CI/CD para detectar, priorizar e remediar automaticamente vulnerabilidades, reduzindo a sobrecarga manual enquanto mantém a velocidade de desenvolvimento. Ao unificar a segurança de aplicativos e a segurança da cadeia de suprimentos em um único sistema, a plataforma fornece visibilidade completa em código, dependências e infraestrutura, ajudando as organizações a fortalecer a resiliência em ambientes complexos e nativos em nuvem.
Você liderou anteriormente a segurança de aplicativos na Trend Micro e co-fundou a IMMUNIO. O que o levou a fundar a Boost Security, e qual foi a lacuna no mercado que você estava posicionado para identificar cedo?
A IMMUN.IO foi uma das primeiras empresas de RASP a ser fundada – e nossa experiência até esse ponto foi que os WAFs como tecnologia de segurança em tempo de execução eram impossíveis de manter e não muito eficazes. Nós imaginamos uma maneira de os WAFs serem substituídos por uma solução mais precisa e fácil de manter – instrumentando o aplicativo.
Isso foi em 2012, o DevOps ainda estava em seus primórdios, a maioria das equipes não era Ágil, e o Kubernetes ainda não existia.
A Trend Micro adquiriu a IMMUN.IO em 2017. Nessa época, havia mais práticas de DevOps: pipelines de CI/CD, práticas de desenvolvimento Ágil, ciclos de iteração e lançamento mais rápidos, nuvem, etc. As equipes de desenvolvimento de software estavam melhores em construir software e enviá-lo mais rápido. A segurança ainda estava quebrada, no entanto:
- As varreduras são muito lentas, ou os resultados chegam muito tarde
- Os resultados são muito complexos para os desenvolvedores agirem
- Havia uma taxa de falsos positivos geralmente inaceitável
- Muitos novos tipos de artefatos não eram varridos: infraestrutura como código, contêineres, APIs, por exemplo
Produzir software rapidamente era mais fácil. Produzir software seguro rapidamente ainda era difícil.
Essa foi o problema original que nos propusemos a resolver. Fazer o DevSecOps funcionar no mundo real; você consegue fazer com que uma equipe de desenvolvimento de software adicione facilmente segurança ao SDLC, a uma velocidade que atenda aos novos padrões de velocidade? Você consegue torná-lo amplo – onde uma plataforma é tudo o que você precisa? Você consegue fazer com que os desenvolvedores, não apenas adotem a tecnologia, mas a abracem e vejam os benefícios? Você consegue fazer com que isso escale para que você não precise de exércitos de profissionais de segurança para acompanhar a quantidade de código escrito…
Nós ajudamos as empresas a injetar segurança no SDLC durante a era do DevOps. Isso foi ir de 1 a 10. Agora estamos na era do codificação agente – onde os agentes escrevem uma enorme quantidade de código – mas é fundamentalmente o mesmo problema – velocidade e volume de código apenas mudaram de 10 para 100; e visamos continuar a mesma trajetória.
Você argumentou que o ciclo de vida de desenvolvimento de software (SDLC) mudou fundamentalmente para cima. Qual foi o momento em que você percebeu que as abordagens tradicionais de DevSecOps não eram mais suficientes?
Foi assistir a como os atacantes estavam realmente entrando. Nós continuávamos vendo o mesmo padrão: um fluxo de trabalho do GitHub Actions exposto que ninguém havia revisado desde que o repositório foi bifurcado, um token com acesso de produção à nuvem incorporado em uma configuração de runner, um trabalho de CI legítimo sequestrado para implantar payloads de atacantes. Esses se tornaram conhecidos como ataques “vivendo do pipeline”, porque o adversário usa sua própria automação contra você, com credenciais que sua equipe de segurança já aprovou.
A pilha de DevSecOps que havíamos construído ao longo de uma década não tinha resposta para isso. A varredura SAST verifica o código-fonte do aplicativo. A varredura SCA verifica as dependências do aplicativo. Ambas assumem que o pipeline que as executa é confiável. Enquanto isso, o próprio pipeline é um arquivo YAML com comandos de shell, acesso de rede e credenciais sensíveis, e quase ninguém o revisa.
Quando isso se torna o caminho de menor resistência, você pode enviar código limpo perfeito e ainda assim entregar aos atacantes sua nuvem.
Como as empresas devem repensar o SDLC em um mundo onde os agentes de IA estão gerando código continuamente, em vez de os desenvolvedores escreverem passo a passo?
Nós todos temos que parar de pensar no SDLC como uma sequência de pontos de verificação. Os agentes de IA colapsaram o tempo entre “alguém escreveu isso” e “isso está em produção” de semanas para minutos. O modelo antigo supunha um ritmo humano entre revisão de código, SAST, SCA e implantação, mas estamos além disso agora.
A segurança tem que viver onde o agente opera: na máquina do desenvolvedor, dentro do contexto do prompt, nas conexões do agente com os servidores MCP e modelos externos. No momento em que o código atinge o pipeline, você já perdeu a chance de moldá-lo. O agente já puxou a dependência. O modelo já viu a credencial. Mova os controles para cima, para onde o trabalho realmente acontece.
Muitas organizações ainda tratam as ferramentas de codificação de IA como simples camadas de produtividade. Por que você acredita que elas representam uma superfície de ataque completamente nova, em vez de apenas uma extensão dos fluxos de trabalho existentes?
Tratar uma ferramenta de codificação de IA como uma camada de produtividade é como tratar um desenvolvedor júnior com acesso de root como uma camada de produtividade. O rótulo é tecnicamente preciso, mas não fornece nenhum quadro útil para pensar sobre o que pode dar errado.
Um agente de codificação lê seu sistema de arquivos, raspa variáveis de ambiente para contexto, busca dependências de registros públicos, abre conexões de saída para provedores de modelos remotos e servidores MCP e executa comandos de shell. Cada uma dessas ações costumava exigir um humano no loop. Agora elas acontecem em milissegundos, com os mesmos privilégios do desenvolvedor que lançou o agente.
Essa fusão funde limites de confiança que costumavam ser separados: a autoridade do desenvolvedor, o que uma ferramenta externa pode buscar e o que o código não confiável pode executar. Isso cria novas oportunidades para atacantes e pontos cegos que os defensores não podem ver, muito menos defender.
A Boost Security define o laptop do desenvolvedor como o novo plano de controle. Quais riscos existem no endpoint que as equipes de segurança estão atualmente desprezando?
O maior deles é o inventário. A maioria das equipes de segurança não consegue dizer quais agentes de IA estão executando em quais laptops, quais servidores MCP esses agentes estão conectados ou quais extensões de IDE estão raspando o conteúdo do repositório agora. O EDR não tem visibilidade na camada do agente; o SIEM também não consegue ver o que esses agentes fazem localmente.
Abaixo disso está a bagunça de credenciais. Nós construímos uma ferramenta de código aberto chamada Bagel em parte para tornar isso concreto. Um laptop de desenvolvedor típico contém tokens do GitHub com acesso de gravação para repositórios de produção, credenciais de nuvem que podem criar infraestrutura, tokens npm ou PyPI que podem publicar para milhões de usuários e chaves de serviço de IA que os atacantes revendem. Nenhum deles é endurecido da maneira como um executor de CI é endurecido. A mesma máquina que contém essas credenciais também navega na web e instala extensões aleatórias do VS Code.
Combine os dois e você tem a superfície de ataque real. Uma extensão não confiável executando com privilégios de desenvolvedor em um ambiente cheio de chaves de nuvem é o alvo de maior alavancagem na empresa moderna. A maioria das equipes ainda não começou a olhar para isso.
Você destacou a “armadilha de contexto”, onde os agentes de IA podem acessar arquivos locais, variáveis de ambiente e configurações. Quão comum é o risco de vazamento de dados sensíveis por meio de prompts, e por que é tão difícil detectar?
Suficientemente comum para que o tratemos como o estado padrão de qualquer ambiente de desenvolvedor não gerenciado. Cada agente de codificação que inspecionamos puxa contexto agressivamente. Eles lêem arquivos dot, variáveis de ambiente, arquivos recentes, às vezes árvores de diretório inteiras, e enviam esse contexto para um modelo remoto. As ferramentas são projetadas para funcionar dessa maneira; a captura agressiva de contexto é o que as torna úteis.
O problema de detecção começa porque o tráfego de um vazamento parece idêntico ao uso normal do produto. É TLS para api.openai.com ou api.anthropic.com. Ele vem de um aplicativo de negócios aprovado. O DLP padrão vê um desenvolvedor usando a ferramenta de IA que a empresa acabou de comprar uma licença. Ele não vê que uma das strings nesse prompt é uma chave secreta AWS que o agente pegou de um arquivo .env esquecido em um diretório irmão.
Você só pega isso inspecionando prompts antes que eles deixem o laptop, o que é exatamente onde quase nenhuma pilha de segurança está atualmente posicionada.
Você mencionou ataques de cadeia de suprimentos de velocidade de máquina. Pode nos levar por um cenário realista onde um agente de IA introduz uma vulnerabilidade mais rápido do que as ferramentas de segurança tradicionais podem identificá-la?
Aqui está um que vimos variações repetidamente. O desenvolvedor pede a um agente que adicione um recurso que precisa de uma biblioteca de retry HTTP. O agente sugere um nome de pacote. O pacote é plausível, mas na verdade não existe no npm. Dentro de uma hora, um atacante registra o pacote, popula-o com lógica de retry funcionando mais um script de pós-instalação que lê ~/.aws/credentials e posta o conteúdo para um webhook. O agente executa npm install sem verificar, porque os agentes não verificam reputação. A credencial está indo embora antes que o desenvolvedor sequer execute o código.
O ataque em si não é tecnicamente sofisticado, mas a segurança da cadeia de suprimentos tradicional é construída em torno de vulnerabilidades conhecidas em pacotes conhecidos: CVEs, SBOMs, varredura de licenças. Esse quadro não tem nada a dizer sobre um pacote que não existia quando a varredura foi executada pela última vez, foi criado especificamente para corresponder a uma alucinação de IA e é ingerido antes que qualquer feed de ameaças seja atualizado.
A janela de publicação para comprometimento agora é medida em minutos. Qualquer coisa que verifique após o fato está verificando tarde demais.
Os dependências alucinadas estão se tornando um dos maiores riscos no desenvolvimento impulsionado por IA, e quais etapas práticas as organizações podem tomar para se defender contra elas?
Elas já são um dos maiores. Os atacantes monitoram ativamente as ferramentas de IA populares para alucinações e registram os nomes de pacotes sugeridos dentro de minutos. Pesquisadores há alguns anos, quando isso primeiro começou a acontecer, o chamaram de slopsquatting e o nome pegou. Uma vez que um nome de dependência é alucinado com frequência suficiente, sentar sobre ele é um ataque de cadeia de suprimentos passivo com esforço quase zero.
As defesas práticas parecem diferentes do que a maioria das equipes tem atualmente. Comece na ingestão. Bloqueie pacotes de slopsquatting e novos registros no momento em que npm install ou pip install é executado, na máquina do desenvolvedor, antes que algo atinja o disco. A detecção pós-morte no CI não ajuda quando um script de pós-instalação já exfiltrou uma credencial. Em seguida, dê ao agente guardrails para operar dentro. Injete sua lista de dependências aprovadas diretamente no contexto do agente, para que o modelo veja o que é permitido antes de gerar uma sugestão. Pedir aos desenvolvedores que escrevam “prompts seguros” não é uma estratégia. Se você está se tornando estratégico, significa que a segurança define a fronteira, o agente a herda. E comece a rastrear uma Lista de Materiais de IA. A maioria das equipes não consegue dizer quais agentes, modelos e pacotes estão tocando quais repositórios. Você não pode defender o que não pode inventariar.
Você disse que a segurança não pode mais começar no CI/CD. Como é uma pipeline de segurança moderna quando a proteção precisa começar mais cedo no processo de desenvolvimento?
Se a segurança começa no CI/CD, você cedeu a fase pré-compromisso inteira a um ambiente que você não controla. O agente já ingeriu contexto, sua credencial pode já estar nos logs de outra pessoa. Você está varrendo um cadáver.
Uma pipeline moderna começa no laptop. Isso significa inventariar os agentes e extensões que estão executando lá, validando quais servidores MCP e modelos eles estão autorizados a conversar, sanitizando o que deixa a máquina e bloqueando pacotes mal-intencionados antes que eles instalem. A partir daí, a política segue o trabalho para o IDE. Nós injetamos padrões de segurança diretamente na janela de contexto do agente, para que o código gerado fique dentro das guardrails desde o primeiro token. A pipeline ainda é executada, fazendo verificação final de controles que já foram aplicados upstream.
A pipeline em si não some. Seu papel se torna verificação: confirmando que os controles upstream foram mantidos.
À medida que as organizações continuam a adotar agentes de codificação de IA, quais são as mudanças mais críticas que elas devem fazer hoje para garantir que seus ambientes de desenvolvimento permaneçam seguros nos próximos anos?
O maior erro é proteger apenas o que é comprometido. O risco interessante agora vive nas oito horas antes de um compromisso acontecer. Drama não visto pode se desenrolar no laptop, no prompt ou na instalação do pacote. Se suas ferramentas começam no PR, você está protegendo a metade errada do fluxo de trabalho.
Estreitamente relacionado: pare de tratar os agentes de codificação como software de produtividade. Eles são usuários não humanos com acesso de shell, privilégios de gravação de repositório e conexões de rede de saída. Gerencie-os da maneira como você gerencia qualquer outra identidade privilegiada, com um inventário, capacidades aprovadas e logs de auditoria.
A última mudança é mais difícil culturalmente. A maioria das ferramentas de “segurança de IA” atuais apresenta descobertas e as encaminha para os humanos. Os humanos não podem triar na velocidade que os agentes geram. Qualquer coisa que você adote tem que resolver problemas automaticamente dentro do fluxo de trabalho, com raciocínio rastreável, ou se torna mais um painel que ninguém lê.
Obrigado pela grande entrevista, leitores que desejam aprender mais devem visitar Boost Security.


