
Entrevistas
Piotr Tomasik, Co-Fundador e Presidente da TensorWave – Série de Entrevistas

 Adicione Unite.AI às suas fontes preferidas no Google
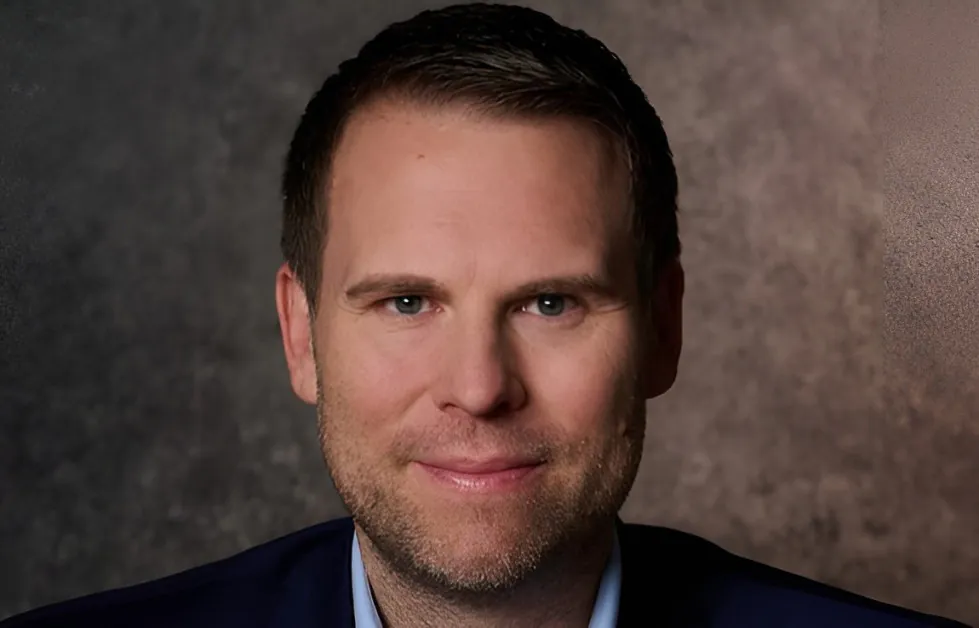
Piotr Tomasik, Co-Fundador e Presidente da TensorWave, é um empreendedor veterano de tecnologia e executivo de infraestrutura de IA com mais de duas décadas de experiência em IA, SaaS, computação em nuvem, fintech e economia criativa. Antes de co-fundar a TensorWave em 2023, ele co-fundou a Influential, uma plataforma de marketing de influenciadores alimentada por IA, posteriormente adquirida pela Publicis por aproximadamente $500 milhões, onde ele atuou como CTO antes de se tornar um consultor.
Ao longo de sua carreira, Tomasik também fundou ou liderou empresas, incluindo Lets Rolo, On Guard Data e ActiveSide, enquanto ocupava cargos de tecnologia sênior na CARD.com e Marker Trax. Além de seus papéis de operação, ele é um parceiro geral do 1864 Fund e co-fundador do StartUp Vegas, onde ele ativamente apoia o ecossistema de startups de Las Vegas e o talento emergente de tecnologia. Formado em ciência da computação pela UNLV e líder de tecnologia reconhecido, Tomasik se tornou conhecido por ajudar a posicionar a TensorWave como uma empresa de infraestrutura de computação de IA em rápido crescimento, focada em plataformas de nuvem de grande escala alimentadas por aceleradores AMD.
TensorWave é uma empresa de infraestrutura de IA focada em fornecer computação em nuvem de alto desempenho alimentada por GPUs AMD, posicionando-se como uma alternativa a ecossistemas de IA mais fechados. Fundada em 2023 e sediada em Las Vegas, a empresa constrói clusters de GPU de grande escala otimizados para treinamento e implantação de modelos de IA avançados, com ênfase em desempenho, flexibilidade e eficiência de custo. Ao aproveitar ecossistemas de hardware e software abertos, a TensorWave visa ampliar o acesso a recursos de computação de IA poderosos para empresas, pesquisadores e desenvolvedores, permitindo cargas de trabalho de IA escaláveis sem as restrições de bloqueio de fornecedor tradicional.
A Nvidia (NVDA ) domina a maior parte do mercado de GPUs – por que você decidiu apostar tudo em AMD e quais são as vantagens que essa escolha oferece à TensorWave e aos seus clientes?
Após o lançamento do ChatGPT, a demanda por IA disparou. As GPUs foram rapidamente esgotadas e a Nvidia era basicamente a única opção, se você conseguisse obtê-la e se conseguisse lidar com o custo. Essa escassez despertou um grande interesse em alternativas. Agora que passamos o hype inicial, há uma oportunidade real de desafiar a dominância da Nvidia com soluções acessíveis, eficazes em termos de custo e fáceis de usar.
Como uma startup, sempre tomamos decisões de negócios com um foco forte e um propósito. É por isso que não experimentamos com a Nvidia e continuamos construindo nossas capacidades na AMD. A próxima fase da nossa empresa é sobre aproveitar ao máximo essas capacidades focadas, para que qualquer pessoa possa entrar e fazer algo significativo com a IA. A AMD é uma alternativa credível com escala de fabricação real, postura de software aberto e uma estrada de mapas de memória para IA moderna.
Como a abordagem da TensorWave para a infraestrutura de IA difere dos provedores de nuvem de GPU tradicionais?
Nossa diferença é direta: somos a única nuvem exclusiva da AMD em escala, buscando restaurar a escolha na computação de IA, quebrar a dominância da Nvidia e democratizar o acesso. Mas também é sobre nossa ética e compromisso em trazer uma alternativa real ao mercado. Em primeiro lugar, queremos entregar infraestrutura de AMD excepcional em escala. A partir daí, expandiremos para serviços de nível superior em cima disso – Modelos como um Serviço, IA como um Serviço, tornando tudo mais simples.
Como uma nuvem toda da AMD, temos experiência em software construída especificamente para a AMD desde o início. Esse foco nos permite otimizar o silício, a rede e o software de ponta a ponta, garantindo que as equipes possam dimensionar quando necessário.
Qual é o papel da parceria estratégica com a AMD no crescimento e diferenciação da TensorWave?
É fundamental. A AMD investiu na TensorWave, nos convidou para o lançamento do MI300X Instinct e continuamos a colaborar estreitamente em hardware, habilitação de software e crescimento do ecossistema. Ser uma nuvem toda da AMD significa que podemos nos mover rapidamente com cada geração do Instinct e servir como um laboratório vivo que fornece, em escala, alternativas dentro do nosso mercado. Nossa diferenciação exclusiva da AMD nos permitiu trabalhar a um ritmo que não é tão alcançável no mercado de infraestrutura de IA. A parceria da AMD nos permite fechar lacunas rapidamente, enviar primeiro os novos GPUs e publicar desempenho real em escala.
O acesso a GPUs continua sendo um grande gargalo para as equipes de IA – como a TensorWave está lidando com esse desafio?
Estamos lidando com esses gargalos primeiro por meio da independência de fornecimento: ao construir na AMD, evitamos o pior das restrições de fornecimento de outros fabricantes de chips e passamos a disponibilidade para os clientes. A independência de fornecimento por meio da AMD garante que os nossos clientes não fiquem presos esperando na mesma fila que todos os outros.
Existem lacunas no ecossistema de infraestrutura de IA porque muitos jogadores estão construindo soluções semelhantes, criando muita sobreposição. Isso muitas vezes vem de uma falta de conscientização sobre o que está acontecendo em todo o mercado. O primeiro passo para fechar essas lacunas é entender quem está fazendo o quê, onde existem oportunidades de colaboração, onde a concorrência pode impulsionar a inovação e, finalmente, como o ecossistema pode melhorar como um todo. Uma lacuna única no mercado de infraestrutura de IA é o poder; mesmo que as GPUs estejam disponíveis, muitas vezes não há energia suficiente para suportar o número crescente de aplicações de IA. Resolver esses desafios de recursos é a chave para permitir o crescimento sustentável e a inovação nos anos vindouros.
Como recursos como resfriamento líquido direto e redes prontas para UEC (Consórcio de Ethernet Universal) melhoram o desempenho e a eficiência de custo?
O resfriamento líquido direto e as redes prontas para UEC são fundamentais para o que torna uma nuvem de IA moderna economicamente viável em escala e ambos são centrais para como projetamos a TensorWave.
Sobre o DLC: as gerações mais recentes de aceleradores, AMD’s MI355X e MI455X, funcionam em envelopes térmicos que o ar simplesmente não pode lidar de forma eficiente. Estamos falando de 1400W+ TDP por GPU. O resfriamento líquido direto remove o calor na fonte por meio de designs de placa fria ou imersão, o que faz três coisas para os nossos clientes. Primeiro, permite uma densidade de rack substancialmente maior, 120-300kW+ por rack em vez de 30 a 40kW, o que comprime a pegada e reduz os custos de real estate e distribuição de energia por megawatt. Segundo, impulsiona o PUE em direção a 1,1, versus 1,4 a 1,5 para instalações de resfriamento a ar legado; em nossa escala, isso se traduz em dezenas de milhões de dólares em economia de utilidades anuais. Terceiro, e frequentemente subestimado, o DLC mantém o silício em temperaturas de junção mais baixas e estáveis, o que preserva as taxas de clock sustentadas durante longas execuções de treinamento e estende a vida útil do hardware. Esse último ponto é enormemente importante quando você está garantindo um ativo de seis anos.
Sobre o UEC: o padrão do Consórcio de Ethernet Ultra, que a AMD ajudou a fundar e que atingiu 1.0 em 2025, nos dá uma rede de tecido aberto e de silício mercantil que atende ou excede o InfiniBand nas métricas que realmente importam para o treinamento distribuído. A latência de cauda em coletivos, largura de banda eficaz sob contenda e comportamento de dimensionamento além do limiar de 100.000 GPUs. A história de custo é estrutural. O Ethernet tem meia dúzia de fornecedores de silício mercantil credíveis competindo em preço, versus uma alternativa de única fonte que carrega um prêmio bem documentado. Para um local de 100MW, escolher redes prontas para UEC em vez de tecido proprietário é normalmente uma decisão de CAPEX de nove algarismos, e as vantagens operacionais se somam porque os nossos engenheiros de rede já conhecem o Ethernet.
Tomados em conjunto, essas escolhas nos permitem entregar uma economia de treinamento melhor do que as nuvens legadas. Os clientes veem FLOPs eficazes por dólar mais altos, tempos de passo mais previsíveis em trabalhos grandes e uma via clara à medida que os modelos escalonam. Para nós, significam uma estrutura de custo mais defensável e a flexibilidade para oferecer cartões de tarifa genuinamente competitivos.
Pode compartilhar exemplos de como os clientes estão usando a TensorWave para treinar grandes modelos de IA?
Os clientes da TensorWave precisam de computação de IA de alto desempenho sem escassez de GPUs, bloqueio de fornecedor ou custos descontrolados. A TensorWave fornece nuvem exclusiva da AMD – aberta, otimizada para memória e pronta para produção, o que dá às equipes infraestrutura de IA escalável que é acessível, flexível e eficaz em termos de custo.
Por exemplo, a Modular escolheu executar sua pilha de inferência MAX na infraestrutura de GPU da AMD da TensorWave porque a TensorWave entrega economia de custo-desempenho significativamente melhor para inferência de IA em grande escala. Ao executar a MAX da Modular na computação da AMD da TensorWave, eles alcançam até 70% de redução de custo por milhão de tokens, 57% de aumento de taxa de transferência e menos custo geral do que outras pilhas de GPU.
Com a continuação da dominância da Nvidia, onde você vê as maiores oportunidades para desafiantes como a TensorWave?
No espaço de computação de IA dominado por alguns grandes jogadores, os maiores desafios são alcançar a velocidade de mercado, entregar a tecnologia mais recente e fornecer suporte excepcional. Os hyperscalers muitas vezes oferecem uma ampla gama de opções, mas lutam para fornecer o foco ou orientação personalizada que os clientes precisam. Para romper esse espaço dominado, a TensorWave se concentra em nossas forças, enquanto colabora para fornecer a melhor tecnologia possível e garantir que os clientes tenham opções alternativas.
As duas maiores oportunidades para desafiantes da dominância da Nvidia na infraestrutura de IA são em ecossistemas abertos e memória. Ecossistemas abertos eliminam o bloqueio em cada camada (hardware, interconexão e software). Além disso, a memória em parceria com o treinamento/inferência otimizado para rede inverte a curva de custo.
Olhando cinco anos à frente, como você vê o futuro da infraestrutura de IA e o papel da TensorWave nisso?
Por anos, o objetivo na infraestrutura de IA foi torná-la boa, estável e fácil de usar. A próxima fase será sobre o que você pode entregar em cima disso – serviços gerenciados, IA como um Serviço, qualquer coisa que ajude os clientes a implantar e dimensionar mais facilmente.
Estamos no início de uma grande transformação. A tecnologia de IA continua avançando e alternativas como a AMD estão se tornando cada vez mais viáveis. À medida que isso acontece, os clientes se tornarão mais confortáveis em implantá-las em escala e todo o ecossistema começará a se abrir e crescer.
Obrigado pela grande entrevista, qualquer pessoa que queira saber mais sobre essa empresa inovadora de infraestrutura de IA deve visitar TensorWave.


