
Fundamentos de IA
O que é ETL? Extração, Transformação e Carga Explicados

 Adicione Unite.AI às suas fontes preferidas no Google
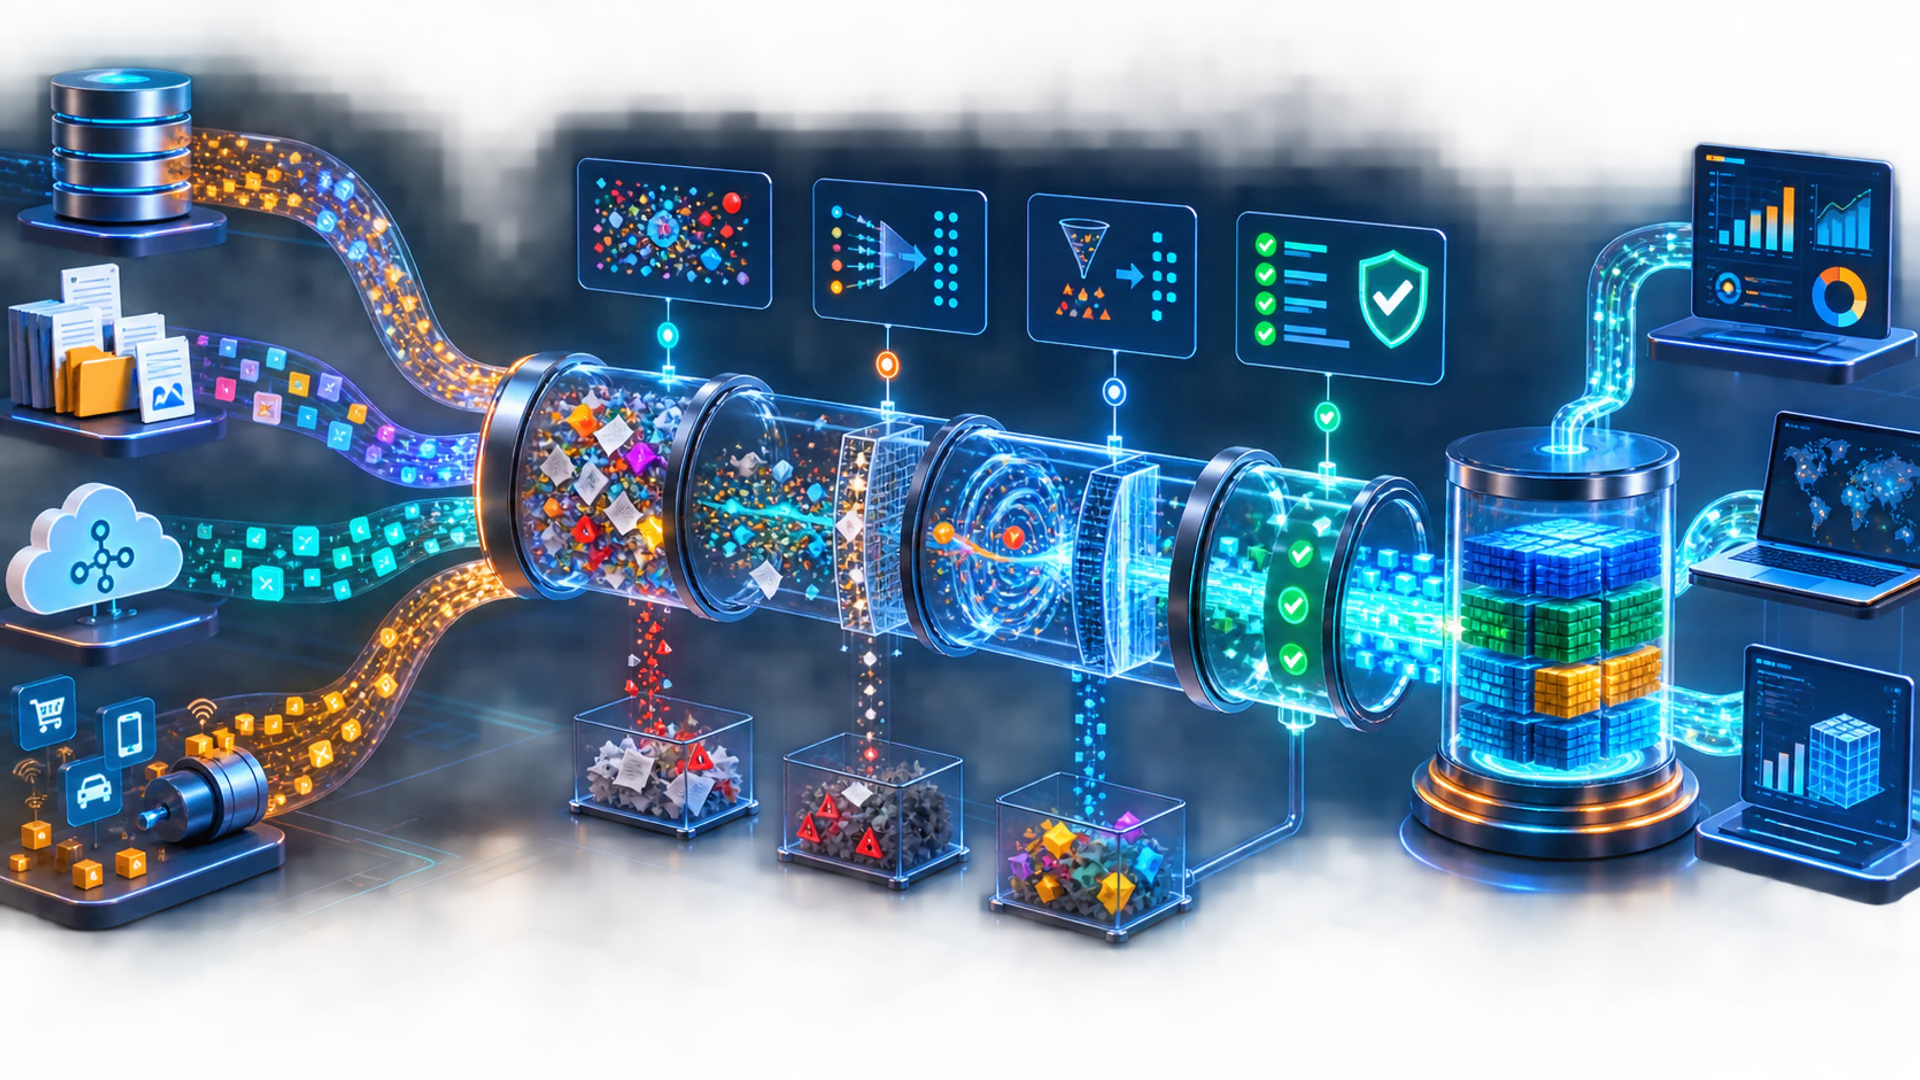
ETL—extract, transform, load—é um padrão de integração de dados que lê dados de sistemas de origem, valida e remodela‑os, e então grava‑os em um destino adequado para análise, relatórios, aprendizado de máquina ou operações.
Um pipeline ETL de produção é mais que três caixas. Ele requer execução repetível, controles de esquema e qualidade, linhagem, orquestração, observabilidade, segurança e uma forma segura de retroalimentar ou reproduzir dados quando a lógica muda.
Principais pontos
- A extração deve minimizar o impacto na origem e registrar qual intervalo ou conjunto de mudanças foi capturado.
- Transformações codificam o significado de negócios, portanto precisam de controle de versão, testes e responsabilidade.
- As cargas devem ser idempotentes ou, de outra forma, proteger contra duplicatas e falhas parciais.
- ETL versus ELT trata principalmente de onde a transformação é executada; sistemas modernos frequentemente utilizam ambos.
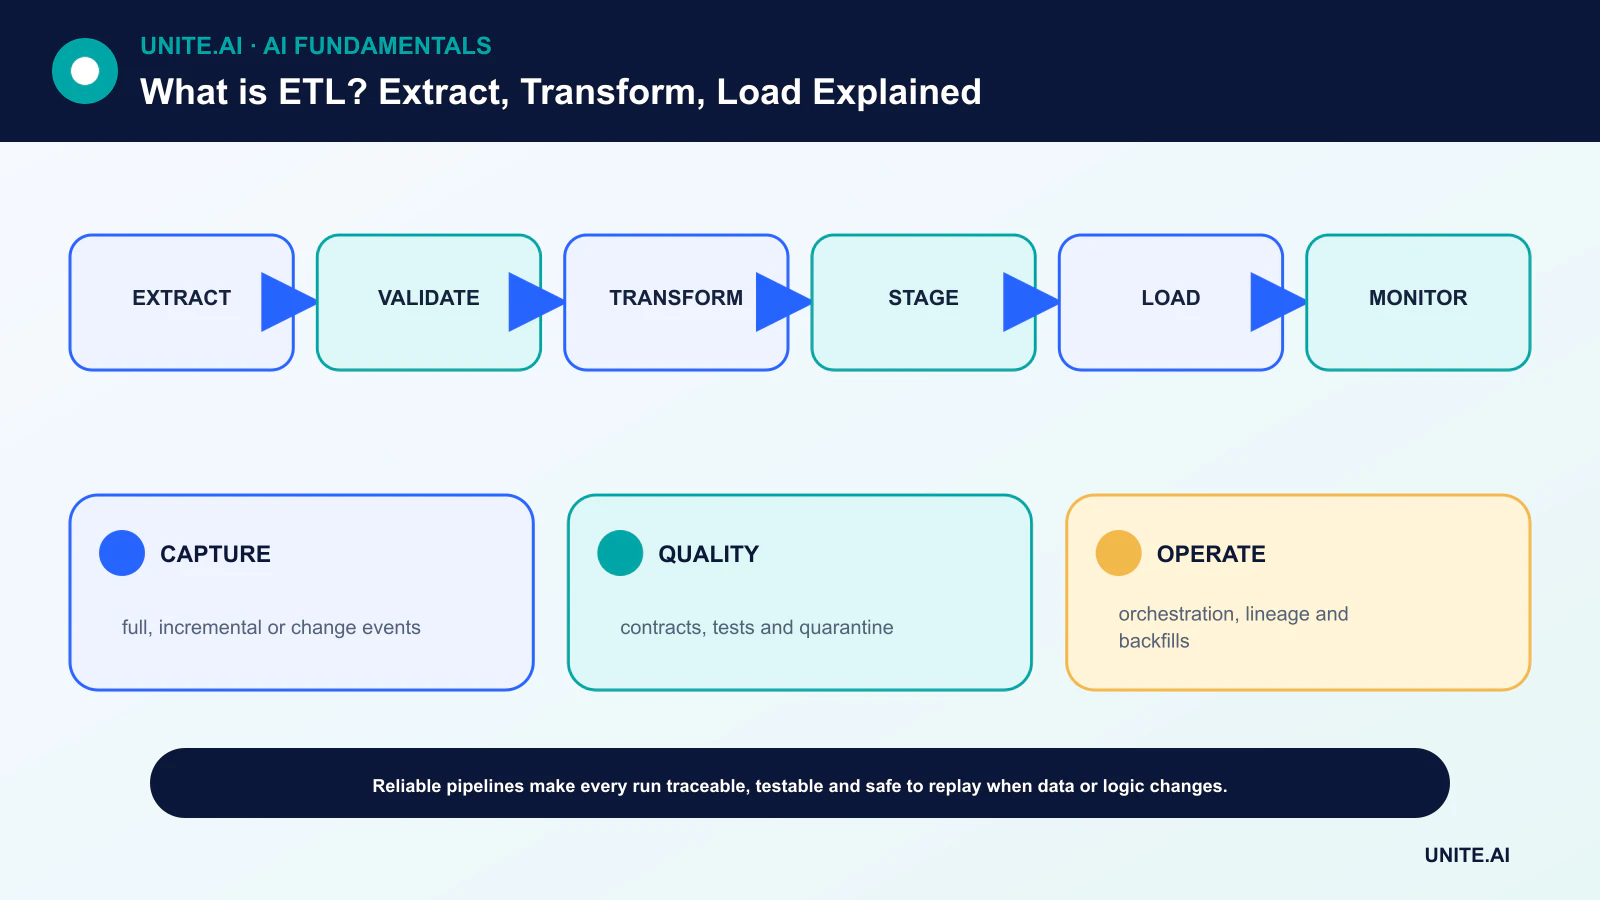
Extrair dados de forma confiável
As fontes podem incluir bancos de dados, arquivos, APIs, fluxos de eventos e aplicações. Uma extração completa copia todo o conjunto; uma extração incremental lê registros alterados desde um ponto de verificação. A captura de mudança de dados consome logs ou eventos do banco de dados para reduzir varreduras repetidas.
Registre identificadores da fonte, limites de tempo e pontos de verificação. Respeite limites de taxa e semântica de transações. Se uma fonte altera o esquema silenciosamente, falhe de forma segura ou coloque registros em quarentena ao invés de carregar dados ambíguos como se nada tivesse acontecido.
Transformar com contratos explícitos
Transformações padronizam tipos e unidades, analisam registros, juntam fontes, removem ou sinalizam duplicatas, aplicam regras de negócios e calculam atributos. Separe dados inválidos de dados ausentes, porém aceitáveis, e retenha evidências suficientes para rastrear uma saída de volta às suas entradas.
Versione transformações da mesma forma disciplinada que a entrega de software. Os testes devem cobrir esquema, intervalos, integridade referencial, distribuições esperadas e exemplos conhecidos. Um contrato de dados define as expectativas entre produtor e consumidor.
Carregar de forma segura e repetível
Uma carga pode acrescentar eventos, mesclar registros alterados, substituir uma partição ou reconstruir uma tabela. Idempotência significa que reexecutar a mesma entrada produz o mesmo estado de destino. Transações, tabelas de staging e trocas atômicas reduzem a exposição a atualizações parciais.
Particionamento e indexação devem corresponder aos padrões de consumo. Proteja campos sensíveis e aplique permissões de destino antes que os dados se tornem consultáveis. Requisitos de retenção e exclusão devem acompanhar os dados.
ETL, ELT, lote e streaming
O ETL tradicional transforma em um mecanismo separado antes da carga. O ELT carrega dados brutos ou levemente processados primeiro, e então usa o processamento do destino para a transformação. Um data warehouse ou lakehouse na nuvem pode tornar o ELT conveniente, mas não elimina o trabalho de qualidade ou governança.
Pipelines em lote processam intervalos delimitados; pipelines de streaming processam eventos contínuos com semânticas definidas de tempo e ordenação. Muitas arquiteturas utilizam ingestão em streaming seguida de reconciliação periódica, pois dados atrasados ou corrigidos são normais.
Orquestração, linhagem e observabilidade
Um orquestrador agenda tarefas, respeita dependências, tenta novamente falhas definidas e registra o estado. As tentativas precisam de limites e tarefas idempotentes. Retroalimentações devem ser isoladas e conscientes da capacidade, de modo que reparos históricos não interrompam os dados atuais.
Monitore frescor, volume, esquema, qualidade, duração e custo. A linhagem e a camada de metadados de um data fabric ajudam os consumidores a entender qual versão gerou um conjunto de dados e o que quebrou a montante.
Extrair: fontes, contratos e captura incremental
ETL move dados de sistemas de origem, transforma‑os em estruturas governadas e carrega‑os em um destino. A extração pode usar arquivos, consultas a bancos de dados, APIs, logs, fluxos ou captura de mudança de dados. Defina propriedade da fonte, esquema, chaves, timestamps, fuso horário, unidades, semântica de exclusão e carga permitida. Extrações completas são simples, porém caras; a captura incremental reduz o volume, mas requer marcas d’água, posições de log ou campos de versão e uma estratégia para registros atrasados e corrigidos.
Não presuma que o sucesso de uma API signifique uma extração completa. Registre contagens, somas de verificação, lacunas de sequência, paginação, limites de taxa, tentativas e snapshots da fonte. Armazene dados brutos imutáveis onde a política permitir, para que as transformações possam ser reproduzidas. Proteja credenciais e campos sensíveis, e torne as tentativas idempotentes. Alterações de esquema devem ser classificadas como compatíveis ou disruptivas por meio de contratos, em vez de serem descobertas quando um painel a jusante muda silenciosamente.
Transformar e carregar com semânticas reproduzíveis
Transformações analisam tipos, padronizam unidades, deduplicam, juntam, aplicam regras de negócios, gerenciam histórico e derivam fatos e dimensões. Cada regra precisa de testes e linhagem. Ajuste pré‑processamento estatístico apenas em dados de treinamento adequados quando o ETL alimenta ML. Dimensões que mudam lentamente determinam se alterações de atributos sobrescrevem ou preservam o histórico. Declare a granularidade dos fatos antes da junção; erros muitos‑para‑muitos criam medidas duplicadas que podem sobreviver a verificações básicas de linhas.
A carga pode acrescentar, mesclar, substituir partições ou atualizar registros. Use tabelas de staging e trocas atômicas quando possível, para que os leitores não vejam estado parcial. Imponha unicidade, relacionamentos, valores aceitos, completude e invariantes de negócios. Trate eventos tardios e retroalimentações com tempo de evento e código versionado. A reconciliação contra totais da fonte é essencial para dados financeiros e operacionais. O ELT carrega dados brutos antes da transformação no destino; os requisitos de governança e correção permanecem.
Operações e recuperação
A orquestração gerencia dependências, agendas, tentativas, concorrência e alertas. Monitore frescor, volume, qualidade, duração, custo e impacto a jusante. Um trabalho falhado deve retomar ou reproduzir sem duplicação. Versione código e esquemas, mantenha a linhagem e teste retroalimentações isoladamente. A recuperação de desastres inclui dados brutos, catálogos, permissões, estado da orquestração e definições semânticas. O ETL é confiável quando um usuário pode rastrear uma métrica até as fontes e reproduzi‑la após mudança — não apenas quando um pipeline verde foi concluído.
Exemplo prático: um pipeline incremental de pedidos
Um job ETL lê logs de mudanças do banco de dados para pedidos e itens, armazena eventos imutáveis, valida sequência e esquema, e os mescla em uma tabela de fatos do data warehouse com granularidade de linha de pedido. O tempo de evento e a versão de atualização tratam correções tardias; chaves determinísticas tornam a reprodução idempotente. Dimensões preservam histórico selecionado de clientes e produtos por meio de chaves substitutas. Contagens de linhas, totais de pedidos, impostos, devoluções e cancelamentos são reconciliados com os períodos de origem.
Uma mudança de campo de origem que quebra interrompe a promoção para tabelas confiáveis e alerta os proprietários com a linhagem a jusante. Retroalimentações são executadas com código versionado em isolamento e comparadas antes de uma troca atômica. A política de acesso restringe identificadores de clientes, e a exclusão se propaga para cópias derivadas permitidas. O monitoramento cobre frescor, volume, qualidade, custo e impacto nos painéis. Testes de recuperação recriam um período a partir de eventos brutos e restauram o estado da orquestração. Um agendador verde é insuficiente a menos que os números de negócios permaneçam reproduzíveis e reconciliados.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, interrupção de dependência, uso indevido e os grupos ou ambientes mais propensos a ficarem desatendidos. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, rollback e aposentadoria. Use um rollout em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, então revise evidências do mundo real após a implantação ao invés de presumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
O ETL está obsoleto em plataformas de dados na nuvem?
Não. Algumas plataformas favorecem o ELT, mas as responsabilidades de extração, transformação e carga ainda existem. As equipes frequentemente combinam ambos os padrões.
O que torna um pipeline ETL idempotente?
Ele pode processar com segurança a mesma entrada novamente sem criar estado de destino duplicado ou inconsistente, geralmente por meio de chaves estáveis, pontos de verificação e gravações transacionais.
Referências principais












