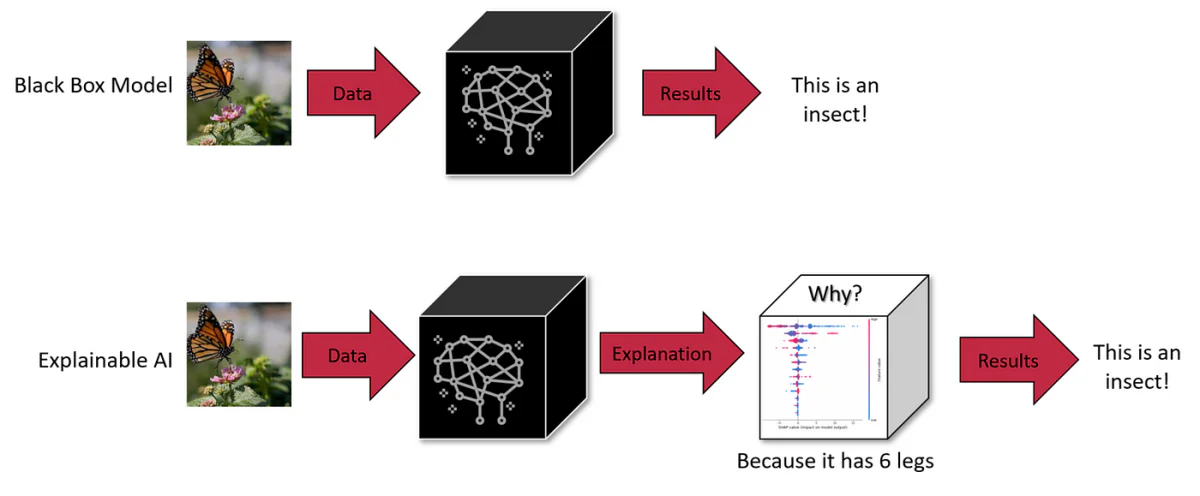
A aprendizagem de máquina, um subconjunto da IA, envolve três componentes: algoritmos, dados de treinamento e o modelo resultante. Um algoritmo, essencialmente um conjunto de procedimentos, aprende a identificar padrões a partir de um grande conjunto de exemplos (dados de treinamento). A culminação desse treinamento é um modelo de aprendizagem de máquina. Por exemplo, um algoritmo treinado com imagens de cães resultaria em um modelo capaz de identificar cães em imagens.
A Caixa Preta na Aprendizagem de Máquina
Na aprendizagem de máquina, qualquer um dos três componentes — algoritmo, dados de treinamento ou modelo — pode ser uma caixa preta. Embora os algoritmos sejam frequentemente de conhecimento público, os desenvolvedores podem escolher manter o modelo ou os dados de treinamento secretos para proteger a propriedade intelectual. Essa obscuridade torna desafiador entender o processo de tomada de decisão da IA.
As caixas pretas da IA são sistemas cujos mecanismos internos permanecem opacos ou invisíveis para os usuários. Os usuários podem inserir dados e receber saídas, mas a lógica ou código que produz a saída permanece oculto. Essa é uma característica comum em muitos sistemas de IA, incluindo modelos gerativos avançados como ChatGPT e DALL-E 3.
Os LLMs, como o GPT-4, apresentam um desafio significativo: seus mecanismos internos são amplamente opacos, tornando-os “caixas pretas”. Essa opacidade não é apenas um quebra-cabeça técnico; ela levanta preocupações reais de segurança e ética. Por exemplo, se não podemos discernir como esses sistemas chegam a conclusões, podemos confiar neles em áreas críticas como diagnósticos médicos ou avaliações financeiras?
Explorando as Técnicas de LIME e SHAP
A interpretabilidade em modelos de aprendizagem de máquina (ML) e aprendizagem profunda (DL) nos permite ver os mecanismos internos opacos desses modelos avançados. Explicações Model-agnósticas Locais Interpretabilidades (LIME) e Explicações Aditivas de Shapley (SHAP) são duas técnicas de interpretabilidade amplamente utilizadas.
Interpretability
LIME, por exemplo, divide a complexidade criando modelos substitutos mais simples, locais, que aproximam o comportamento do modelo original em torno de uma entrada específica. Ao fazer isso, o LIME ajuda a entender como as características individuais influenciam as previsões de modelos complexos, essencialmente fornecendo uma “explicação local” para por que um modelo tomou uma certa decisão. É particularmente útil para usuários não técnicos, pois traduz o processo intricado de tomada de decisão dos modelos em termos mais compreensíveis.
Model-Agnostic Interpretability of Machine Learning (LIME) Source
O SHAP, por outro lado, se inspira na teoria dos jogos, especificamente no conceito de valores de Shapley. Ele atribui um valor de “importância” a cada característica, indicando quanto cada característica contribui para a diferença entre a previsão real e a previsão de base (a previsão média em todos os inputs). A força do SHAP reside em sua consistência e capacidade de fornecer uma perspectiva global — ele não apenas explica previsões individuais, mas também fornece insights sobre o modelo como um todo. Isso é especialmente valioso em modelos de aprendizagem profunda, onde as camadas interconectadas e os numerosos parâmetros frequentemente tornam o processo de previsão parecido com uma jornada por um labirinto. O SHAP desmistifica isso quantificando a contribuição de cada característica, oferecendo um mapa mais claro dos caminhos de tomada de decisão do modelo.
Os LIME e SHAP emergiram como ferramentas essenciais no domínio da IA e ML, abordando a necessidade crítica de transparência e confiabilidade. À medida que continuamos a integrar a IA mais profundamente em vários setores, a capacidade de interpretar e entender esses modelos se torna não apenas uma necessidade técnica, mas um requisito fundamental para o desenvolvimento de IA ético e responsável. Essas técnicas representam avanços significativos na compreensão das complexidades dos modelos de ML e DL, transformando-os de “caixas pretas” insondáveis em sistemas compreensíveis cujas decisões e comportamentos podem ser entendidos, confiáveis e utilizados de forma eficaz.
A Escala e Complexidade dos LLMs
A escala desses modelos adiciona à sua complexidade. Pegue o GPT-3, por exemplo, com seus 175 bilhões de parâmetros, e modelos mais novos com trilhões. Cada parâmetro interage de maneiras intricadas dentro da rede neural, contribuindo para capacidades emergentes que não são previsíveis ao examinar componentes individuais isoladamente. Essa escala e complexidade tornam quase impossível entender completamente a lógica interna, representando um obstáculo no diagnóstico de vieses ou comportamentos indesejados nesses modelos.
A Troca: Escala vs. Interpretabilidade
Reduzir a escala dos LLMs poderia melhorar a interpretabilidade, mas ao custo de suas capacidades avançadas. A escala é o que permite comportamentos que modelos menores não podem alcançar. Isso apresenta uma troca inerente entre escala, capacidade e interpretabilidade.
Impacto do Problema da Caixa Preta dos LLMs
1. Tomada de Decisão Imperfeita
A opacidade no processo de tomada de decisão dos LLMs, como o GPT-3 ou BERT, pode levar a vieses e erros não detectados. Em campos como saúde ou justiça criminal, onde as decisões têm consequências de longo alcance, a incapacidade de auditar os LLMs para solidez ética e lógica é uma preocupação significativa. Por exemplo, um diagnóstico médico de LLM que depende de dados desatualizados ou viesados pode fazer recomendações prejudiciais. Da mesma forma, os LLMs em processos de contratação podem perpetuar vieses de gênero involuntariamente. A natureza de caixa preta não apenas oculta falhas, mas pode potencialmente amplificá-las, exigindo uma abordagem proativa para melhorar a transparência.
2. Adaptabilidade Limitada em Contextos Diversos
A falta de visibilidade nos mecanismos internos dos LLMs restringe sua adaptabilidade. Por exemplo, um LLM de contratação pode ser ineficiente na avaliação de candidatos para um papel que valoriza habilidades práticas sobre qualificações acadêmicas, devido à sua incapacidade de ajustar seus critérios de avaliação. Da mesma forma, um LLM médico pode lutar com diagnósticos de doenças raras devido a desequilíbrios de dados. Essa inflexibilidade destaca a necessidade de transparência para recalibrar os LLMs para tarefas e contextos específicos.
3. Viés e Lacunas de Conhecimento
O processamento de grandes conjuntos de dados de treinamento pelos LLMs está sujeito às limitações impostas por seus algoritmos e arquiteturas de modelo. Por exemplo, um LLM médico pode exibir vieses demográficos se treinado em conjuntos de dados desequilibrados. Além disso, a proficiência de um LLM em tópicos de nicho pode ser enganosa, levando a saídas confiantes, mas incorretas. Abordar esses vieses e lacunas de conhecimento requer mais do que apenas dados adicionais; exige um exame dos mecanismos de processamento do modelo.
4. Responsabilidade Legal e Ética
A natureza obscura dos LLMs cria uma área cinzenta legal quanto à responsabilidade por qualquer dano causado por suas decisões. Se um LLM em um ambiente médico fornece conselhos defeituosos que levam a danos ao paciente, determinar a responsabilidade se torna difícil devido à opacidade do modelo. Essa incerteza legal representa riscos para entidades que implantam LLMs em áreas sensíveis, sublinhando a necessidade de governança e transparência claras.
5. Questões de Confiança em Aplicações Sensíveis
Para os LLMs usados em áreas críticas, como saúde e finanças, a falta de transparência compromete sua confiabilidade. Os usuários e reguladores precisam garantir que esses modelos não abrigam vieses ou tomam decisões com base em critérios injustos. Verificar a ausência de viés nos LLMs exige uma compreensão de seus processos de tomada de decisão, enfatizando a importância da explicabilidade para o desenvolvimento ético.
6. Riscos com Dados Pessoais
Os LLMs exigem conjuntos de dados de treinamento extensos, que podem incluir informações pessoais sensíveis. A natureza de caixa preta desses modelos levanta preocupações sobre como esses dados são processados e utilizados. Por exemplo, um LLM médico treinado em registros de pacientes levanta questões sobre privacidade e uso de dados. Garantir que os dados pessoais não sejam mal utilizados ou explorados exige processos de manipulação de dados transparentes dentro desses modelos.
Soluções Emergentes para Interpretabilidade
Para abordar esses desafios, novas técnicas estão sendo desenvolvidas. Essas incluem métodos de aproximação contrafactual (CF). O primeiro método envolve solicitar a um LLM que altere um conceito de texto específico enquanto mantém outros conceitos constantes. Essa abordagem, embora eficaz, é intensiva em recursos no tempo de inferência.
O segundo método envolve criar um espaço de incorporação dedicado guiado por um LLM durante o treinamento. Esse espaço se alinha com um gráfico causal e ajuda a identificar combinações que aproximam CFs. Esse método requer menos recursos no tempo de teste e tem sido mostrado para explicar efetivamente as previsões do modelo, mesmo em LLMs com bilhões de parâmetros.
Essas abordagens destacam a importância de explicações causais em sistemas de NLP para garantir segurança e estabelecer confiança. Aproximações contrafactuais fornecem uma maneira de imaginar como um texto dado mudaria se um certo conceito em seu processo gerativo fosse diferente, auxiliando na estimativa prática de efeitos causais de conceitos de alto nível em modelos de NLP.
Imersão Profunda: Métodos de Explicação e Causalidade em LLMs
Ferramentas de Probing e Importância de Recursos
A sondagem é uma técnica usada para decifrar quais representações internas nos modelos codificam. Pode ser supervisionada ou não supervisionada e visa determinar se conceitos específicos são codificados em certos lugares da rede. Embora eficaz até certo ponto, as sondas falham em fornecer explicações causais, como destacado por Geiger et al. (2021).
Ferramentas de importância de recursos, outra forma de método de explicação, frequentemente se concentram em recursos de entrada, embora alguns métodos baseados em gradientes estendam isso a estados ocultos. Um exemplo é o método de Gradientes Integrados, que oferece uma interpretação causal explorando entradas de referência (contrafatuais, CF). Apesar de sua utilidade, esses métodos ainda lutam para conectar suas análises com conceitos do mundo real além de propriedades simples de entrada.
Métodos Baseados em Intervenção
Métodos baseados em intervenção envolvem modificar entradas ou representações internas para estudar efeitos no comportamento do modelo. Esses métodos podem criar estados contrafatuais para estimar efeitos causais, mas frequentemente geram entradas ou estados de rede implausíveis, a menos que controlados cuidadosamente. O Modelo de Proxy Causal (CPM), inspirado no conceito do aprendiz S, é uma abordagem nova nesse domínio, imitando o comportamento do modelo explicado sob entradas contrafatuais. No entanto, a necessidade de um explicador distinto para cada modelo é uma limitação significativa.
Aproximação de Contrafatuais
Contrafatuais são amplamente usados em aprendizagem de máquina para aumento de dados, envolvendo perturbações em vários fatores ou rótulos. Eles podem ser gerados por meio de edição manual, substituição de palavras-chave heurística ou reescrita de texto automatizada. Embora a edição manual seja precisa, também é intensiva em recursos. Métodos baseados em palavras-chave têm limitações, e abordagens gerativas oferecem um equilíbrio entre fluência e cobertura.
Explicações Fidedignas
Fidelidade em explicações refere-se a representar com precisão a razão subjacente do modelo. Não há uma definição universalmente aceita de fidelidade, levando à sua caracterização por meio de várias métricas como Sensibilidade, Consistência, Acordo de Importância de Recursos, Robustez e Simulabilidade. A maioria desses métodos se concentra em explicações de nível de recurso e frequentemente confunde correlação com causalidade. Nosso trabalho visa fornecer explicações de conceitos de alto nível, aproveitando a literatura sobre causalidade para propor um critério intuitivo: Fidelidade à Ordem.
Nos aprofundamos nas complexidades inerentes dos LLMs, entendendo sua natureza de “caixa preta” e os desafios significativos que isso impõe. Desde os riscos de tomada de decisão imperfeita em áreas sensíveis, como saúde e finanças, até as questões éticas que cercam viés e justiça, a necessidade de transparência nos LLMs nunca foi mais evidente.
O futuro dos LLMs e sua integração em nossas vidas diárias e processos de tomada de decisão crítica depende de nossa capacidade de tornar esses modelos não apenas mais avançados, mas também mais compreensíveis e responsáveis. A busca por explicabilidade e interpretabilidade não é apenas uma empreitada técnica, mas um aspecto fundamental da construção de confiança em sistemas de IA. À medida que os LLMs se tornam mais integrados à sociedade, a demanda por transparência crescerá, não apenas de praticantes de IA, mas de todos os usuários que interagem com esses sistemas.
Eu passei os últimos cinco anos me imergindo no fascinante mundo de Aprendizado de Máquina e Aprendizado Profundo. Minha paixão e expertise me levaram a contribuir para mais de 50 projetos de engenharia de software diversificados, com um foco particular em IA/ML. Minha curiosidade contínua também me levou em direção ao Processamento de Linguagem Natural, um campo que estou ansioso para explorar mais.


 Adicione Unite.AI às suas fontes preferidas no Google