
Fundamentos de IA
Como funciona a classificação de imagens?

 Adicione Unite.AI às suas fontes preferidas no Google
Classificação de imagens prevê um rótulo para uma imagem inteira. Ela responde a perguntas como “Qual categoria de produto está sendo mostrada?” ou “Esta varredura contém um achado alvo?”. Não localiza cada objeto nem delineia seus pixels por si só.
Sistemas modernos costumam usar redes neurais convolucionais ou vision transformers, frequentemente inicializados com pesos pré‑treinados. O desempenho confiável ainda depende de rótulos, amostragem, aumento de dados, calibração e testes em condições reais de implantação.
Principais pontos
- A classificação rotula a imagem inteira; a detecção desenha caixas ao redor dos objetos e a segmentação atribui regiões ao nível de pixel.
- Pré‑treinamento e aprendizado por transferência podem reduzir a necessidade de dados, mas descompasso de domínio pode eliminar o benefício.
- A acurácia geral pode mascarar desequilíbrio de classes, atalhos espúrios e má calibração.
- Qualidade da imagem, dispositivo de captura, localização geográfica e mudanças no fluxo de trabalho podem gerar deslocamento de distribuição.
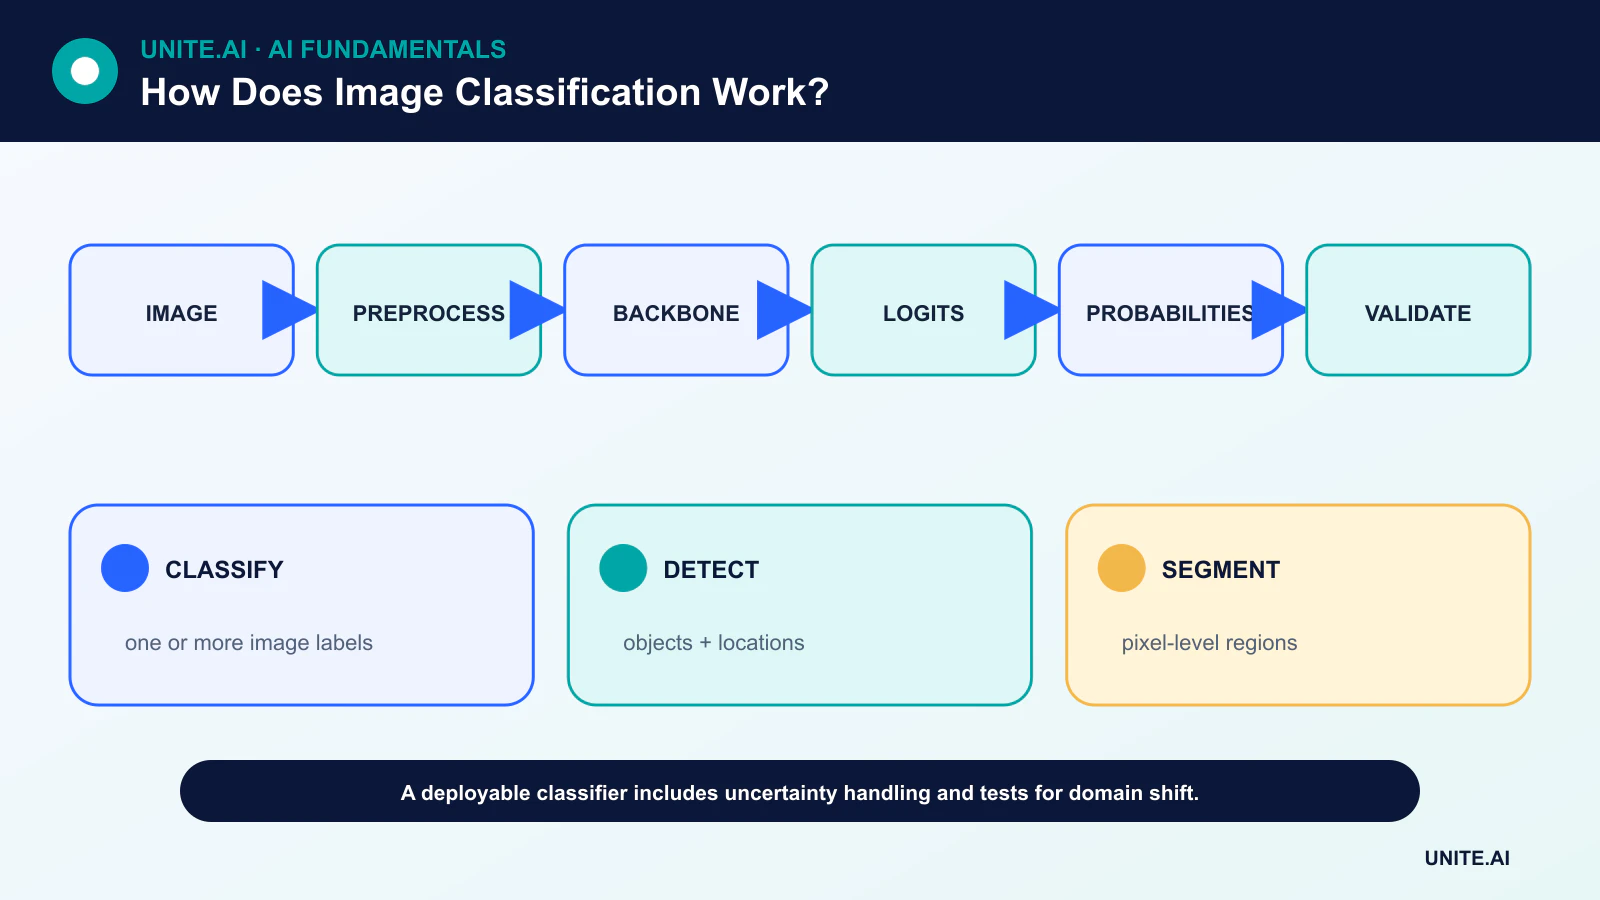
Dos pixels às pontuações
Imagens são redimensionadas ou recortadas, normalizadas e convertidas em tensores. O aumento de dados pode aplicar transformações que preservam o rótulo, como inversões, recortes ou alterações de cor. Um backbone converte pixels em recursos; uma cabeça de classificação produz logits que são convertidos em pontuações relativas de classe.
O pré‑processamento escolhido deve corresponder à implantação. Um recorte central que remove o objeto relevante ou uma incompatibilidade de normalização pode prejudicar o desempenho mesmo quando os pesos treinados permanecem inalterados.
CNNs e vision transformers
Convolutional neural networks utilizam filtros locais e pesos compartilhados para construir recursos espaciais. Conexões residuais tornaram CNNs muito profundas mais fáceis de otimizar. Vision transformers dividem uma imagem em blocos e usam atenção para modelar as relações entre eles.
Comparações de arquitetura devem controlar por dados de treinamento, aumento, computação e resolução. O melhor modelo em um benchmark público pode não ser o mais adequado para um dispositivo de borda, conjunto de dados pequeno ou requisito de explicabilidade.
Aprendizado por transferência e design de dados
Transfer learning parte de pesos treinados em um conjunto de dados fonte maior. Uma equipe pode congelar o backbone, ajustar finamente camadas posteriores ou atualizar o modelo completo. O ajuste fino geralmente requer uma taxa de aprendizado menor e um conjunto de validação seguro contra vazamento.
Os rótulos devem descrever o que é visivelmente inferível. Se um diagnóstico depende de histórico do paciente indisponível na imagem, o classificador não pode aprender a decisão clínica completa. Duplicatas, quadros de um mesmo vídeo e imagens do mesmo sujeito devem permanecer na mesma divisão.
Métricas, incerteza e atalhos
A acurácia Top‑1 exige que a classe com maior pontuação esteja correta; a acurácia Top‑k aceita a classe correta entre as k maiores pontuações. Precisão, recall por classe e uma confusion matrix revelam erros desiguais.
Os modelos podem explorar fundos, marcas d’água, equipamentos de aquisição ou enquadramento em vez do objeto pretendido. Testes contrafactuais, análise de subgrupos e ferramentas de saliência podem ajudar a descobrir atalhos, mas um mapa de calor de explicação não prova raciocínio causal.
Monitoramento de implantação
Verificações em produção devem abranger arquivos corrompidos, dimensões inesperadas, desfoque, iluminação, modelos de câmera e novas classes. A confiança deve ser calibrada em dados semelhantes à implantação, e entradas fora do escopo devem ser rejeitadas ou revisadas.
Monitorar atrasos nos rótulos e mudanças no custo de erro é essencial. Um modelo que parece estável pelas estatísticas de entrada ainda pode falhar se a relação entre pixels e rótulos mudar.
Construindo um conjunto de dados de classificação de imagens
Classificação de imagens atribui um ou mais rótulos a uma imagem inteira. Difere da detecção, que localiza objetos, e da segmentação, que rotula pixels. Defina o escopo das classes, hierarquia, regras de multilabel, categorias de fundo ou desconhecidas, e quais evidências devem ser visíveis. Coleta câmeras, locais, iluminação, pontos de vista, distâncias e sujeitos representativos da implantação. Divida por sujeito, cena, sessão ou fonte antes do aumento; quadros de vídeo adjacentes ou imagens de produto duplicadas entre partições causam vazamento severo.
As instruções de anotação devem cobrir oclusão, objetos ambíguos, múltiplas classes, baixa qualidade e abstenção. Meça o acordo e revise discordâncias sistemáticas. O balanceamento de classes por si só não garante cobertura: uma classe de doença pode incluir um único dispositivo ou uma classe de vida selvagem um único fundo. Inspecione metadados e quase duplicatas, e mantenha um conjunto de teste protegido de aquisição independente. Dados sintéticos e raspagem da web podem ampliar a variedade, mas introduzem questões de licenciamento, proveniência, estilo e rótulos que devem ser medidos em imagens reais.
Modelos, treinamento e avaliação
Métodos clássicos combinam descritores engenheirados com um classificador; sistemas modernos usam redes convolucionais ou vision transformers, frequentemente por meio de aprendizado por transferência. As escolhas de redimensionamento e recorte determinam quais informações sobrevivem. O aumento de dados deve refletir variações válidas e preservar os rótulos. Otimize uma perda adequada à tarefa, trate desequilíbrios por ponderação ou amostragem cuidadosa, e selecione checkpoints nos dados de validação. Compare com uma linha de base simples e ablate aumento, resolução e inicialização pré‑treinada para aprender de onde vêm os ganhos.
Reporte precisão, recall, F1, confusão, acurácia top‑k quando relevante, calibração e desempenho por condição. Teste desfoque, compressão, iluminação, recorte, oclusão, dispositivo e entradas sem classe suportada. Limiares de confiança podem encaminhar casos incertos para revisão; a probabilidade softmax não garante confiança, especialmente sob deslocamento. Fundos contrafactuais e testes de oclusão revelam aprendizado de atalhos. Para uso relacionado à segurança, avalie falhas no pior caso e as consequências de falsos positivos e negativos.
Implantação e monitoramento
Empacote decodificação, conversão de cor, orientação, normalização, modelo e mapa de rótulos juntos. Valide o artefato exportado ou quantizado em dispositivos-alvo e meça latência de ponta a ponta, memória, energia e taxa de transferência. Monitore qualidade da imagem, distribuições de entrada e saída, calibração, rótulos confirmados e saúde dos sensores. Minimize e proteja a retenção de imagens, especialmente de rostos, localizações e transeuntes. Forneça fallback para entradas corrompidas ou fora do escopo e reverta versões do modelo. A classificação responde à pergunta definida ao nível da imagem; não deve ser estendida a reivindicações não suportadas de localização, identidade ou intenção.
Exemplo prático: classificação de materiais recicláveis
Uma instalação fotografa itens em uma esteira e rotula a classe do material, contaminação e desconhecido. As imagens são divididas por dia de coleta e lote de objetos, abrangendo iluminação, superfícies úmidas, amassamento, sobreposição e correias vazias. Um pequeno CNN e modelo pré‑treinado são comparados com regras de cor e forma. Recall por classe, classificação errada, calibração, taxa de transferência e resultados por câmera e condição do material orientam a seleção.
O pipeline de produção verifica exposição da câmera e sincronismo da correia, então encaminha itens incertos para um fluxo geral ao invés de forçar uma classe. A inferência quantizada é validada no hardware exato. O monitoramento acompanha qualidade de entrada, taxas de classe, rejeições e auditorias manuais amostradas; nova embalagem dispara uma atualização de dados revisada. O modelo controla um separador limitado com guardas físicas, e falha de sensor ou modelo devolve o mecanismo a um estado seguro em vez de redirecionar material silenciosamente.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entrada malformada ou ausente, deslocamento de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentadoria. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar qualidade de entrada, comportamento de saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também necessita de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Um classificador de imagens pode identificar vários objetos?
Um classificador multilabel pode indicar quais categorias estão presentes, mas não localiza instâncias individuais. É necessária a detecção de objetos para obter caixas ou contagens.
Por que um modelo pode falhar em fotos que parecem normais para uma pessoa?
Ele pode depender de artefatos de captura, texturas ou correlações que mudaram. Pequenas diferenças no pré‑processamento e deslocamento de domínio também podem afetar os recursos aprendidos.
Referências principais












