

Modelos e plataformas de IA
AniPortrait: Síntese de Animação de Retrato Fotorealista Impulsionada por Áudio

 Adicione Unite.AI às suas fontes preferidas no Google
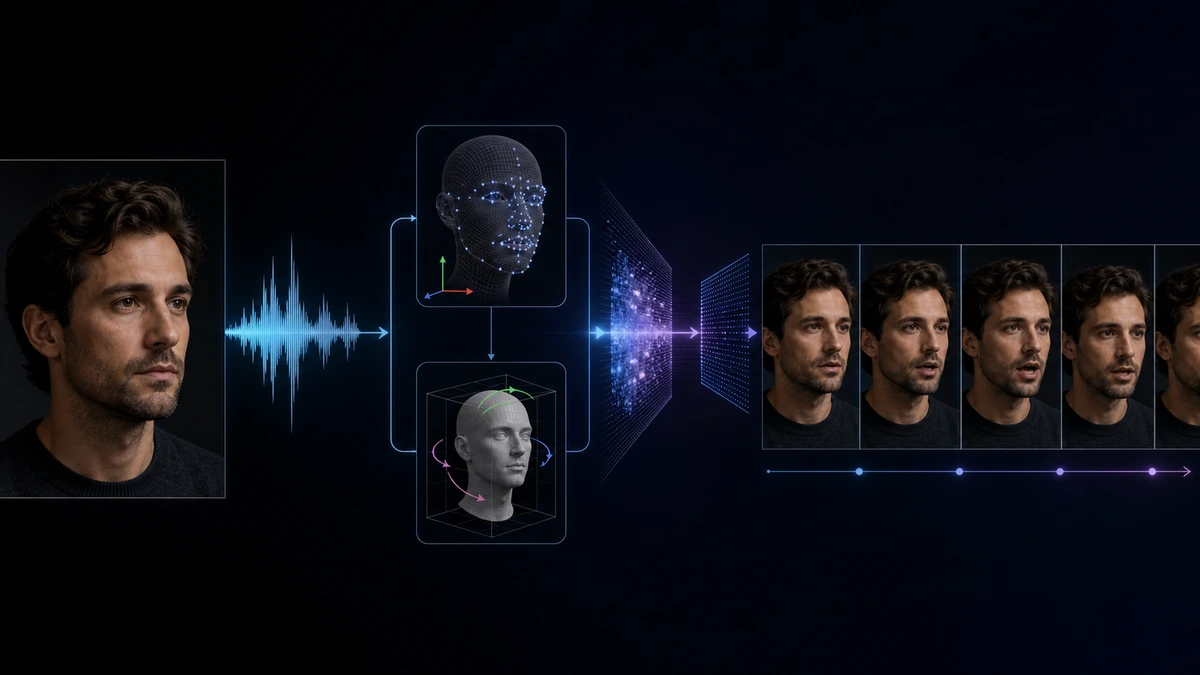
Ao longo dos anos, a criação de animações de retratos realistas e expressivas a partir de imagens estáticas e áudio encontrou uma variedade de aplicações, incluindo jogos, mídia digital, realidade virtual e muito mais. Apesar de seu potencial de aplicação, ainda é difícil para os desenvolvedores criar frameworks capazes de gerar animações de alta qualidade que mantenham a consistência temporal e sejam visualmente atraentes. Uma das principais causas da complexidade é a necessidade de coordenação intricada de movimentos labiais, posições de cabeça e expressões faciais para criar um efeito visualmente atraente.
Neste artigo, vamos falar sobre o AniPortrait, um framework novo projetado para gerar animações de alta qualidade impulsionadas por uma imagem de referência e uma amostra de áudio. O funcionamento do framework AniPortrait é dividido em duas etapas. Primeiro, o framework AniPortrait extrai as representações intermediárias 3D das amostras de áudio e as projeta em uma sequência de marcos faciais 2D. Em seguida, o framework emprega um modelo de difusão robusto acoplado a um módulo de movimento para converter a sequência de marcos em animações temporais consistentes e fotorealistas. Os resultados experimentais demonstram a superioridade e a capacidade do framework AniPortrait de gerar animações de alta qualidade com qualidade visual excepcional, diversidade de pose e naturalidade facial, oferecendo assim uma experiência perceptual aprimorada e enriquecida. Além disso, o framework AniPortrait tem um potencial notável em termos de controllabilidade e flexibilidade e pode ser aplicado de forma eficaz em áreas que incluem reencenação facial, edição de movimento facial e muito mais. Este artigo visa cobrir o framework AniPortrait em profundidade e exploramos o mecanismo, a metodologia, a arquitetura do framework, bem como sua comparação com frameworks de estado da arte. Vamos começar.
AniPortrait: Animação de Retrato Fotorealista
Criar animações de retratos realistas e expressivas tem sido o foco dos pesquisadores por um tempo agora, devido ao seu potencial incrível e aplicações que variam desde mídia digital e realidade virtual até jogos e muito mais. Apesar de anos de pesquisa e desenvolvimento, produzir animações de alta qualidade que mantenham a consistência temporal e sejam visualmente atraentes ainda apresenta um desafio significativo. Um dos principais obstáculos para os desenvolvedores é a necessidade de coordenação intricada entre posições de cabeça, expressões visuais e movimentos labiais para criar um efeito visualmente atraente. Os métodos existentes não conseguiram superar esses desafios, principalmente porque a maioria deles depende de geradores de capacidade limitada, como NeRF, decodificadores baseados em movimento e GAN para criação de conteúdo visual. Essas redes exibem capacidades de generalização limitadas e são instáveis na geração de conteúdo de alta qualidade. No entanto, o surgimento recente de modelos de difusão facilitou a geração de imagens de alta qualidade, e alguns frameworks construídos sobre modelos de difusão, juntamente com módulos temporais, facilitaram a criação de vídeos atraentes, permitindo que os modelos de difusão sejam excelentes.
Com base nos avanços dos modelos de difusão, o framework AniPortrait visa gerar animações de retratos de alta qualidade usando uma imagem de referência e uma amostra de áudio. O funcionamento do framework AniPortrait é dividido em duas etapas. Na primeira etapa, o framework AniPortrait emprega modelos baseados em transformadores para extrair uma sequência de malha facial 3D e pose de cabeça a partir da entrada de áudio e as projeta subsequentemente em uma sequência de marcos faciais 2D. A primeira etapa permite que o framework AniPortrait capture movimentos labiais e expressões sutis a partir do áudio, além de movimentos de cabeça que sincronizam com o ritmo da amostra de áudio. A segunda etapa, o framework AniPortrait emprega um modelo de difusão robusto e o integra com um módulo de movimento para transformar a sequência de marcos em uma animação de retrato fotorealista e temporalmente consistente. Para ser mais específico, o framework AniPortrait se baseia na arquitetura de rede do modelo AnimateAnyone, que emprega o Stable Diffusion 1.5, um modelo de difusão potente, para gerar imagens realistas e fluidas com base em uma imagem de referência e uma sequência de movimento corporal. O que é notável é que o framework AniPortrait não usa o módulo de pose guider dentro dessa rede, como implementado no framework AnimateAnyone, mas o redesenha, permitindo que o framework AniPortrait não apenas mantenha um design leve, mas também exiba precisão aprimorada na geração de movimentos labiais.
Os resultados experimentais demonstram a superioridade do framework AniPortrait na criação de animações com naturalidade facial impressionante, qualidade visual excelente e poses variadas. Ao empregar representações faciais 3D como recursos intermediários, o framework AniPortrait ganha flexibilidade para modificar essas representações de acordo com suas necessidades. A adaptabilidade aumenta significativamente a aplicabilidade do framework AniPortrait em domínios que incluem reencenação facial e edição de movimento facial.
AniPortrait: Funcionamento e Metodologia
O framework AniPortrait proposto compreende dois módulos, nomeadamente Lmk2Video e Audio2Lmk. O módulo Audio2Lmk tenta extrair uma sequência de marcos que captura movimentos labiais intricados e expressões faciais a partir da entrada de áudio, enquanto o módulo Lmk2Video usa essa sequência de marcos para gerar vídeos de retrato de alta qualidade com estabilidade temporal. A figura a seguir apresenta uma visão geral do funcionamento do framework AniPortrait. Como pode ser observado, o framework AniPortrait primeiro extrai a malha facial 3D e a pose de cabeça do áudio e as projeta subsequentemente em pontos-chave 2D. Na segunda etapa, o framework emprega um modelo de difusão para transformar os pontos-chave 2D em um vídeo de retrato com duas etapas sendo treinadas concorrentemente dentro da rede.

Audio2Lmk
Para uma sequência dada de trechos de fala, o objetivo principal do framework AniPortrait é prever a sequência correspondente de malha facial 3D com representações vetoriais de translação e rotação. O framework AniPortrait emprega o método pré-treinado wav2vec para extrair recursos de áudio, e o modelo exibe uma alta capacidade de generalização, sendo capaz de reconhecer entonação e pronúncia a partir do áudio com precisão, o que desempenha um papel crucial na geração de animações faciais realistas. Ao aproveitar os recursos de fala robustos adquiridos, o framework AniPortrait é capaz de empregar uma arquitetura simples, consistindo de duas camadas fc, para converter esses recursos em malhas faciais 3D. O framework AniPortrait observa que esse design direto implementado pelo modelo não apenas melhora a eficiência do processo de inferência, mas também garante a precisão. Quando converte áudio para pose, o framework AniPortrait emprega a mesma rede wav2vec como backbone, embora o modelo não compartilhe os pesos com o módulo áudio-para-malha. Isso ocorre principalmente porque a pose está mais associada ao tom e ao ritmo presentes no áudio, que têm uma ênfase diferente em comparação com as tarefas áudio-para-malha. Para levar em conta o impacto dos estados anteriores, o framework AniPortrait emprega um decodificador de transformador para decodificar a sequência de pose. Durante esse processo, o framework integra os recursos de áudio no decodificador usando mecanismos de atenção cruzada, e para ambos os módulos, o framework os treina usando a perda L1. Uma vez que o modelo obtém a pose e a sequência de malha, ele emprega a projeção perspectiva para transformar essas sequências em uma sequência 2D de marcos faciais, que são então utilizados como sinais de entrada para a etapa subsequente.
Lmk2Video
Para uma imagem de referência de retrato e uma sequência de marcos faciais dados, o módulo Lmk2Video proposto cria uma animação de retrato temporalmente consistente, e essa animação alinha o movimento com a sequência de marcos, mantém uma aparência consistente com a imagem de referência e, finalmente, o framework representa a animação de retrato como uma sequência de quadros de retrato. A estrutura de rede do módulo Lmk2Video busca inspiração no framework AnimateAnyone existente. O framework AniPortrait emprega o Stable Diffusion 1.5, um modelo de difusão extremamente potente, como seu backbone, e incorpora um módulo de movimento temporal que efetivamente converte entradas de ruído multi-quadro em uma sequência de quadros de vídeo. Ao mesmo tempo, um componente de rede ReferencenNet espelha a estrutura do Stable Diffusion 1.5 e o emprega para extrair informações de aparência da imagem de referência, integrando-as no backbone. O design estratégico garante que a identidade facial permaneça consistente em todo o vídeo de saída. Diferentemente do framework AnimateAnyone, o framework AniPortrait aprimora a complexidade do design do PoseGuider. A versão original do framework AnimateAnyone compreende apenas algumas camadas de convolução após as quais os recursos de marcos se misturam com os latentes na camada de entrada do backbone. O framework AniPortrait descobre que o design é insuficiente para capturar movimentos intricados dos lábios, e para resolver esse problema, o framework adota a estratégia multi-escala da arquitetura ConvNet, incorporando recursos de marcos de escalas correspondentes em diferentes blocos do backbone. Além disso, o framework AniPortrait introduz uma melhoria adicional, incluindo os marcos da imagem de referência como uma entrada adicional. O módulo de atenção cruzada do componente PoseGuider facilita a interação entre os marcos de destino de cada quadro e os marcos de referência. Esse processo fornece à rede dicas adicionais para compreender a correlação entre a aparência e os marcos faciais, ajudando assim na geração de animações de retrato com movimento mais preciso.
AniPortrait: Implementação e Resultado
Para a etapa Audio2Lmk, o framework AniPortrait adota o componente wav2vec2.0 como seu backbone e aproveita a arquitetura MediaPipe para extrair malhas 3D e poses 6D para anotações. O modelo obtém os dados de treinamento para o componente Audio2Mesh a partir de seu conjunto de dados interno, que compreende cerca de 60 minutos de dados de fala de alta qualidade provenientes de um único falante. Para garantir que a malha 3D extraída pelo componente MediaPipe seja estável, o ator de voz é instruído a enfrentar a câmera e manter uma posição de cabeça estável durante todo o processo de gravação. Para o módulo Lmk2Video, o framework AniPortrait implementa uma abordagem de treinamento em duas etapas. Na primeira etapa, o framework se concentra em treinar a ReferenceNet e o PoseGuider, a parte 2D do backbone, e deixa de lado o módulo de movimento. Na segunda etapa, o framework AniPortrait congela todos os outros componentes e se concentra em treinar o módulo de movimento. Para essa etapa, o framework utiliza dois conjuntos de dados de vídeo facial de alta qualidade e grande escala para treinar o modelo e processa todos os dados usando o componente MediaPipe para extrair marcos faciais 2D. Além disso, para aumentar a sensibilidade da rede em relação aos movimentos labiais, o modelo AniPortrait diferencia os lábios superiores e inferiores com cores distintas ao renderizar a imagem de pose a partir de marcos 2D.
Como demonstrado na imagem a seguir, o framework AniPortrait gera uma série de animações que demonstram qualidade superior e realismo.

O framework então utiliza uma representação intermediária 3D que pode ser editada para manipular a saída de acordo com as necessidades. Por exemplo, os usuários podem extrair marcos de uma fonte específica e alterar sua identidade, permitindo assim que o framework AniPortrait crie um efeito de reencenação facial.
Pensamentos Finais
Neste artigo, falamos sobre o AniPortrait, um framework novo projetado para gerar animações de alta qualidade impulsionadas por uma imagem de referência e uma amostra de áudio. Ao simplesmente inserir uma imagem de referência e um clipe de áudio, o framework AniPortrait é capaz de gerar um vídeo de retrato que apresenta movimento natural de cabeça e movimento suave dos lábios. Ao aproveitar as capacidades de generalização robustas do modelo de difusão, o framework AniPortrait gera animações que exibem qualidade de imagem realista impressionante e movimento realista. O funcionamento do framework AniPortrait é dividido em duas etapas. Primeiro, o framework AniPortrait extrai as representações intermediárias 3D das amostras de áudio e as projeta em uma sequência de marcos faciais 2D. Em seguida, o framework emprega um modelo de difusão robusto acoplado a um módulo de movimento para converter a sequência de marcos em animações temporais consistentes e fotorealistas. Os resultados experimentais demonstram a superioridade e a capacidade do framework AniPortrait de gerar animações de alta qualidade com qualidade visual excepcional, diversidade de pose e naturalidade facial, oferecendo assim uma experiência perceptual aprimorada e enriquecida. Além disso, o framework AniPortrait tem um potencial notável em termos de controllabilidade e flexibilidade e pode ser aplicado de forma eficaz em áreas que incluem reencenação facial, edição de movimento facial e muito mais.


