
Liderzy opinii
Dlaczego jakość danych decyduje o powodzeniu lub niepowodzeniu sztucznej inteligencji w przedsiębiorstwach

 Dodaj Unite.AI do preferowanych źródeł w Google
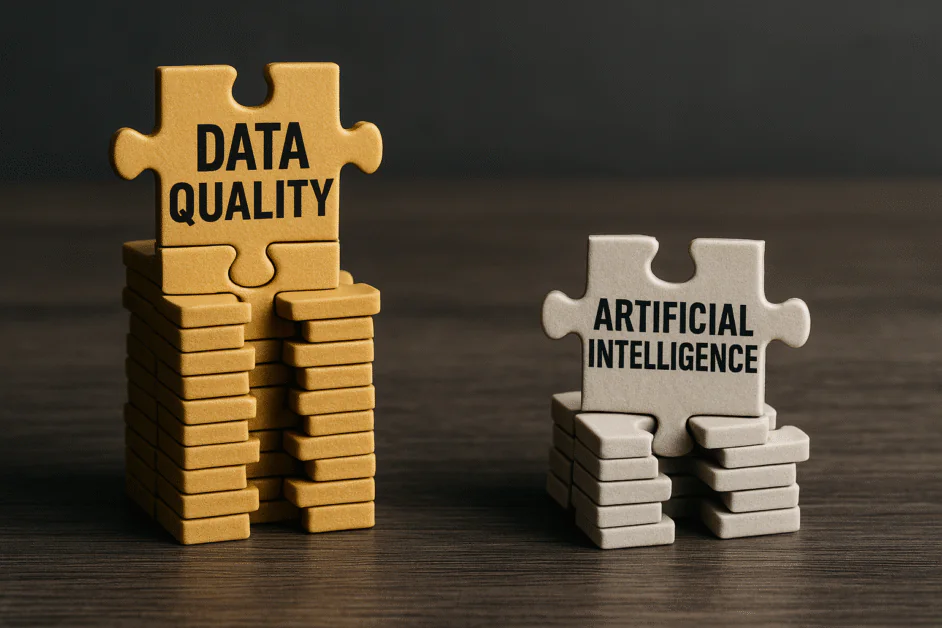
Od czasu debiutu ChatGPT przez OpenAI pod koniec 2022 roku każda firma próbuje przyspieszyć rozwój sztucznej inteligencji. Duży producenci sprzętu, tacy jak Nvidia (NVDA ), sprzedają więcej kart graficznych niż kiedykolwiek wcześniej, podczas gdy duzi twórcy modeli, tacy jak OpenAI i Anthropic, nadal budują coraz większe modele.
Jednak nawet z najbardziej zaawansowanymi modelami i największymi budżetami wiele projektów sztucznej inteligencji nadal zawodzi. Zaobserwowaliśmy to we wszystkich branżach, od opieki zdrowotnej po transport i finanse. Powód nie jest odległy: sztuczna inteligencja jest tylko tak dobra, jak dane, na których została wyszkolona i które otrzymuje w czasie rzeczywistym. Kiedy te dane są słabo oznaczone, przestarzałe lub niekompletne, żaden model nie może dostarczyć spójnych ani godnych zaufania wyników.
To jest duży problem, z którym borykają się dzisiaj wiele firm. Inwestują dużo w narzędzia sztucznej inteligencji, podczas gdy ich systemy danych pozostają rozproszone i niewiarygodne. Rezultatem jest iluzja postępu. Podczas gdy modele dostarczają imponujące odpowiedzi, wnioski są często oparte na słabych podstawach. Prawdzićą barierą dla sukcesu sztucznej inteligencji nie jest wydajność modelu. Jest to jakość danych.
Co to jest dobra jakość danych
Dobra jakość danych nie oznacza tylko dokładności. Oznacza informacje, które są aktualne, kompletne i istotne dla problemu, który jest rozwiązywany. Wyobraź sobie klienta, który próbuje anulować zamówienie na stronie internetowej. System musi sprawdzić szczegóły zamówienia, status dostawy i rekord płatności. Jeśli którekolwiek z tych punktów danych znajdują się w różnych systemach, które nie komunikują się ze sobą, asystent sztucznej inteligencji nie będzie w stanie dostarczyć przydatnej odpowiedzi.
Dobra jakość danych łączy te punkty natychmiast. Pozwala sztucznej inteligencji zobaczyć pełny obraz, a nie tylko fragmenty. Słaba jakość danych zmusza model do zgadywania. A kiedy sztuczna inteligencja zaczyna zgadywać, popełnia błędy, które kosztują pieniądze i niszczą zaufanie. Ostatnie przykłady pokazują, jak niebezpieczne mogą być takie założenia.
Chatbot biznesowy Nowego Jorku udzielał nielegalnych rad, ponieważ korzystał ze starej lub niekompletnej informacji prawnej. Bot obsługi klienta Air Canada (AC.TO ) składał fałszywe roszczenia o zwrot pieniędzy, ponieważ nie miał kontekstu z polityki firmy. Nawet duże systemy rekrutacyjne niesłusznie odrzucały kandydatów z powodu tendencyjnych lub źle oznaczonych danych, jak to widać w pierwszym porozumieniu EEOC dotyczącym sztucznej inteligencji. Te porażki nie są tylko techniczne. Są to porażki wizerunkowe i finansowe, i wynikają z systemów sztucznej inteligencji, które zostały wyszkolone na niewiarygodnych danych.
Badania branżowe potwierdzają skalę tego problemu. Gartner donosi, że 80 procent projektów sztucznej inteligencji nie udaje się skalować z powodu słabej jakości i zarządzania danymi. Podobnie, ankieta MIT Sloan Management Review wykazała, że problemy z danymi, a nie algorytmy, są głównym powodem, dla którego projekty sztucznej inteligencji w przedsiębiorstwach zawodzą.
Kultura jest równie ważna jak kod
Poprawa jakości danych nie jest czymś, co można naprawić za pomocą jednego narzędzia lub polecenia. Wymaga zmiany kulturowej. Dlatego liderzy biznesu muszą traktować dane jako żywy system, który wymaga opieki i odpowiedzialności. To nie jest tylko oświadczenie, że “chcemy uczynić dane lepszymi” – to nie wystarczy. Każda część organizacji musi zrozumieć, jak informacje są przekazywane, kto je posiada i co się dzieje, gdy się zmieniają.
Widzieliśmy, jak to się odbywa w prawdziwych systemach. Wiele aplikacji sztucznej inteligencji opiera się na nocnych aktualizacjach danych. Jeśli Twoja baza danych jest aktualizowana raz dziennie, wiedza Twojego modelu zawsze będzie opóźniona w stosunku do rzeczywistości. W szybko zmieniających się środowiskach ten opóźnienie może oznaczać przestarzałe wnioski i złe decyzje. Firmy muszą przemyśleć cały przepływ danych, od tego, jak informacje są zbierane, do tego, jak są dostarczane do modelu.
Robienie tego dobrze może zaoszczędzić ogromne ilości czasu i pieniędzy. Kiedy potoki danych są zaprojektowane z wyrazistością i celem, systemy sztucznej inteligencji mogą uczyć się i działać na najbardziej aktualnych i istotnych informacjach. Kiedy nie są, zespoły spędzają więcej czasu na czyszczeniu danych niż na ich używaniu.
Eksperci w zarządzaniu danymi często podkreślają, że kluczem do silnej jakości danych jest pętla sprzężenia zwrotnego między ludźmi, procesami i platformami. Bez tej pętli informacje stają się stare i modele tracą kontakt z warunkami świata rzeczywistego – problem, który czasami nazywa się dryftem danych.
Balance między szybkością a integralnością
Często istnieje napięcie między szybkością a dokładnością. Wiele organizacji chce natychmiastowych wyników z inwestycji w sztuczną inteligencję, ale pośpiech może prowadzić do większych problemów później. Celem powinna być elastyczność danych z integralnością. Innymi słowy, budowanie systemów, które mogą poruszać się szybko bez utraty precyzji.
W tym celu każda firma powinna określić wyraźne ścieżki, aby dane płynęły z ich źródła do modelu w czasie rzeczywistym. Pomaga to również określić, jaki rodzaj informacji jest dozwolony i co musi pozostać poza modelem. Wrażliwe lub prywatne dane nie powinny nigdy dotrzeć do modelu, nawet jeśli użytkownik technicznie ma do nich dostęp. Ochrona tej granicy buduje zaufanie i utrzymuje systemy sztucznej inteligencji przed ujawnieniem lub niewłaściwym użyciem informacji.
Podczas gdy sztuczna inteligencja staje się bardziej autonomiczna, nadzór ludzki pozostanie krytyczny. Model nie powinien mieć pełnej kontroli nad działaniami biznesowymi. Nie powinien również podejmować decyzji. Zamiast tego powinien składać wnioski. Co więcej, ludzie muszą zawsze przeglądać i zatwierdzać jego działania, aby upewnić się, że są zgodne z polityką firmy i regulacjami.
Budowanie jakości od podstaw
Utrzymywanie jakości danych w skali nie jest tylko kwestią czyszczenia błędów. Zaczyna się od architektury. Trzeba określić, gdzie znajdują się Twoje najbardziej wiarygodne dane, a następnie zaprojektować system, który łączy je w jednej zaufanej lokalizacji. Stamtąd można śledzić, które dane model używa i skąd pochodzą.
Ten podejście zapobiega zamieszaniu i utrzymuje system transparentny. Pomaga również zespołom rozwiązywać problemy szybciej, gdy coś pójdzie nie tak. Kiedy wiesz dokładnie, które dane karmiły odpowiedź modelu, możesz zweryfikować i poprawić problemy, zanim się rozprzestrzenią.
Przyszłość sztucznej inteligencji w przedsiębiorstwach będzie należeć do firm, które wbudowują jakość w swoją infrastrukturę domyślnie. Oczekujemy, że zobaczymy więcej gotowych systemów sztucznej inteligencji, które obsługują zarówno rozumowanie, jak i integrację danych w jednym pakiecie. Te “urządzenia sztucznej inteligencji” mogą ułatwić firmom wdrożenie inteligentnych systemów bez utraty kontroli nad danymi.
Analitycy przewidują, że organizacje, które są w stanie ujednolicić i zarządzać swoimi danymi skutecznie, zobaczą szybsze wdrożenie i wyższy zwrot z inwestycji w projekty sztucznej inteligencji. Ostatni raport o gotowości danych wyjaśnia, że ta zdolność oddziela firmy, które innowują ciągle, od tych, które zatrzymują się po wstępnych testach. Różnica często sprowadza się do tego, czy ich systemy sztucznej inteligencji są zbudowane na spójnych, dobrze ustrukturyzowanych informacjach.
Podsumowanie
Jakość danych może nie brzmieć ekscytująco w porównaniu z przełomami w projekcie modelu, ale jest cichą siłą, która decyduje, czy sztuczna inteligencja powiedzie się, czy nie. Bez czystych, aktualnych i spójnych danych, najbardziej zaawansowane systemy potkną się. Z nimi, nawet skromne projekty sztucznej inteligencji mogą tworzyć trwałą wartość.
Każdy lider inwestujący w sztuczną inteligencję powinien zadać sobie proste pytanie: Czy ufamy danym, które napędzają nasze decyzje? Z tego, co widzieliśmy, firmy, które mogą odpowiedzieć “tak” z pewnością, są już liderami w wyścigu sztucznej inteligencji.


