
Podstawy AI
Czym jest zatruwanie danych? Jak atakujący zniekształcają modele AI i zbiory danych
Zatruwanie danych polega na manipulowaniu danymi używanymi do trenowania, dostrajania, ewaluacji lub wyszukiwania, aby system AI nauczył się błędnego zachowania albo generował wyniki wybrane przez atakującego. W tym przewodniku wyjaśniamy mechanizm, kompromisy, metody ewaluacji i zabezpieczenia, które mają znaczenie w praktyce.

 Dodaj Unite.AI do preferowanych źródeł w Google
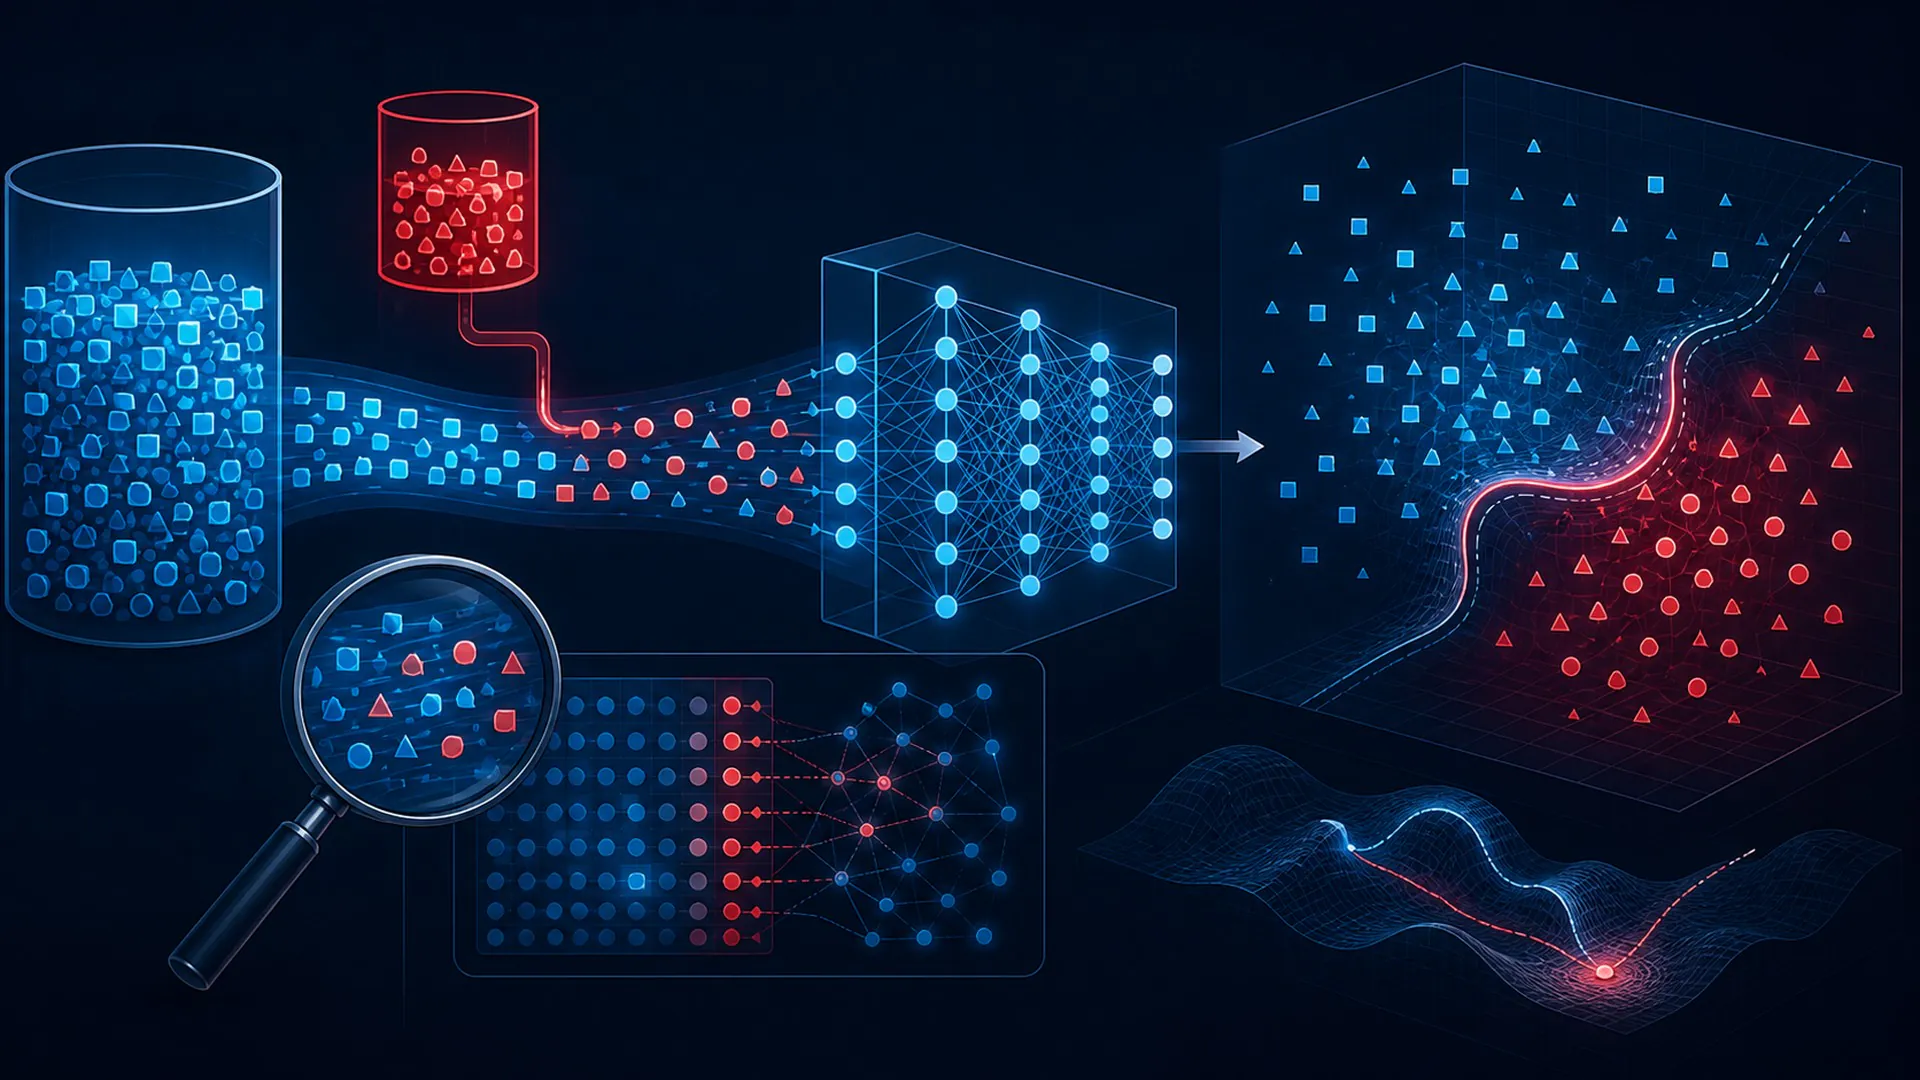
Zatruwanie danych polega na manipulowaniu danymi treningowymi, dostrajającymi, ewaluacyjnymi lub danymi wykorzystywanymi do wyszukiwania, tak aby system AI nauczył się nieprawidłowych zachowań lub generował wyniki wybrane przez atakującego.
Zatruwanie danych wymaga precyzyjnego wyjaśnienia, ponieważ jego nazwa wskazuje na określony przepływ informacji, wybór dotyczący trenowania, mechanizm działania w czasie wykonywania programu lub granicę nadzoru. Traktowanie go jako synonimu „zaawansowanej AI” uniemożliwia weryfikację twierdzeń. Ten przewodnik omawia to pojęcie od danych wejściowych i założeń po obserwowalny rezultat, a następnie analizuje uproszczenie, które najłatwiej z nim pomylić.
Zatruwanie danych: definicja, granice i cel
Zatruwanie danych polega na manipulowaniu danymi treningowymi, dostrajającymi, ewaluacyjnymi lub danymi wykorzystywanymi do wyszukiwania, tak aby system AI nauczył się nieprawidłowych zachowań lub generował wyniki wybrane przez atakującego. Definicja ta obejmuje trzy praktyczne założenia: istnieje możliwe do zidentyfikowania wejście, przekształcenie lub decyzja charakterystyczne dla zatruwania danych oraz wynik, który można ocenić względem określonego celu. Jeśli brakuje któregokolwiek z tych elementów, określenie to może opisywać zamierzenie, a nie wdrożony mechanizm.
Wiarygodna AI wymaga dowodów zebranych na każdym etapie cyklu życia. Mechanizm kontrolny ma znaczenie tylko wtedy, gdy jasno określono jego właściciela, zakres, warunek uruchomienia, oczekiwane działanie i metodę weryfikacji. W przypadku zatruwania danych takie spojrzenie na cały system jest istotne, ponieważ na jego działanie mogą wpływać otaczające dane, interfejsy, sprzęt, uprawnienia i ludzie, nawet gdy sam model pozostaje bez zmian. Dlatego rzetelne wyjaśnienie oddziela zachowanie wyuczone przez model od produktu, który decyduje, kiedy, gdzie i z jakimi uprawnieniami to zachowanie zostanie wykorzystane.
Najbliższym mylącym uproszczeniem jest atak polegający na unikaniu wykrycia, przeprowadzany dopiero po wdrożeniu modelu. Może on mieć widoczną cechę wspólną z zatruwaniem danych, ale zmienia związek przyczynowy: powodzenie potwierdzałyby inne dowody, o kosztach decydowałyby inne zasoby, a szkód zapobiegałyby inne mechanizmy kontrolne. Granica ma więc charakter operacyjny, a nie terminologiczny.
Pięcioetapowa mapa działania zatruwania danych
Diagram przedstawia zwięzłą mapę zależności przyczynowych w zatruwaniu danych; nie oznacza to, że każda implementacja składa się z pięciu komponentów oprogramowania. Niektóre systemy łączą etapy, a inne powtarzają je w pętli. Mapa pozostaje przydatna, ponieważ wymaga wskazania właściciela, danych wejściowych, wyniku i testu dla każdej zmiany informacji lub zakresu uprawnień.
1. Uzyskanie wpływu na źródło danych: dane wejściowe i założenia dotyczące zatruwania danych
Na tym etapie zatruwania danych system musi uzyskać wpływ na źródło danych. Warto zapytać nie tylko, czy dana operacja zachodzi, lecz także jakie informacje wykorzystuje, jaki stan zmienia i jakie dowody potwierdzają prawidłowość tej zmiany. Osoba weryfikująca powinna móc odróżnić tę operację od ataku polegającego na unikaniu wykrycia, przeprowadzanego dopiero po wdrożeniu modelu, a także odtworzyć jej wynik w tych samych, określonych warunkach.
Przekazanie na tym etapie zatruwania danych rozpoczyna się od określonego celu, a powinno zakończyć wynikiem, który umożliwi wprowadzenie błędnie oznaczonych, stronniczych lub zawierających wyzwalacz przykładów. Należy odnotować niepewność, odrzucone alternatywy, wykorzystane zasoby oraz wszelkie mechanizmy kontroli stosowane przez ludzi lub oprogramowanie na granicy etapu. Taki zapis pozwala zespołom wykryć, czy niewielki, ukierunkowany podzbiór danych może być trudny do wykrycia w danych o skali internetu, zanim ta sama słabość wpłynie na istotny wynik.
2. Wprowadzenie błędnie oznaczonych, stronniczych lub zawierających wyzwalacz przykładów: sposób reprezentacji lub decyzja w procesie zatruwania danych
Na tym etapie zatruwania danych system musi wprowadzić błędnie oznaczone, stronnicze lub zawierające wyzwalacz przykłady. Warto zapytać nie tylko, czy dana operacja zachodzi, lecz także jakie informacje wykorzystuje, jaki stan zmienia i jakie dowody potwierdzają prawidłowość tej zmiany. Osoba weryfikująca powinna móc odróżnić tę operację od ataku polegającego na unikaniu wykrycia, przeprowadzanego dopiero po wdrożeniu modelu, a także odtworzyć jej wynik w tych samych, określonych warunkach.
Przekazanie na tym etapie zatruwania danych rozpoczyna się od uzyskania wpływu na źródło danych, a powinno zakończyć wynikiem, który pozwoli przetrwać filtrowanie i deduplikację. Należy odnotować niepewność, odrzucone alternatywy, wykorzystane zasoby oraz wszelkie mechanizmy kontroli stosowane przez ludzi lub oprogramowanie na granicy etapu. Taki zapis pozwala zespołom wykryć, czy niewielki, ukierunkowany podzbiór danych może być trudny do wykrycia w danych o skali internetu, zanim ta sama słabość wpłynie na istotny wynik.
3. Przejście przez filtrowanie i deduplikację: charakterystyczna transformacja w zatruwaniu danych
Na tym etapie zatruwania danych system musi przejść przez filtrowanie i deduplikację. Istotne pytanie nie brzmi jedynie, czy dana operacja zachodzi, lecz także jakie informacje wykorzystuje, jaki stan zmienia i jakie dowody potwierdzają, że zmiana była prawidłowa. Osoba dokonująca przeglądu powinna móc odróżnić tę operację od ataku unikowego przeprowadzanego dopiero po wdrożeniu modelu oraz odtworzyć jej wynik w tych samych określonych warunkach.
Przekazanie na tym etapie zatruwania danych zaczyna się od wprowadzenia przykładów z błędnymi etykietami, obciążonych tendencyjnością lub zawierających wyzwalacz, a jego efektem powinien być wynik, który może posłużyć do modyfikacji wyuczonego modelu lub pobranego kontekstu. Należy odnotować niepewność, odrzucone alternatywy, wykorzystane zasoby oraz wszelkie kontrole stosowane na tym etapie przez człowieka lub oprogramowanie. Dzięki temu zespoły mogą wykryć, czy niewielki, ukierunkowany podzbiór może być trudny do wykrycia w danych w skali internetu, zanim ta sama słabość doprowadzi do istotnych konsekwencji.
4. Modyfikacja wyuczonego modelu lub pobranego kontekstu: granica ograniczeń i weryfikacji w zatruwaniu danych
Na tym etapie zatruwania danych system musi zmodyfikować wyuczony model lub pobrany kontekst. Istotne pytanie nie brzmi jedynie, czy dana operacja zachodzi, lecz także jakie informacje wykorzystuje, jaki stan zmienia i jakie dowody potwierdzają, że zmiana była prawidłowa. Osoba dokonująca przeglądu powinna móc odróżnić tę operację od ataku unikowego przeprowadzanego dopiero po wdrożeniu modelu oraz odtworzyć jej wynik w tych samych określonych warunkach.
Przekazanie na tym etapie zatruwania danych zaczyna się od przejścia przez filtrowanie i deduplikację, a jego efektem powinien być wynik, który może doprowadzić do powszechnego pogorszenia działania lub uruchomienia ukierunkowanej tylnej furtki. Należy odnotować niepewność, odrzucone alternatywy, wykorzystane zasoby oraz wszelkie kontrole stosowane na tym etapie przez człowieka lub oprogramowanie. Dzięki temu zespoły mogą wykryć, czy niewielki, ukierunkowany podzbiór może być trudny do wykrycia w danych w skali internetu, zanim ta sama słabość doprowadzi do istotnych konsekwencji.
5. Uruchomienie powszechnego pogorszenia działania lub ukierunkowanej tylnej furtki: wyniki, informacje zwrotne i reguła zatrzymania w zatruwaniu danych
Na tym etapie zatruwania danych system musi uruchomić powszechne pogorszenie działania lub ukierunkowaną tylną furtkę. Istotne pytanie nie brzmi jedynie, czy dana operacja zachodzi, lecz także jakie informacje wykorzystuje, jaki stan zmienia i jakie dowody potwierdzają, że zmiana była prawidłowa. Osoba dokonująca przeglądu powinna móc odróżnić tę operację od ataku unikowego przeprowadzanego dopiero po wdrożeniu modelu oraz odtworzyć jej wynik w tych samych określonych warunkach.
Przekazanie na tym etapie zatruwania danych zaczyna się od modyfikacji wyuczonego modelu lub pobranego kontekstu, a jego efektem powinien być wynik, który może posłużyć do monitorowania lub podjęcia ostatecznej decyzji. Należy odnotować niepewność, odrzucone alternatywy, wykorzystane zasoby oraz wszelkie kontrole stosowane na tym etapie przez człowieka lub oprogramowanie. Dzięki temu zespoły mogą wykryć, czy niewielki, ukierunkowany podzbiór może być trudny do wykrycia w danych w skali internetu, zanim ta sama słabość doprowadzi do istotnych konsekwencji.
Analizuj mapę zatruwania danych od początku do końca, aby zrozumieć działanie systemu w środowisku produkcyjnym, a także od końca do początku, by diagnozować awarie. Analiza w przód bada, w jaki sposób jeden etap dostarcza dane do następnego. Analiza wsteczna rozpoczyna się od nieprawidłowego, powolnego, kosztownego lub niebezpiecznego wyniku i pozwala prześledzić, które wcześniejsze założenie do niego doprowadziło. Często właśnie na tej drodze zespół odkrywa, że kluczowy błąd wystąpił, zanim model wygenerował jakikolwiek wynik.
Przykład zatruwania danych krok po kroku
Atakujący może dodać przykłady, które nauczą klasyfikator uznawać rzadko występujący wzór wizualny za zaufaną etykietę.
Ten przykład jest pouczający, ponieważ zatruwanie danych można powiązać z obserwowalnymi danymi wejściowymi, stanami pośrednimi i wynikiem, zamiast oceniać je na podstawie dopracowanej demonstracji. Rzetelny test obejmowałby zwykłe, trudne i celowo wprowadzające w błąd przypadki związane z tym scenariuszem, zachowywałby punkt odniesienia bez zastosowania tej techniki oraz rejestrował zarówno średnią skuteczność, jak i dotkliwość poszczególnych błędów.
Zmień jedno założenie w przykładzie zatruwania danych i powtórz analizę. Usuń wymagane dane wejściowe, wprowadź sprzeczny sygnał, ogranicz moc obliczeniową, zmień populację użytkowników lub zmuś system do wstrzymania się od odpowiedzi. Mechanizm, który działa wyłącznie w jednej starannie przygotowanej demonstracji, nie dowodzi, że uogólnia się na środowisko operacyjne.
Zatruwanie danych a jego najczęstsze uproszczenie
Zatruwanie danych często sprowadza się do ataku unikowego przeprowadzanego dopiero po wdrożeniu modelu. Takie uproszczenie usuwa granicę, która definiuje to pojęcie. Może przez to prowadzić do porównywania przez kupujących nieporównywalnych produktów, wyolbrzymiania przez badaczy tego, co dowodzi eksperyment, oraz monitorowania przez operatorów niewłaściwego sygnału po wdrożeniu.
| Perspektywa | Praktyczna odpowiedź |
|---|---|
| Definicja | Zatruwanie danych polega na manipulowaniu danymi treningowymi, dostrajającymi, ewaluacyjnymi lub wykorzystywanymi do wyszukiwania, tak aby system AI nauczył się zniekształconych zachowań lub generował wyniki wybrane przez atakującego. |
| Pomylenie pojęć | atak unikowy przeprowadzany dopiero po wdrożeniu modelu. |
| Ryzyko | niewielki, celowo wybrany podzbiór może być trudny do wykrycia w danych o skali internetu. |
Porównanie powinno również wskazywać jednostkę analizy. Artykuł o zatruwaniu danych może koncentrować się na modelu lub algorytmie, podczas gdy wdrożona usługa obejmuje dodatkowo wyszukiwanie, kierowanie żądań, buforowanie, zasady, tożsamość, interfejsy użytkownika i monitorowanie. Dwa produkty mogą posługiwać się tym samym ogólnym określeniem, a jednocześnie wdrażać różne elementy tego stosu. Należy ustalić, który komponent wykonuje kluczową transformację, a które pozostałe są niezbędne do uzyskania zgłoszonego wyniku.
Dlaczego zatruwanie danych ma znaczenie we współczesnych systemach AI
Zatruwanie danych ma dziś znaczenie, ponieważ systemy AI otrzymują coraz obszerniejszy kontekst, obsługują więcej modalności, dysponują większą mocą obliczeniową w czasie działania, uzyskują szerszy dostęp do narzędzi i są ściślej powiązane z decyzjami organizacyjnymi. W takich warunkach to, co wcześniej wydawało się szczegółem badawczym, może przesądzić o opóźnieniach, bezpieczeństwie, dostępności, kosztach środowiskowych, jakości produktu lub odpowiedzialności prawnej.
Istotne pytanie nie brzmi, czy zatruwanie danych może przynieść jeden imponujący wynik. Chodzi o to, czy technika poprawia istotny rezultat w reprezentatywnych warunkach i robi to skuteczniej niż prostsze rozwiązanie bazowe. Zamiast sprowadzać wszystkie wyniki do jednej średniej, należy raportować rozkłady, kategorie błędów, opóźnienia w wysokich percentylach, zużycie zasobów oraz wyniki dla poszczególnych grup, na które oddziałuje system.
Należy monitorować zarówno wskaźniki techniczne, jak i wpływ systemu na ludzi. Trzeba dokumentować niepewność, zachowywać informacje o pochodzeniu, umożliwiać eskalację i zaplanować przywracanie działania, zanim system zostanie wystawiony na zmienne warunki rzeczywiste. W przypadku zatruwania danych takie podejście sprawia, że zgromadzone dowody można odnieść do innych warunków: inny zespół może ocenić, czy deklarowana poprawa prawdopodobnie utrzyma się w przypadku innego modelu, języka, platformy sprzętowej, zbioru danych, populacji użytkowników lub poziomu tolerancji ryzyka.
Korzyści, jakie może przynieść zatruwanie danych
Najważniejszym powodem stosowania zatruwania danych jest to, że może ono bezpośrednio rozwiązywać problem stanowiący cel działania. W zależności od wdrożenia korzyścią może być lepsze oparcie odpowiedzi na źródłach, wierniejsze odwzorowanie, lepsza zdolność uogólniania, krótsze opóźnienia, ograniczenie przesyłania danych między pamięciami, wyraźniejsze określenie odpowiedzialności lub bezpieczniejsza granica między propozycją modelu a rzeczywistym działaniem.
Korzyści należy opisywać za pomocą decyzji i pomiarów. „Większa inteligencja” nie jest kryterium akceptacji dla zatruwania danych. Przydatny cel może określać na przykład wskaźnik błędów w trudnych przypadkach, możliwość powrotu do prawidłowego działania po pojawieniu się sprzecznych dowodów, koszt przy określonym percentylu ruchu, czas weryfikacji przez człowieka, kalibrację lub odsetek działań mieszczących się w ustalonym limicie uprawnień.
Charakterystyczny tryb awarii zatruwania danych
Głównym ograniczeniem jest to, że niewielki, celowo wybrany podzbiór może być trudny do wykrycia w danych o skali internetu. Nie jest to problem, który można potraktować jako dopisek po zakończeniu prac rozwojowych. Od samego początku powinien on wpływać na gromadzenie danych, architekturę, uprawnienia, ewaluację, kryteria dopuszczenia do wdrożenia i monitorowanie zatruwania danych.
Zabezpieczenie przed zatruwaniem danych jest przydatne tylko wtedy, gdy zadziała przed wystąpieniem kosztownych lub nieodwracalnych konsekwencji. Należy wskazać najwcześniejszy możliwy do zaobserwowania sygnał poprzedzający awarię, ustalić próg lub regułę, wyznaczyć osobę odpowiedzialną i przetestować procedurę przywracania działania. W zależności od zastosowania może ona polegać na wstrzymaniu się od odpowiedzi, przejściu na prostszy system, zażądaniu dodatkowych dowodów, przekazaniu sprawy człowiekowi, przywróceniu wcześniejszej wersji modelu lub całkowitym zatrzymaniu działania.
Plan ewaluacji zatruwania danych
Ocenę zatruwania danych zacznij od określenia, jaką decyzję mają uzasadnić zebrane dowody. Zdefiniuj populację, w której system będzie działać, konsekwencje błędnego wyniku, informacje faktycznie dostępne w chwili podejmowania decyzji oraz najprostszą wiarygodną alternatywę. Dzięki temu benchmark nie stanie się celem tylko dlatego, że łatwo go przeprowadzić.
Do kontrolowanych porównań użyj nietkniętego zbioru testowego, a następnie sprawdź zatruwanie danych w etapowo wdrażanym środowisku operacyjnym. Ocena offline pozwala porównywać warianty, a tryb cienia, wdrożenia kanarkowe, limity częstotliwości lub bramki zatwierdzające pokazują, jak rzeczywisty ruch, pętle sprzężenia zwrotnego i ludzie wpływają na zachowanie systemu. Etap wdrożenia powinien mieć jasno określony warunek przerwania, zamiast zakładać, że każda poprawa uzasadnia pełne wdrożenie.
Wersjonuj dane i elementy potrzebne do odtworzenia procesu zatruwania danych: dane źródłowe, przetwarzanie wstępne, tokenizator lub koder, wagi modelu, konfigurację, prompt lub politykę, indeks wyszukiwania, zbiór ewaluacyjny, założenia dotyczące sprzętu oraz kod obsługujący model, jeśli ma to zastosowanie. Bez śledzenia pochodzenia zespół nie jest w stanie ustalić, czy zmieniony wynik wynika z zastosowanej techniki, środowiska czy niezauważonej modyfikacji potoku przetwarzania.
Na koniec zastanów się, jaki wynik obaliłby twierdzenie, że zatruwanie danych przynosi korzyści. Jeśli żaden wynik nie mógłby zmienić decyzji o wdrożeniu, ewaluacja jest działaniem marketingowym. Ustalone z góry progi akceptacji i zachowany zbiór potwierdzający sprawiają, że ćwiczenie staje się źródłem dowodów.
Pytania, które warto zadać przed zastosowaniem zatruwania danych
- Cel: Jakie mierzalne wąskie gardło ma rozwiązać zatruwanie danych?
- Mechanizm: Na którym z pięciu etapów zachodzi charakterystyczna transformacja?
- Punkt odniesienia: Jak wypada to rozwiązanie w porównaniu z atakiem polegającym na unikaniu wykrycia, przeprowadzanym dopiero po wdrożeniu modelu, lub z inną prostszą alternatywą?
- Dowody: Które typowe, trudne, adwersarialne i dotyczące podgrup przypadki poddano testom?
- Operacje: Jakie koszty opóźnień, pamięci, mocy obliczeniowej, energii, utrzymania i weryfikacji pojawiają się przy dużej skali?
- Ryzyko: Jak zespół wykryje, że niewielki, ukierunkowany podzbiór może być trudny do wykrycia w danych o skali internetu?
- Odzyskiwanie: Czy system może wstrzymać się od odpowiedzi, przejść na rozwiązanie zapasowe, wycofać zmiany lub przekazać sprawę do eskalacji, zanim dojdzie do szkody?
Podstawowe źródła informacji o zatruwaniu danych
Autorytatywne punkty wyjścia do analizy tej części stosu AI, która obejmuje zatruwanie danych, to ramy zarządzania ryzykiem AI NIST, specyfikacje C2PA oraz ramy ochrony prywatności NIST. Zapoznaj się z nimi równolegle z dokumentacją konkretnego modelu, zbioru danych i sprzętu, a także przepisów obowiązujących w danej jurysdykcji. Ogólne źródło może zdefiniować mechanizm, ale tylko dowody dotyczące konkretnego wdrożenia pozwalają stwierdzić, czy dane rozwiązanie jest odpowiednie.
Co warto zapamiętać o zatruwaniu danych
Zatruwanie danych to określony mechanizm w ramach większego systemu socjotechnicznego. Jego wartość wynika z poprawy konkretnego rezultatu w jasno określonych warunkach, a nie z samej nazwy. Mapa pięciu etapów uwidacznia przepływ informacji, porównanie wskazuje, czym zatruwanie danych nie jest, a ścieżka kontroli pokazuje, w którym miejscu odpowiedzialny operator może interweniować.
Praktyczna zasada dotycząca zatruwania danych jest następująca: określ cel, porównaj rozwiązanie z wiarygodnym punktem odniesienia, przetestuj najważniejszy możliwy błąd i zachowaj dowody potrzebne do monitorowania zmian. Dzięki temu zatruwanie danych staje się rozwiązaniem inżynieryjnym i sposobem zarządzania, które można ocenić. Bez tych elementów pozostaje obiecującą nazwą kryjącą nieznane ryzyko operacyjne.



