
Podstawy AI
Czym są zabezpieczenia AI? Jak systemy produkcyjne kontrolują zachowanie modelu
Zabezpieczenia AI to warstwowe kontrole techniczne i proceduralne, które ograniczają wejścia, działania, wyjścia i eskalację wokół modelu lub agenta. Ten przewodnik wyjaśnia mechanizm, kompromisy, ocenę i kontrole, które mają znaczenie w praktyce.

 Dodaj Unite.AI do preferowanych źródeł w Google
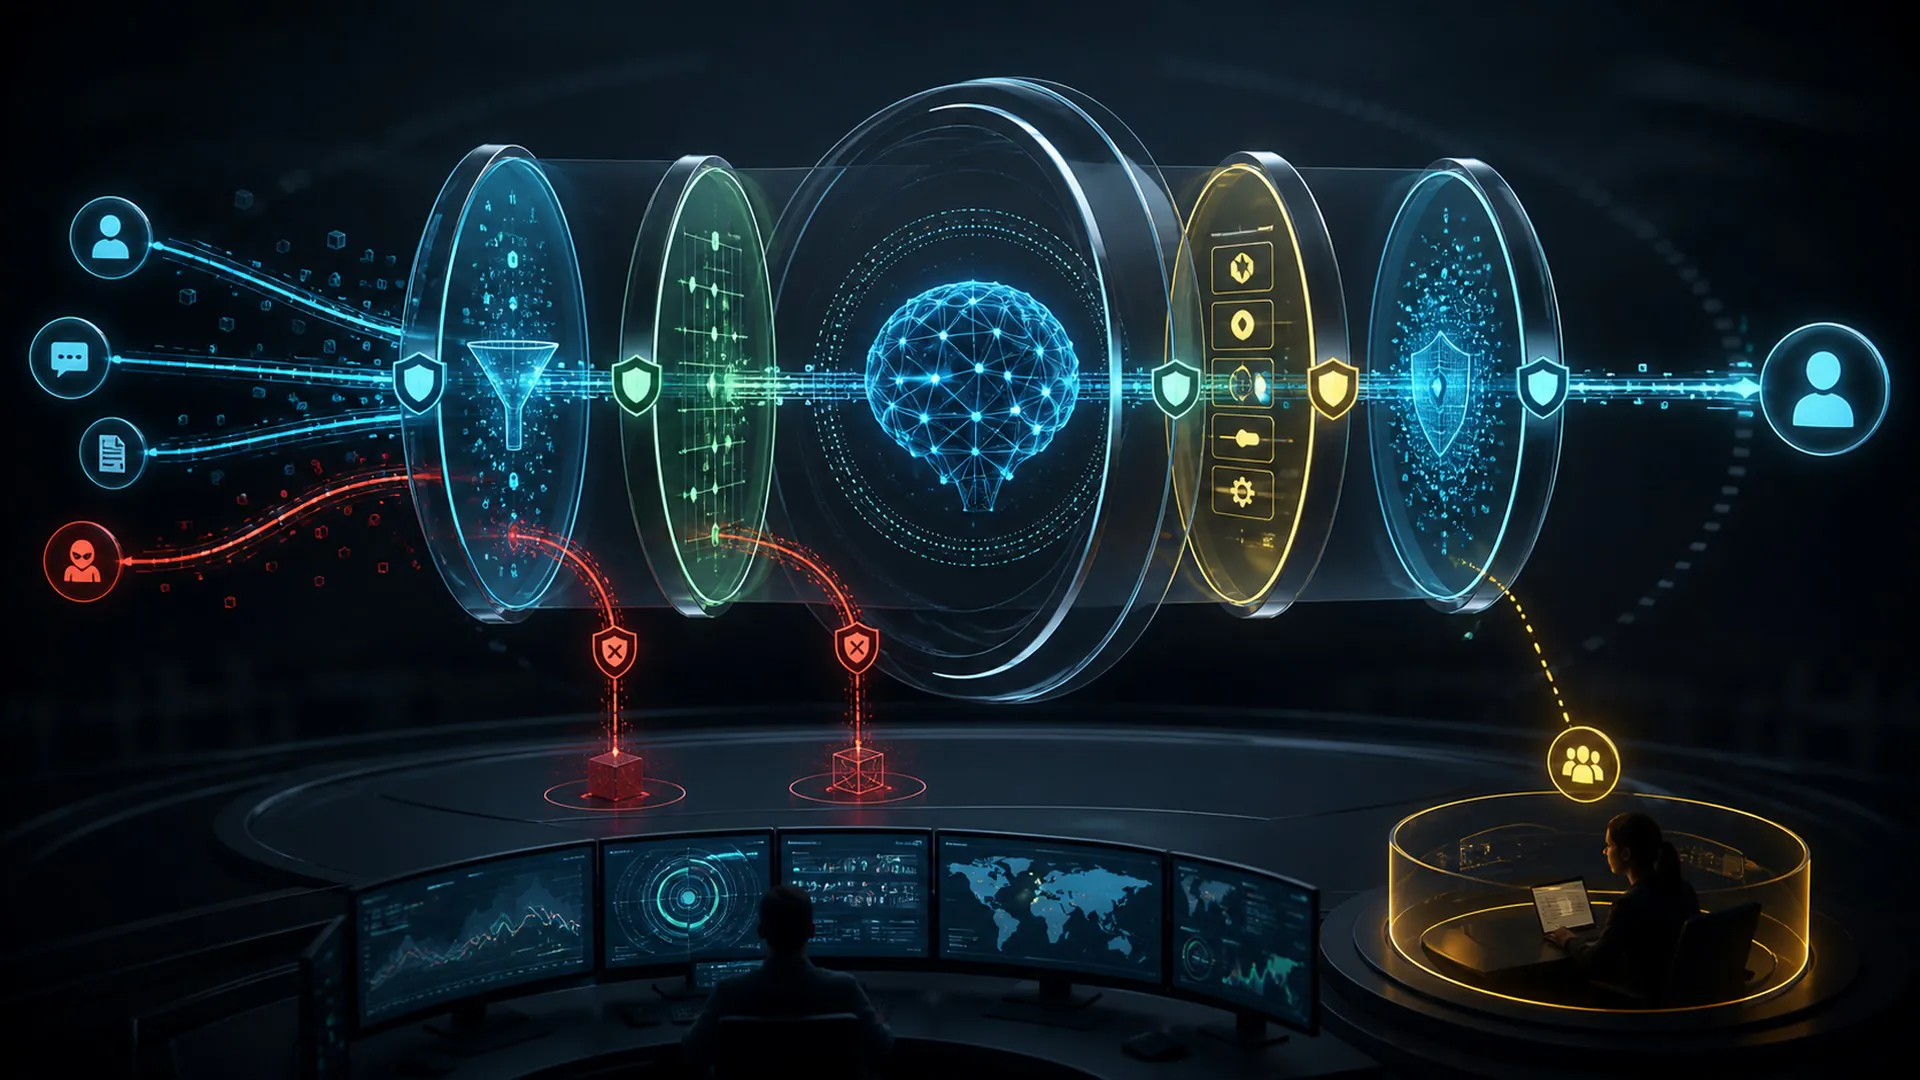
Zabezpieczenia AI to warstwowe kontrole techniczne i proceduralne, które ograniczają wejścia, działania, wyjścia oraz eskalację wokół modelu lub agenta.
Zabezpieczenia AI wymagają precyzyjnego wyjaśnienia, ponieważ ich nazwa określa konkretny przepływ informacji, wybór treningu, mechanizm w czasie wykonywania lub granicę zarządzania. Traktowanie ich jako synonimu „zaawansowanej AI” czyni twierdzenia nie dającymi się przetestować. Ten przewodnik podąża za koncepcją od wejścia i założeń, poprzez obserwowalny wynik, a następnie testuje skrót najczęściej mylony z tym pojęciem.
Zabezpieczenia AI: definicja, granica i cel
Zabezpieczenia AI to warstwowe kontrole techniczne i proceduralne, które ograniczają wejścia, działania, wyjścia oraz eskalację wokół modelu lub agenta. Definicja zawiera trzy praktyczne zobowiązania: istnieje identyfikowalne wejście, transformacja lub decyzja charakterystyczna dla zabezpieczeń AI oraz wynik, który można ocenić względem określonego celu. Jeśli którykolwiek z tych elementów jest nieobecny, etykieta może opisywać aspirację, a nie wdrożony mechanizm.
Wiarygodna AI wymaga dowodów na każdym etapie cyklu życia. Kontrola ma sens tylko wtedy, gdy jej właściciel, zakres, wyzwalacz, oczekiwane zachowanie i metoda weryfikacji są jasno określone. W przypadku zabezpieczeń AI taki systemowy pogląd ma znaczenie, ponieważ wydajność może zależeć od otaczających danych, interfejsów, sprzętu, uprawnień i osób, nawet gdy podstawowy model pozostaje niezmieniony. Przydatne wyjaśnienie oddziela więc wyuczone zachowanie modelu od produktu, który decyduje, kiedy, gdzie i z jakim uprawnieniem to zachowanie jest wykorzystywane.
Najbardziej mylącym skrótem jest pojedyncze zapytanie systemowe mające wymusić każdą granicę. Może ono dzielić widoczną cechę ze zabezpieczeniami AI, jednak zmienia narrację przyczynową: inne dowody potwierdziłyby sukces, inne zasoby zdominowałyby koszty, a inne kontrole zapobiegałyby szkodom. Granica jest więc operacyjna, a nie terminologiczna.
Pięciostopniowa mapa działania zabezpieczeń AI
Diagram to zwarta mapa przyczynowo-skutkowa dla zabezpieczeń AI, a nie twierdzenie, że każda implementacja używa pięciu komponentów oprogramowania. Niektóre systemy łączą etapy, inne powtarzają je w pętli. Mapa pozostaje użyteczna, ponieważ wymusza, aby każda zmiana informacji lub uprawnień miała właściciela, wejście, wyjście i test.
1. Klasyfikacja żądania i obowiązującej polityki: wejście i założenia w zabezpieczeniach AI
Na tym etapie zabezpieczeń AI system musi sklasyfikować żądanie i obowiązującą politykę. Kluczowe pytanie nie dotyczy jedynie tego, czy operacja się odbywa, ale jakie informacje są przez nią wykorzystywane, który stan jest zmieniany i jakie dowody potwierdzają, że zmiana była prawidłowa. Recenzent powinien być w stanie odróżnić tę operację od pojedynczego zapytania systemowego mającego wymusić każdą granicę i odtworzyć jej wynik w tych samych warunkach.
Przekazanie do tego etapu zabezpieczeń AI rozpoczyna się od określonego celu i powinno zakończyć się wynikiem, który może wspierać ograniczanie kontekstu, narzędzi i dostępu do danych. Należy rejestrować niepewność, odrzucone alternatywy, zużycie zasobów oraz wszelkie ludzkie lub programowe kontrole zastosowane na granicy. Ten ślad pozwala zespołom wykryć, czy zabezpieczenia mogą blokować legalną pracę, być omijane lub tworzyć fałszywe poczucie bezpieczeństwa, zanim ta sama słabość doprowadzi do istotnego wyniku.
2. Ograniczanie kontekstu, narzędzi i dostępu do danych: reprezentacja lub decyzja w zabezpieczeniach AI
Na tym etapie zabezpieczeń AI system musi ograniczyć dostęp do kontekstu, narzędzi i danych. Kluczowe pytanie nie dotyczy jedynie tego, czy operacja się odbywa, ale jakie informacje są przez nią wykorzystywane, który stan jest zmieniany i jakie dowody potwierdzają, że zmiana była prawidłowa. Recenzent powinien być w stanie odróżnić tę operację od pojedynczego zapytania systemowego mającego wymusić każdą granicę i odtworzyć jej wynik w tych samych warunkach.
Przekazanie do tego etapu zabezpieczeń AI rozpoczyna się od klasyfikacji żądania i obowiązującej polityki i powinno zakończyć się wynikiem, który może wspierać weryfikację proponowanych działań przed ich wykonaniem. Należy rejestrować niepewność, odrzucone alternatywy, zużycie zasobów oraz wszelkie ludzkie lub programowe kontrole zastosowane na granicy. Ten ślad pozwala zespołom wykryć, czy zabezpieczenia mogą blokować legalną pracę, być omijane lub tworzyć fałszywe poczucie bezpieczeństwa, zanim ta sama słabość doprowadzi do istotnego wyniku.
3. Walidacja proponowanych działań przed wykonaniem: charakterystyczna transformacja w AI Guardrails
Na tym etapie AI guardrails system musi zweryfikować proponowane działania przed ich wykonaniem. Kluczowe pytanie nie dotyczy jedynie tego, czy operacja się odbywa, lecz jakie informacje są przez nią konsumowane, jaki stan jest zmieniany oraz jakie dowody potwierdzają, że zmiana była prawidłowa. Recenzent powinien być w stanie odróżnić tę operację od pojedynczego promptu systemowego, którego oczekuje się, że będzie egzekwował każdą granicę i odtworzy jego wynik w tych samych warunkach.
Przejście do tego etapu AI guardrails rozpoczyna się od ograniczenia kontekstu, narzędzi i dostępu do danych i powinno zakończyć się wynikiem, który umożliwia inspekcję wyników i zmienionego stanu. Należy rejestrować niepewność, odrzucone alternatywy, zużycie zasobów oraz wszelką kontrolę ludzką lub programową zastosowaną na granicy. Ten ślad jest miejscem, w którym zespoły mogą wykrywać, czy guardrails mogą blokować legalną pracę, być omijane lub tworzyć fałszywe poczucie bezpieczeństwa, zanim ta sama słabość doprowadzi do istotnego wyniku.
4. Inspekcja wyników i zmienionego stanu: granica ograniczenia i weryfikacji w AI Guardrails
Na tym etapie AI guardrails system musi inspekcjonować wyniki i zmieniony stan. Kluczowe pytanie nie dotyczy jedynie tego, czy operacja się odbywa, lecz jakie informacje są przez nią konsumowane, jaki stan jest zmieniany oraz jakie dowody potwierdzają, że zmiana była prawidłowa. Recenzent powinien być w stanie odróżnić tę operację od pojedynczego promptu systemowego, którego oczekuje się, że będzie egzekwował każdą granicę i odtworzy jego wynik w tych samych warunkach.
Przejście do tego etapu AI guardrails rozpoczyna się od walidacji proponowanych działań przed wykonaniem i powinno zakończyć się wynikiem, który umożliwia eskalację, rejestrację i doskonalenie na podstawie incydentów. Należy rejestrować niepewność, odrzucone alternatywy, zużycie zasobów oraz wszelką kontrolę ludzką lub programową zastosowaną na granicy. Ten ślad jest miejscem, w którym zespoły mogą wykrywać, czy guardrails mogą blokować legalną pracę, być omijane lub tworzyć fałszywe poczucie bezpieczeństwa, zanim ta sama słabość doprowadzi do istotnego wyniku.
5. Eskalacja, rejestracja i doskonalenie na podstawie incydentów: wynik, informacje zwrotne i reguła zatrzymania w AI Guardrails
Na tym etapie AI guardrails system musi eskalować, rejestrować i doskonalić na podstawie incydentów. Kluczowe pytanie nie dotyczy jedynie tego, czy operacja się odbywa, lecz jakie informacje są przez nią konsumowane, jaki stan jest zmieniany oraz jakie dowody potwierdzają, że zmiana była prawidłowa. Recenzent powinien być w stanie odróżnić tę operację od pojedynczego promptu systemowego, którego oczekuje się, że będzie egzekwował każdą granicę i odtworzy jego wynik w tych samych warunkach.
Przejście do tego etapu AI guardrails rozpoczyna się od inspekcji wyników i zmienionego stanu i powinno zakończyć się wynikiem, który umożliwia monitorowanie lub podjęcie ostatecznej decyzji. Należy rejestrować niepewność, odrzucone alternatywy, zużycie zasobów oraz wszelką kontrolę ludzką lub programową zastosowaną na granicy. Ten ślad jest miejscem, w którym zespoły mogą wykrywać, czy guardrails mogą blokować legalną pracę, być omijane lub tworzyć fałszywe poczucie bezpieczeństwa, zanim ta sama słabość doprowadzi do istotnego wyniku.
Przejrzyj mapę AI guardrails w przód, aby zrozumieć produkcję, oraz w tył, aby diagnozować awarie. Analiza w przód pyta, w jaki sposób jeden etap dostarcza kolejny. Analiza wstecz zaczyna się od nieprawidłowego, wolnego, kosztownego lub niebezpiecznego wyniku i śledzi, które wcześniejsze założenie je umożliwiło. Odwrócona ścieżka jest często miejscem, w którym zespół odkrywa, że decydujący błąd wystąpił przed tym, jak model wygenerował cokolwiek.
Przykład zastosowania AI Guardrails
Asystent finansowy może przygotować instrukcję przelewu, ale deterministyczna reguła i upoważniony recenzent muszą zatwierdzić wykonanie.
Ten przykład jest pouczający, ponieważ AI guardrails mogą być powiązane z obserwowalnymi danymi wejściowymi, stanami pośrednimi i wynikiem, a nie oceniane na podstawie dopracowanej demonstracji. Rygorystyczny test stworzyłby typowe, trudne i celowo wprowadzające w błąd przypadki wokół scenariusza, zachowałby bazę odniesienia bez tej techniki oraz zarejestrował zarówno średnią wydajność, jak i nasilenie poszczególnych awarii.
Zmień jedno założenie w przykładzie AI guardrails i powtórz analizę. Usuń wymaganą wartość wejściową, wprowadź sprzeczny sygnał, ogranicz moc obliczeniową, zmień populację użytkowników lub zmusz system do wstrzymania się. Mechanizm, który odnosi sukces jedynie w jednej starannie przygotowanej demonstracji, nie wykazał, że generalizuje się do środowiska operacyjnego.
AI Guardrails vs. najczęstszy skrót
AI guardrails jest często sprowadzane do jednego promptu systemowego, którego oczekuje się, że będzie egzekwował każdą granicę. Takie uproszczenie usuwa samą granicę definiującą koncepcję. Może to prowadzić nabywców do porównywania nieporównywalnych produktów, badaczy do przerysowywania tego, co eksperyment wykazuje, oraz operatorów do monitorowania niewłaściwego sygnału po wdrożeniu.
| Perspektywa | Praktyczna odpowiedź |
|---|---|
| Definicja | Zabezpieczenia AI to warstwowe kontrole techniczne i proceduralne, które ograniczają dane wejściowe, działania, wyniki oraz eskalację wokół modelu lub agenta. |
| Zamieszanie | oczekiwany pojedynczy prompt systemowy, aby wymusić każdą granicę. |
| Ryzyko | zabezpieczenia mogą blokować prawidłową pracę, być omijane lub tworzyć fałszywe poczucie bezpieczeństwa. |
Porównanie powinno również określić jednostkę analizy. Artykuł o zabezpieczeniach AI może izolować model lub algorytm, podczas gdy wdrożona usługa dodaje wyszukiwanie, routing, buforowanie, polityki, tożsamość, interfejsy użytkownika i monitorowanie. Dwa produkty mogą używać tego samego hasła, realizując różne części tego stosu. Zapytaj, który komponent wykonuje definiującą transformację i które inne komponenty są niezbędne dla zgłaszanego wyniku.
Dlaczego zabezpieczenia AI są istotne w obecnych systemach AI
Zabezpieczenia AI mają teraz znaczenie, ponieważ systemom AI przydzielane są większe konteksty, więcej modalności, większa moc obliczeniowa w czasie działania, szerszy dostęp do narzędzi oraz głębsze powiązania z decyzjami organizacyjnymi. W takich warunkach to, co kiedyś wyglądało jak szczegół badawczy, może decydować o opóźnieniach, bezpieczeństwie, dostępności, kosztach środowiskowych, jakości produktu lub odpowiedzialności prawnej.
Istotna miara nie polega na tym, czy zabezpieczenia AI mogą wygenerować jedną imponującą rezultat. Chodzi o to, czy technika poprawia wynik, który ma znaczenie w reprezentatywnych warunkach i robi to skuteczniej niż prostsza baza odniesienia. Należy raportować rozkłady, kategorie awarii, opóźnienia w ogonie, zużycie zasobów i dotknięte podgrupy, zamiast kompresować wszystkie wyniki do jednej średniej.
Monitoruj zarówno metryki techniczne, jak i wpływ na ludzi. Dokumentuj niepewność, zachowuj pochodzenie, umożliwiaj eskalację i projektuj odzyskiwanie przed wystawieniem systemu na zmieniające się warunki rzeczywiste. Zastosowane konkretnie do zabezpieczeń AI, to podejście czyni dowody przenośnymi: inny zespół może ocenić, czy deklarowany zysk przetrwa inny model, język, platformę sprzętową, zestaw danych, populację użytkowników lub tolerancję ryzyka.
Korzyści, które mogą przynieść zabezpieczenia AI
Najsilniejszym powodem użycia zabezpieczeń AI jest to, że mogą one bezpośrednio rozwiązać zamierzony wąskie gardło. W zależności od implementacji, korzyść może przejawiać się lepszym osadzeniem, bardziej wierną reprezentacją, ulepszoną generalizacją, niższym opóźnieniem, zmniejszonym ruchem pamięci, jaśniejszą odpowiedzialnością lub bezpieczniejszą granicą między propozycją modelu a rzeczywistym działaniem.
Korzyści powinny być wyrażane jako decyzje i pomiary. „Bardziej inteligentny” nie jest kryterium akceptacji dla zabezpieczeń AI. Przydatny cel może określać wskaźnik błędów w trudnych przypadkach, odzyskiwanie po sprzecznych dowodach, koszt na określonym percentylu ruchu, czas przeglądu przez człowieka, kalibrację lub procent działań utrzymywanych w ramach określonego limitu uprawnień.
Tryb awarii definiujący zabezpieczenia AI
Głównym ograniczeniem jest to, że zabezpieczenia mogą blokować prawidłową pracę, być omijane lub tworzyć fałszywe poczucie bezpieczeństwa. Ta awaria nie jest dopiero po fakcie, którą należy wymienić po zakończeniu rozwoju. Powinna kształtować zbieranie danych, architekturę, uprawnienia, ocenę, bramki wydania i monitorowanie zabezpieczeń AI od samego początku.
Środek kontrolny dla zabezpieczeń AI jest przydatny tylko wtedy, gdy działa przed kosztowną lub nieodwracalną konsekwencją. Zidentyfikuj najwcześniejszy obserwowalny prekursor awarii, ustal próg lub regułę, przydziel odpowiedzialnego właściciela i przetestuj odzyskiwanie. W zależności od przypadku użycia, odzyskiwanie może oznaczać wstrzymanie się, powrót do prostszego systemu, żądanie dodatkowych dowodów, eskalację do osoby, przywrócenie poprzedniej wersji modelu lub całkowite zatrzymanie działania.
Plan oceny zabezpieczeń AI
Rozpocznij ocenę zabezpieczeń AI, zapisując decyzję, którą dowody muszą poprzeć. Zdefiniuj populację operacyjną, konsekwencję błędnego wyniku, informacje faktycznie dostępne w momencie decyzji oraz najprostszy wiarygodny alternatywny scenariusz. To zapobiega przekształceniu benchmarku w cel jedynie dlatego, że jest łatwy do przeprowadzenia.
Użyj niezmienionego zestawu testowego do kontrolowanych porównań, a następnie zweryfikuj zabezpieczenia AI w etapowym środowisku operacyjnym. Ocena offline sprawia, że warianty są porównywalne; tryb cieniowy, kanary, limity prędkości lub bramki zatwierdzające ujawniają, jak rzeczywisty ruch, pętle sprzężenia zwrotnego i ludzie zmieniają zachowanie. Etap wdrożenia powinien mieć wyraźny warunek zatrzymania, zamiast zakładać, że każda poprawa zasługuje na pełne wdrożenie.
Zwersjonuj dane wejściowe niezbędne do odtworzenia zabezpieczeń AI: źródłowe dane, przetwarzanie wstępne, tokenizator lub enkoder, wagi modelu, konfigurację, prompt lub politykę, indeks wyszukiwania, zestaw oceny, założenia sprzętowe oraz kod serwujący, o ile ma to zastosowanie. Bez śladu pochodzenia zespół nie może stwierdzić, czy zmieniony wynik wynika z techniki, środowiska czy niezauważonej edycji potoku.
Na koniec zapytaj, które odkrycie obaliłoby twierdzenie, że zabezpieczenia AI pomagają. Jeśli żaden wynik nie mógłby odwrócić decyzji o przyjęciu, ocena jest marketingowa. Wstępnie ustalone progi akceptacji i zachowany zestaw potwierdzający zamieniają ćwiczenie w dowód.
Pytania do zadania przed przyjęciem zabezpieczeń AI
- Cel: Jaki mierzalny wąskie gardło ma rozwiązać zabezpieczenie AI?
- Mechanizm: Który z pięciu etapów zawiera charakterystyczną transformację?
- Podstawa: Jak wypada w porównaniu z pojedynczym promptem systemowym, który ma wymusić każde ograniczenie, lub inną prostszą alternatywą?
- Dowody: Jakie przypadki zwykłe, trudne, adwersarialne i podgrupowe zostały przetestowane?
- Operacje: Jakie koszty opóźnień, pamięci, obliczeń, energii, utrzymania i przeglądu pojawiają się w skali?
- Ryzyko: Jak zespół wykryje, że zabezpieczenia mogą blokować uzasadnioną pracę, zostać obejść lub stworzyć fałszywe poczucie bezpieczeństwa?
- Odzyskiwanie: Czy system może wstrzymać się, przejść w tryb awaryjny, cofnąć zmiany lub eskalować przed szkodą?
Podstawowe źródła do badania zabezpieczeń AI
Autorytatywne punkty wyjścia dla części stosu AI otaczającej zabezpieczenia AI obejmują NIST AI Risk Management Framework, C2PA specifications, NIST Privacy Framework. Przeczytaj je wraz z dokumentacją dotyczącą konkretnego modelu, zestawu danych, sprzętu i jurysdykcji. Ogólne źródło może definiować mechanizm, ale tylko dowody specyficzne dla wdrożenia mogą potwierdzić, że dana implementacja jest odpowiednia.
Co warto zapamiętać o zabezpieczeniach AI
Zabezpieczenia AI to określony mechanizm w ramach większego systemu społeczno‑technicznego. Ich wartość wynika z poprawy konkretnego wyniku pod wyraźnymi warunkami, a nie z samej etykiety. Mapowanie pięciu etapów uwidacznia przepływ informacji, porównanie określa, czym nie jest, a ścieżka kontroli pokazuje, gdzie odpowiedzialny operator może interweniować.
Praktyczna zasada dotycząca zabezpieczeń AI polega na zdefiniowaniu celu, porównaniu z wiarygodną bazą, przetestowaniu najważniejszej awarii oraz zachowaniu dowodów niezbędnych do monitorowania zmian. Gdy te elementy są na miejscu, koncepcja staje się wyborem inżynieryjnym i zarządczym, który można ocenić. Bez nich pozostaje obiecującą nazwą przypisaną do nieznanego ryzyka operacyjnego.


