
Kąt Andersona
UniTune: alternatywna technika neuronowej edycji obrazów firmy Google

 Dodaj Unite.AI do preferowanych źródeł w Google
Kluczowe punktyUniTune dostraja model dyfuzji na pojedynczym obrazie, aby umożliwić precyzyjne edycje…
Zobacz więcej
- UniTune dostraja model dyfuzji na pojedynczym obrazie, aby umożliwić precyzyjne edycje sterowane tekstem.
- W przeciwieństwie do DreamBooth lub Textual Inversion, UniTune odrzuca oba podejścia na rzecz lepszego zachowania szczegółów.
- Metoda osiąga wysoką dezagregację semantyczną, utrzymując twarze nienaruszone podczas radykalnych transformacji tła.
Firma Google Research, wydaje się, atakuje edycję obrazów opartą na tekście z wielu stron i, przypuszczalnie, czeka, aby zobaczyć, co “przyjmie”. Zaraz po tym, jak w tym tygodniu opublikowano jej artykuł o Imagic, gigant wyszukiwarkowy zaproponował dodatkową metodę opartą na latentnej dyfuzji, umożliwiającą wykonywanie edycji AI niemożliwych przy użyciu innych metod na obrazach za pomocą poleceń tekstowych, tym razem nazwaną UniTune.
Na podstawie przykładów podanych w nowym artykule, UniTune osiągnął nadzwyczajny stopień rozłączania semantycznego położenia i pomysłu od rzeczywistej zawartości obrazu:

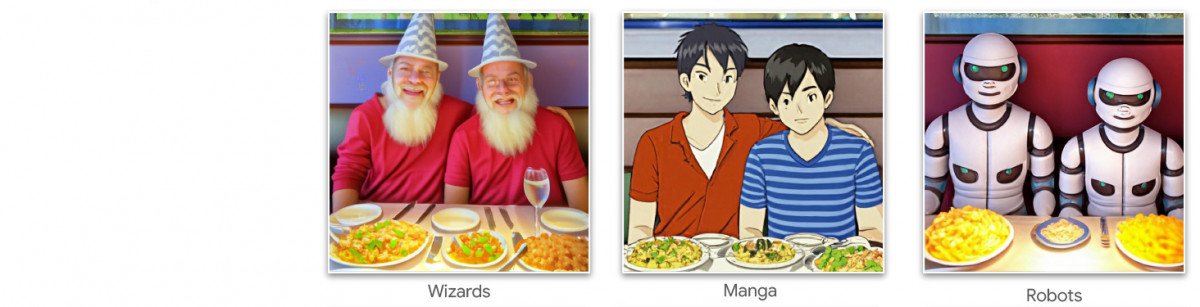

UniTune ma niezwykłą kontrolę nad kompozycją semantyczną. Zwróć uwagę, jak w najwyższym rzędzie obrazów twarze dwóch osób nie zostały zniekształcone przez nadzwyczajną transformację reszty obrazu źródłowego (po prawej). Źródło: https://arxiv.org/pdf/2210.09477.pdf
Fani Stable Diffusion dowiedzieli się już, że aplikowanie edycji do części obrazu bez negatywnego wpływu na resztę obrazu może być trudnym, czasem niemożliwym zadaniem. Chociaż popularne dystrybucje, takie jak AUTOMATIC1111, mogą tworzyć maski dla lokalnych i ograniczonych edycji, proces ten jest uciążliwy i często nieprzewidywalny.
Oczywistą odpowiedzią, przynajmniej dla specjalisty ds. widzenia komputerowego, jest umieszczenie warstwy segmentacji semantycznej, która może rozpoznać i izolować obiekty na obrazie bez interwencji użytkownika, i rzeczywiście, ostatnio pojawiło się kilka nowych inicjatyw w tym kierunku.
Inną możliwością dla zablokowania nieładnych i splątanych operacji edycji obrazu neuronowego jest wykorzystanie modułu OpenAI Contrastive Language–Image Pre-training (CLIP), który jest sercem modeli latentnej dyfuzji, takich jak DALL-E 2 i Stable Diffusion, aby działał jako filtr w momencie, gdy model tekstowo-obrazowy jest gotowy wysłać renderowaną odpowiedź z powrotem do użytkownika. W tym kontekście CLIP powinien działać jako strażnik i moduł kontroli jakości, odrzucając niepoprawne lub niewłaściwe renderowania. To będzie wkrótce wprowadzone (link do Discorda) w portalu API-driven DreamStudio.
Jednakże, ponieważ CLIP jest zarówno sprawcą, jak i rozwiązaniem w takim scenariuszu (ponieważ w zasadzie poinformował również o tym, jak obraz został wygenerowany), a ponieważ wymagania sprzętowe mogą przekraczać to, co jest prawdopodobnie dostępne lokalnie dla użytkownika końcowego, to podejście może nie być idealne.
Język skompresowany
Proponowany UniTune “dokształca” istniejący model dyfuzji – w tym przypadku własny model Google Imagen, chociaż badacze stwierdzają, że metoda jest kompatybilna z innymi architekturami latentnej dyfuzji – tak, aby unikalny token został wstrzyknięty do niego, który może być wywołany przez włączenie go do tekstu polecenia.
Na pierwszy rzut oka, to brzmi jak DreamBooth firmy Google, który obecnie jest obsesją wśród fanów i deweloperów Stable Diffusion, który może wstrzyknąć nowe postacie lub obiekty do istniejącego punktu kontrolnego, często w czasie krótszym niż godzina, na podstawie zaledwie kilku obrazów źródłowych; lub jak Textual Inversion, który tworzy “obok” pliki dla punktu kontrolnego, które są następnie traktowane tak, jakby były pierwotnie wytrenowane w modelu, i mogą korzystać z ogromnych zasobów modelu, modyfikując jego klasyfikator tekstu, w wyniku czego powstaje mały plik (w porównaniu z minimum 2 GB wyciętego punktu kontrolnego DreamBooth).
Faktycznie, badacze twierdzą, że UniTune odrzucił oba te podejścia. Stwierdzili, że Textual Inversion pomijał zbyt wiele ważnych szczegółów, podczas gdy DreamBooth “wykonywał gorzej i zajmował więcej czasu” niż rozwiązanie, które ostatecznie przyjęli.
Niemniej jednak, UniTune wykorzystuje taki sam zamknięty semantyczny “metaprompt” podejście jak DreamBooth, z wytrenowanymi zmianami wywoływanymi przez unikalne słowa wybrane przez trenera, które nie będą kolidować z żadnymi terminami, które obecnie istnieją w starannie wytrenowanym publicznym modelu.
QUOTEOPEN‘Aby wykonać operację edycji, próbkujemy dostrojone modele z poleceniem “[rare_tokens] edit_prompt” (np. “beikkpic dwa psy w restauracji” lub “beikkpic minion”).’QUOTECLOSE
Proces
Chociaż jest to zagadkowe, dlaczego dwa prawie identyczne artykuły, pod względem ich końcowej funkcjonalności, powinny pojawić się od Google w tym samym tygodniu, istnieje, pomimo ogromnej liczby podobieństw między tymi dwoma inicjatywami, co najmniej jedna wyraźna różnica między UniTune a Imagic – ten ostatni używa “nieskompresowanych” naturalnych poleceń językowych do kierowania operacjami edycji obrazu, podczas gdy UniTune trenuje unikalne tokeny w stylu DreamBooth.
Jeśli więc edytowałbyś z Imagic i chciałbyś wprowadzić taką transformację…

Z artykułu UniTune – UniTune ustala się przeciwko ulubionemu rywalowi Google, ramie edycji neuronowej SDEdit. Wyniki UniTune znajdują się na prawej stronie, a oszacowana maska jest widoczna w drugim obrazie od lewej.
.. w Imagic, wprowadziłbyś ‘trzecią osobę, siedzącą z tyłu, jako słodkiego, futrzastego potwora’.
Ekwiwalentne polecenie UniTune byłoby ‘Człowiek z tyłu jako [x]’, gdzie x to jakieś dziwne i unikalne słowo, które zostało związane z wytrenowanym pojęciem związanym z postacią futrzastego potwora.
Podczas gdy do DreamBooth lub Textual Inversion wprowadza się kilka obrazów, aby stworzyć abstrakcję w stylu deepfake, którą można przedstawiać w wielu pozach, UniTune i Imagic wprowadzają do systemu tylko jeden obraz – oryginalny, nieskażony obraz.
To jest podobne do sposobu, w jaki wiele narzędzi edycji opartych na GAN z ostatnich lat działało – przez konwertowanie obrazu wejściowego na kod latentny w przestrzeni GAN i następnie adresowanie tych kodów i wysyłanie ich do innych części przestrzeni latentnej w celu modyfikacji (tj. wprowadzanie obrazu młodej, ciemnowłosej osoby i projekcja go przez kod latentny związany z “starym” lub “blondynką”, itp.).
Jednak wyniki, w modelu dyfuzji, i za pomocą tej metody, są dość zaskakująco dokładne w porównaniu, i znacznie mniej dwuznaczne:
Proces dokształcania
Metoda UniTune polega na przesłaniu oryginalnego obrazu przez model dyfuzji z zestawem instrukcji, jak go modyfikować, przy użyciu ogromnych repozytoriów dostępnych danych wytrenowanych w modelu. W istocie, można to zrobić teraz z funkcjonalnością img2img Stable Diffusion – ale nie bez zniekształcenia lub w jakiś sposób zmiany części obrazu, które chciałbyś zachować.
Podczas procesu UniTune, system jest dokształcany, co oznacza, że UniTune zmusza model do wznowienia treningu, z większością jego warstw odblokowanych (patrz poniżej). W większości przypadków, dokształcanie zmniejszy ogólne ogólne wartości straty wysoko wydajnego modelu na rzecz wstrzyknięcia lub ulepszenia innego aspektu, który jest pożądany do stworzenia lub wzmocnienia.
Jednak z UniTune wydaje się, że kopia modelu, która jest poddana działaniu, chociaż może ważyć kilka gigabajtów lub więcej, będzie traktowana jako jednorazowa „powłoka”, i zostanie odrzucona na końcu procesu, po spełnieniu jednego zadania. Tego rodzaju swobodne traktowanie tak ogromnej ilości danych staje się codziennym kryzysem magazynowym dla fanów DreamBooth, których własne modele, nawet gdy są przycinane, nie są mniejsze niż 2 GB na temat.
Podobnie jak w przypadku Imagic, główne dostosowanie w UniTune występuje w dwóch najniższych warstwach z trzech warstw w Imagen (bazowa 64px, 64px>256px i 256px>1024px). W przeciwieństwie do Imagic, badacze widzą pewną wartość w optymalizacji dostosowania również dla tej ostatniej i największej warstwy super-rozdzielczości (chociaż jeszcze nie próbowali).
Dla najniższej warstwy 64px, model jest ukierunkowany na obraz bazowy podczas treningu, z wieloma duplikatami par obrazu/tekstu wprowadzanych do systemu przez 128 iteracji przy rozmiarze partii 4, i z Adafactor jako funkcją straty, działającą przy szybkości uczenia 0,0001. Chociaż podczas tego dostrajania zamrożony jest tylko enkoder T5, jest również zablokowany podczas podstawowego treningu Imagen
Powtarzana powyższa operacja jest następnie powtarzana dla warstwy 64>256px, przy użyciu tej samej procedury augmentacji szumu, która została zastosowana w oryginalnym treningu Imagen.
Próbkowanie
Istnieje wiele możliwych metod próbkowania, którymi można wywołać zmiany dokonane z dokształconego modelu, w tym Classifier Free Guidance (CFG), który jest również podstawą Stable Diffusion. CFG definiuje zakres, w jakim model może “śledzić swoją wyobraźnię” i badać możliwości renderowania – lub, w przypadku niższych ustawień, zakres, w jakim powinien przestrzegać danych wejściowych i wprowadzać mniej daleko idące lub dramatyczne zmiany.

Podobnie jak Textual Inversion (trochę mniej z DreamBooth), UniTune może stosować odrębne style graficzne do oryginalnych obrazów, a także bardziej fotorealistyczne edycje.
Badacze również eksperymentowali z SDEdit i jego techniką „późnego startu”, gdzie system jest zachęcany do zachowania oryginalnych szczegółów, będąc tylko częściowo “szumem” od samego początku, ale raczej zachowując swoje podstawowe cechy. Chociaż badacze użyli tego tylko w najniższej warstwie (64px), uważają, że może to być przydatna technika próbkowania w przyszłości.
Badacze również wykorzystali prompt-to-prompt jako dodatkową technikę opartą na tekście, aby warunkować model:
QUOTEOPEN‘W ustawieniu “prompt to prompt” stwierdziliśmy, że technika, którą nazywamy Prompt Guidance, jest szczególnie przydatna do dostosowania wierności i ekspresywności. QUOTECLOSEQUOTEOPEN‘Prompt Guidance jest podobny do Classifier Free Guidance, z tym że podstawa jest innym promptem, a nie niewarunkowanym modelem. To kieruje model w stronę różnicy między dwoma promptami.’QUOTECLOSE

Prompt-to-prompt w UniTune, efektywnie izolując obszary do zmiany.
Jednak wskazówka prompt, autorzy stwierdzają, była potrzebna tylko okazjonalnie w przypadkach, gdy CFG nie dawał pożądanego wyniku.
Inne nowe podejście do próbkowania napotkane podczas rozwoju UniTune to interpolacja, gdzie obszary obrazu są wystarczająco wyraźne, że zarówno oryginalny, jak i zmieniony obraz są bardzo podobne w kompozycji, co pozwala na użycie bardziej „naiwnej” interpolacji.

Interpolacja może uczynić bardziej wymagające procesy UniTune zbędnymi w przypadkach, gdy obszary do transformacji są dyskretne i dobrze odgraniczone.
Badacze sugerują, że interpolacja może działać tak dobrze, że może być używana jako ustawienie domyślne, i zauważają również, że ma moc do wprowadzania nadzwyczajnych transformacji w przypadkach, gdy złożone nakładania się nie muszą być negocjowane przez bardziej intensywne metody.
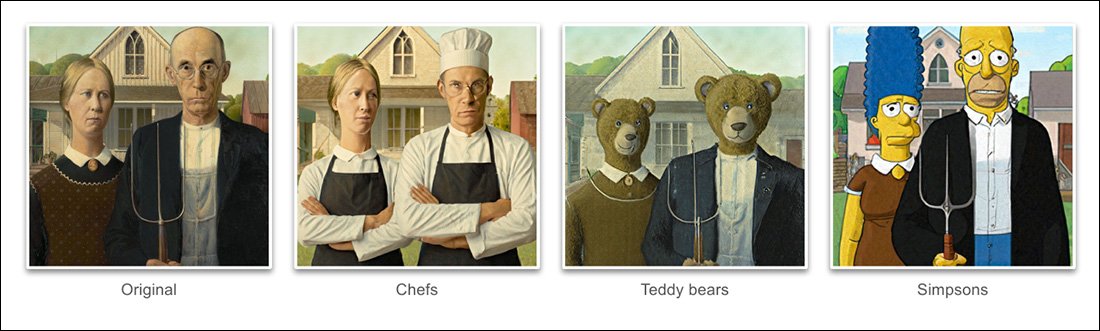
UniTune może wykonywać edycje lokalne z lub bez masek edycji, ale może również samodzielnie decydować, gdzie umieścić edycje, z niezwykłym połączeniem interpretacyjnej mocy i solidnego zachowania istoty danych wejściowych:

W najwyższym obrazie w drugiej kolumnie, UniTune, któremu powierzono wstawienie ‘czerwonego pociągu z tyłu’, umieścił go w odpowiedniej i autentycznej pozycji. Zwróć uwagę, jak w innych przykładach integralność semantyczna obrazu źródłowego jest zachowana, nawet wśród nadzwyczajnych zmian w zawartości pikseli i stylach obrazów.
Opóźnienie
Chociaż pierwsza iteracja każdego nowego systemu będzie wolna, i chociaż jest możliwe, że albo zaangażowanie społeczności, albo zaangażowanie korporacyjne (zwykle nie jest to oboje) w końcu przyspieszy i zoptymalizuje zasobochłonną procedurę, zarówno UniTune, jak i Imagic wykonują pewne dość poważne manewry uczenia maszynowego, aby utworzyć te niesamowite edycje, i jest wątpliwe, w jakim stopniu taki zasobochłonny proces mógłby być skalowany w dół do użycia domowego, zamiast API-driven (chociaż to ostatnie może być bardziej pożądane przez Google).
Obecnie, pełna podróż od wejścia do wyniku trwa około 3 minut na procesorze T4 GPU, z dodatkowymi 30 sekundami na inferencję (zgodnie z każdą rutyną inferencyjną). Autorzy przyznają, że to wysokie opóźnienie i niezbyt kwalifikuje się jako “interaktywne”, ale również zauważają, że model pozostaje dostępny do dalszych edycji, raz wstępnie dostosowany, aż użytkownik zakończy proces, co skraca czas na edycję.
Pierwotnie opublikowane 21 października 2022.


