
Kąt Andersona
Edycja obiektów wspomagana AI z Imagic od Google i „Erase and Replace” od Runway

 Dodaj Unite.AI do preferowanych źródeł w Google

W tym tygodniu dwa nowe, ale kontrastujące algorytmy graficzne oparte na AI oferują użytkownikom nowe możliwości wprowadzania bardzo szczegółowych i skutecznych zmian w obiektach na zdjęciach.
Pierwszy to Imagic, z Google Research, we współpracy z Izraelską Politechniką oraz Instytutem Nauk Weizmann. Imagic umożliwia edycję obiektów warunkowaną tekstem, o wysokiej precyzji, poprzez dostrajanie modeli dyfuzyjnych.

Zmień to, co chcesz, a resztę pozostaw – Imagic obiecuje precyzyjną edycję jedynie tych części, które chcesz zmienić. Źródło: https://arxiv.org/pdf/2210.09276.pdf
Każdy, kto kiedykolwiek próbował zmienić jedynie jeden element w ponownym renderowaniu Stable Diffusion, doskonale wie, że przy każdej udanej edycji system zmieni pięć rzeczy, które podobały Ci się w pierwotnej wersji. To wada, która obecnie zmusza wielu najzdolniejszych entuzjastów SD do ciągłego przechodzenia między Stable Diffusion a Photoshopem, aby naprawić tego rodzaju „szkody uboczne”. Już samo to sprawia, że osiągnięcia Imagic są godne uwagi.
W momencie pisania tego artykułu Imagic nie posiada jeszcze nawet materiału promocyjnego, a biorąc pod uwagę ostrożne podejście Google do udostępniania nieograniczonych narzędzi do syntezy obrazów, nie jest jasne, w jakim stopniu, jeśli w ogóle, będziemy mieli możliwość przetestowania tego systemu.
Drugą propozycją jest bardziej przystępna funkcja Erase and Replace od Runway ML, nowa funkcja w sekcji „AI Magic Tools” ich wyłącznie internetowego zestawu narzędzi do efektów wizualnych opartych na uczeniu maszynowym.
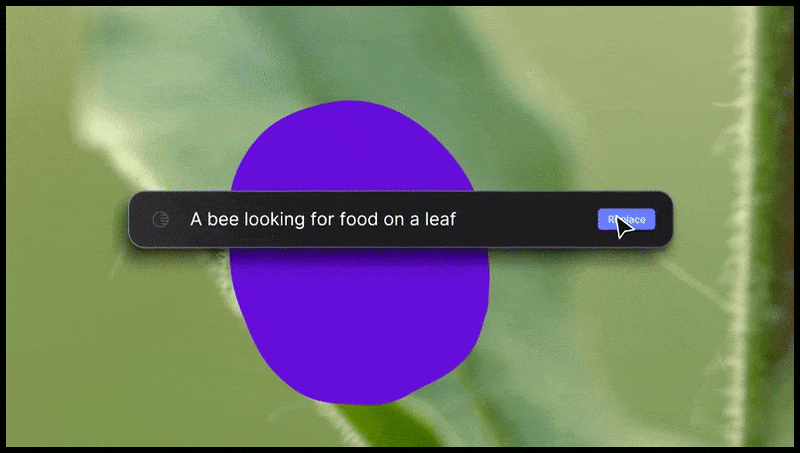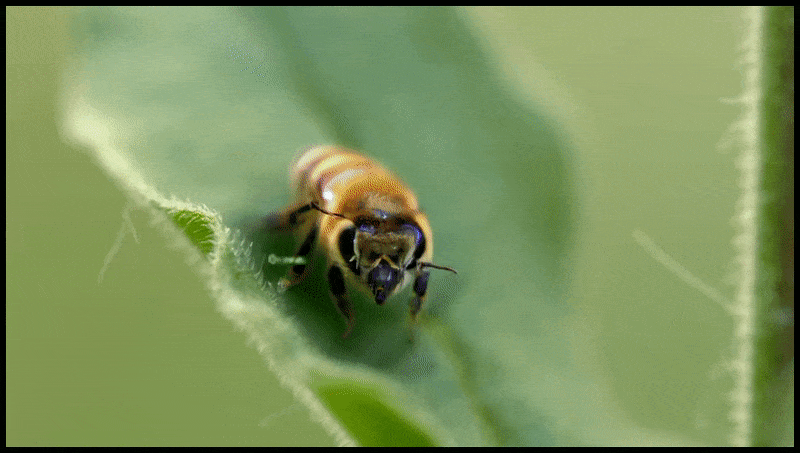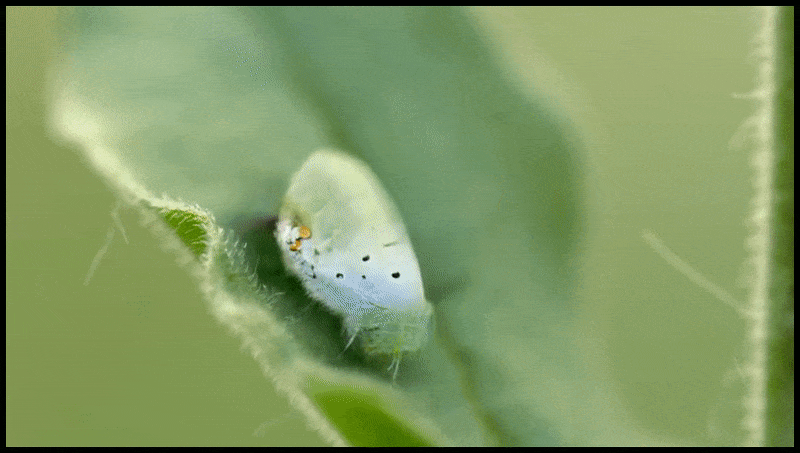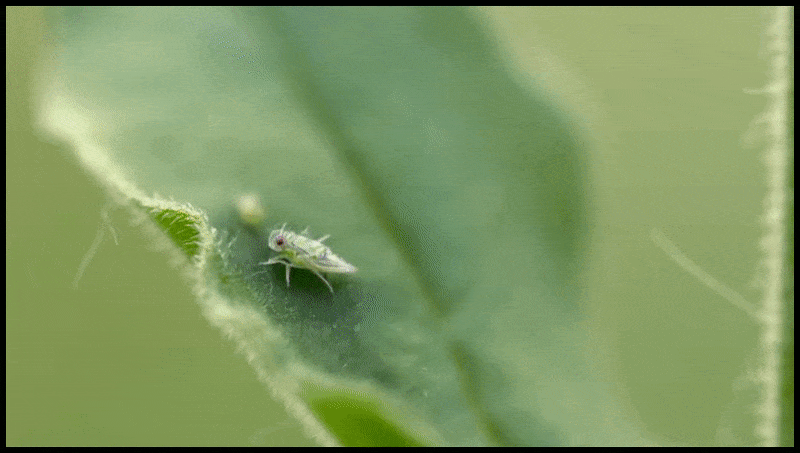
Funkcja Erase and Replace od Runway ML, już widziana w podglądzie systemu edycji tekst‑do‑wideo.
Przyjrzyjmy się najpierw ofercie Runway.
Erase and Replace
Podobnie jak Imagic, Erase and Replace działa wyłącznie na obrazach statycznych, choć Runway zaprezentował tę samą funkcję w rozwiązaniu do edycji tekst‑do‑wideo, które nie zostało jeszcze wydane:
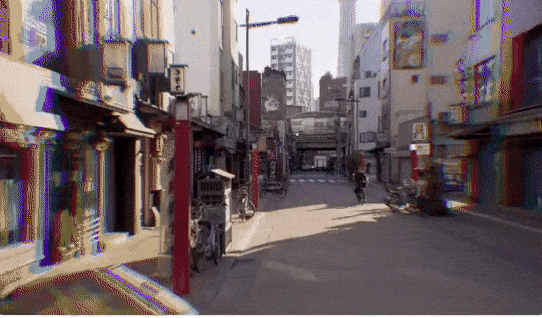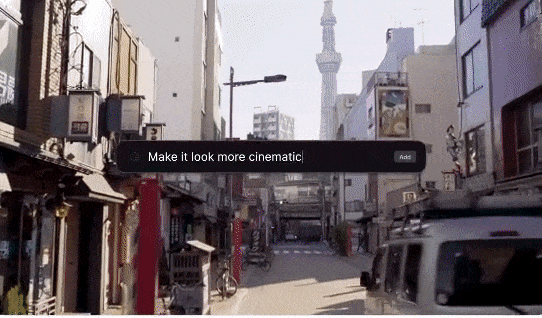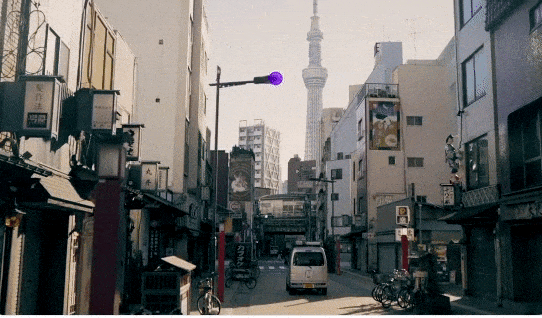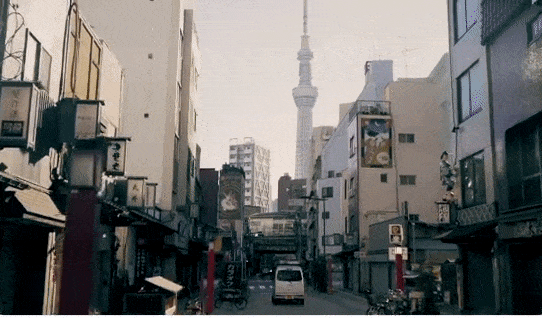
Choć każdy może wypróbować nowe Erase and Replace na obrazach, wersja wideo nie jest jeszcze publicznie dostępna. Źródło: https://twitter.com/runwayml/status/1568220303808991232
Mimo że Runway ML nie ujawniło szczegółów technologii stojącej za Erase and Replace, szybkość, z jaką można zamienić domową roślinę na dość przekonujące popiersie Ronalda Reagana, sugeruje, że silnikiem odtwarzającym wybrany przez Ciebie obiekt w Erase and Replace jest model dyfuzyjny, taki jak Stable Diffusion (lub, znacznie mniej prawdopodobne, licencjonowany DALL‑E 2).

Zamiana domowej rośliny na popiersie The Gipper nie jest aż tak szybka jak to, ale i tak jest całkiem szybka. Źródło: https://app.runwayml.com/
System posiada pewne ograniczenia podobne do DALL‑E 2 – obrazy lub tekst, które wywołują filtry Erase and Replace, spowodują ostrzeżenie o możliwej zawieszeniu konta w przypadku kolejnych naruszeń – w praktyce jest to szablonowa kopia obowiązujących polityk OpenAI dla DALL‑E 2.
Wiele wyników nie posiada typowych szorstkich krawędzi Stable Diffusion. Runway ML jest inwestorem i partnerem badawczym w SD i możliwe, że wytrenowali własny, zamknięty model, który przewyższa otwarto‑źródłowe wagi checkpointu 1.4, z którymi obecnie zmagamy się my wszyscy (ponieważ wiele innych grup deweloperskich, zarówno amatorów, jak i profesjonalistów, aktualnie trenuje lub dostraja modele Stable Diffusion).
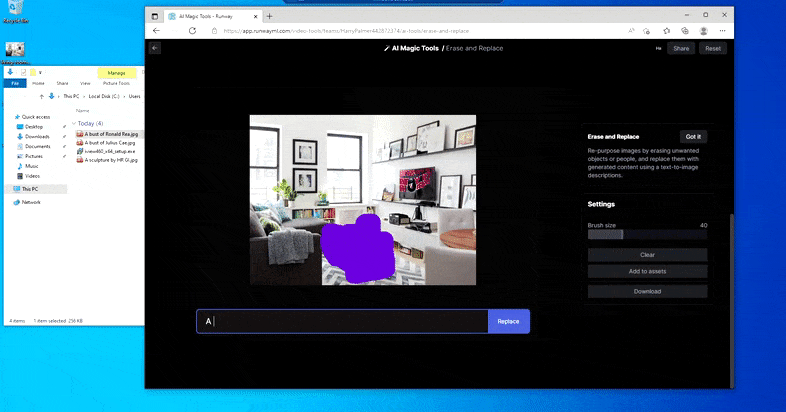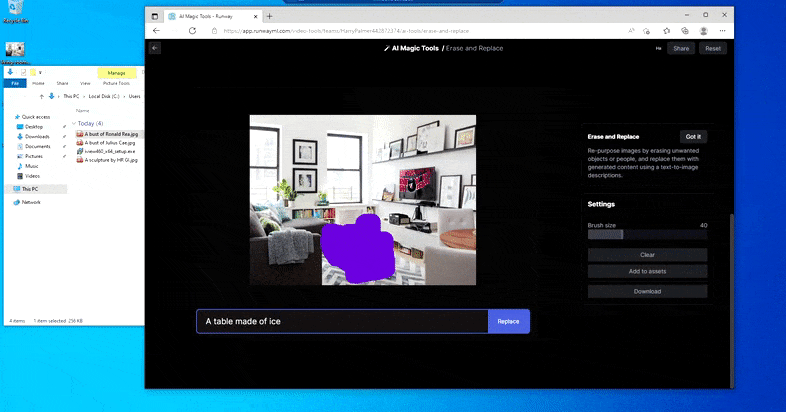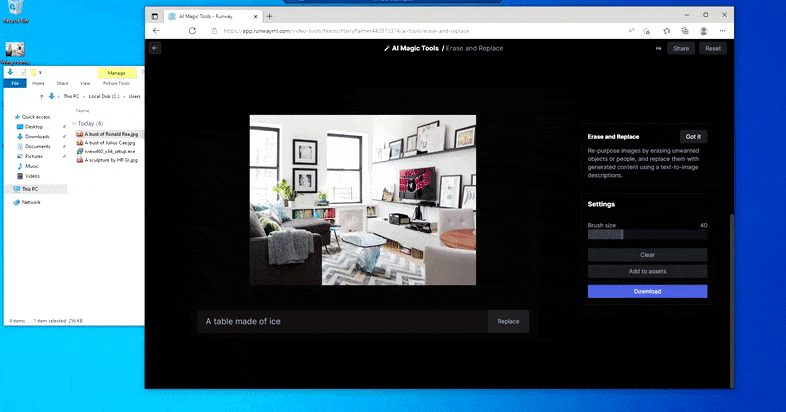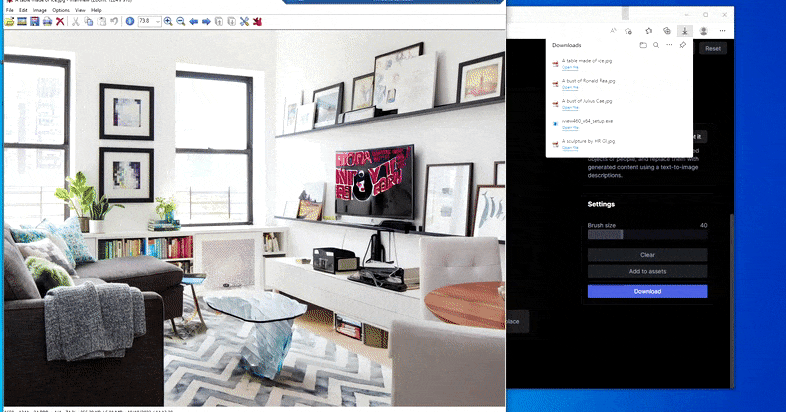
Zamiana domowego stołu na „stół z lodu” w Erase and Replace od Runway ML.
Podobnie jak Imagic (zobacz poniżej), Erase and Replace jest w pewnym sensie „zorientowane na obiekt” – nie można po prostu wymazać „pustej” części obrazu i wypełnić ją wynikiem podpowiedzi tekstowej; w takiej sytuacji system po prostu śledzi najbliższy widoczny obiekt wzdłuż linii widzenia maski (np. ścianę lub telewizor) i stosuje tam transformację.
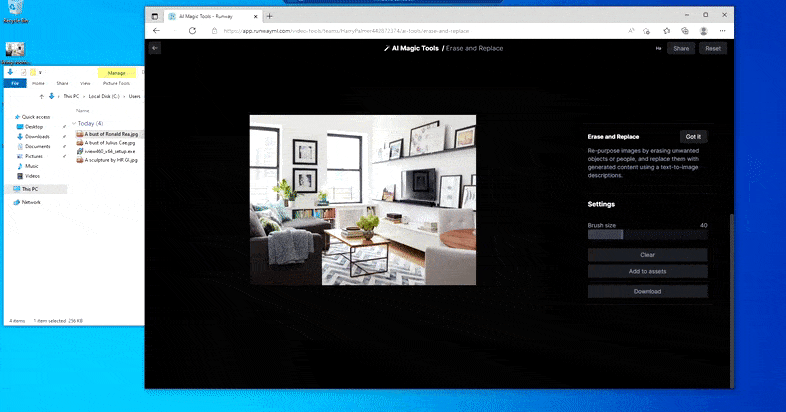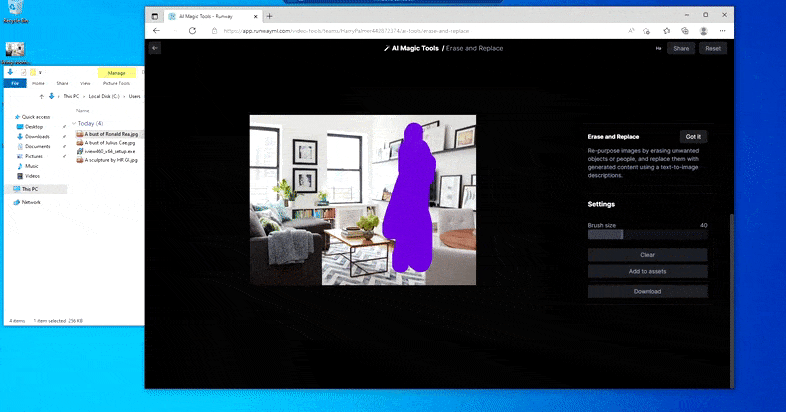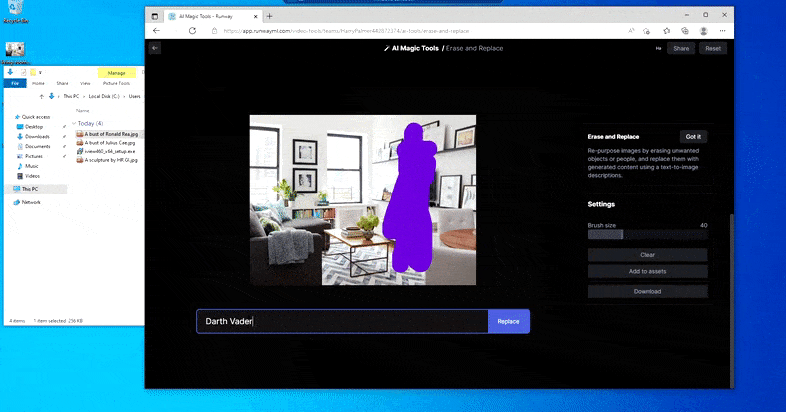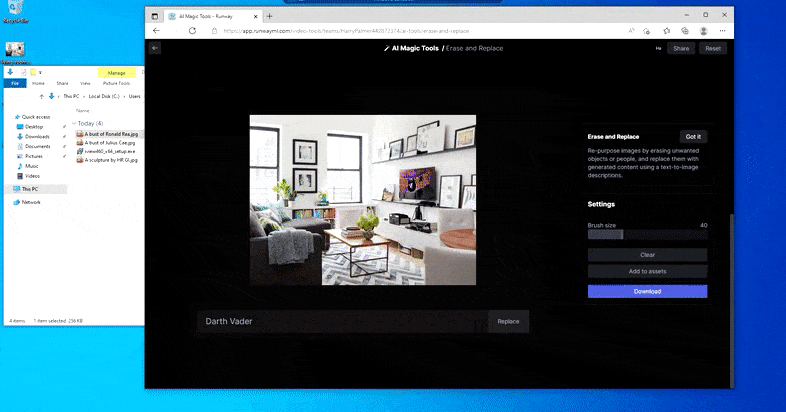
Jak wskazuje nazwa, nie można wstrzykiwać obiektów w pustą przestrzeń w Erase and Replace. Tutaj próba przywołania najsłynniejszego z lordów Sithów skutkuje dziwnym muralem związanym z Vaderem na telewizorze, mniej więcej w miejscu, gdzie narysowano obszar „replace”.
Trudno stwierdzić, czy Erase and Replace unika użycia chronionych prawem autorskim obrazów (które wciąż są w dużej mierze blokowane, choć z różnym skutkiem, w DALL‑E 2), czy też model używany w silniku renderującym po prostu nie jest zoptymalizowany pod takie zastosowania.

Nieco NSFW „Mural Nicole Kidman” wskazuje, że (prawdopodobnie) oparty na dyfuzji model nie posiada dawnych systematycznych odrzuceń DALL‑E 2 dotyczących renderowania realistycznych twarzy lub treści erotycznych, podczas gdy wyniki prób przywołania chronionych prac wahają się od niejasnego („xenomorf”) po absurdalne („żelazny tron”). W prawym dolnym rogu wstawka – obraz źródłowy.
Byłoby ciekawie dowiedzieć się, jakich metod używa Erase and Replace do izolacji obiektów, które może zamienić. Przypuszczalnie obraz jest przetwarzany przy użyciu pewnej wersji CLIP, a poszczególne elementy są identyfikowane przez rozpoznawanie obiektów i późniejszą segmentację semantyczną. Żadne z tych działań nie działa tak dobrze w typowej instalacji Stable Diffusion.
Jednak nic nie jest doskonałe – czasami system wydaje się wymazywać, a nie zamieniać, nawet gdy (jak widzieliśmy na powyższym obrazie) podstawowy mechanizm renderujący wyraźnie rozumie, co oznacza podpowiedź tekstowa. W takim wypadku niemożliwe jest przekształcenie stolika kawowego w xenomorfa – stolik po prostu znika.
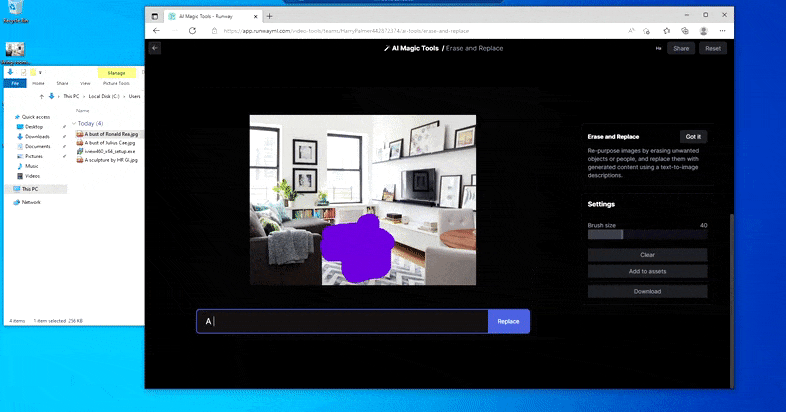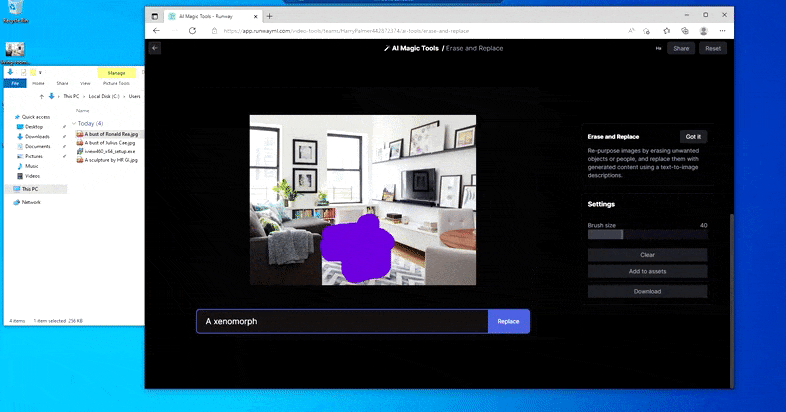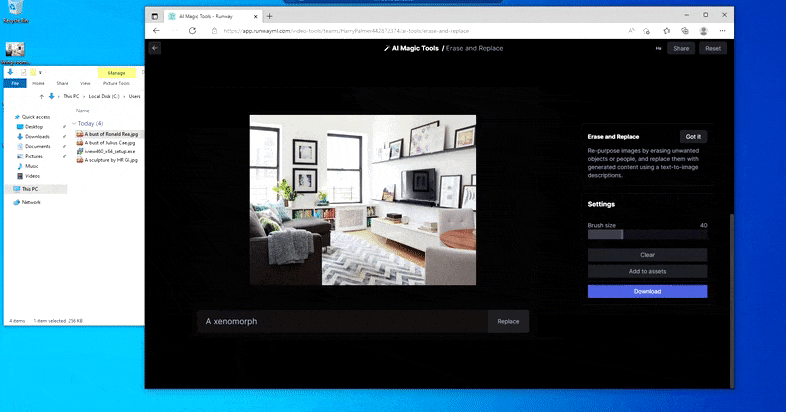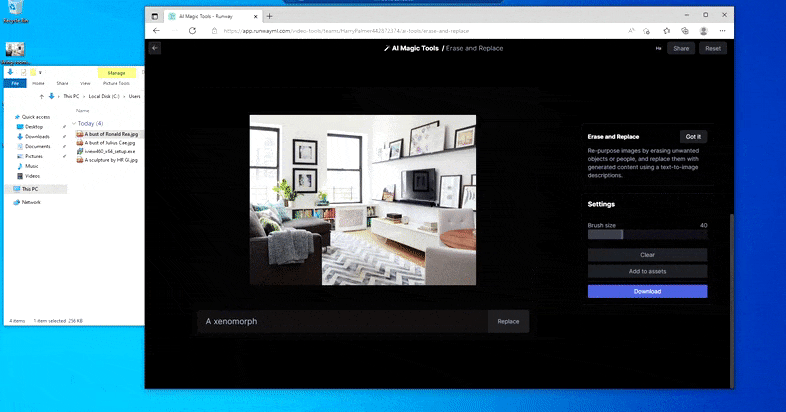
Straszniejsza wersja „Gdzie jest Waldo?”, gdy Erase and Replace nie udaje się stworzyć kosmity.
Erase and Replace wydaje się skutecznym systemem podmiany obiektów, z doskonałym wypełnianiem (inpainting). Jednak nie potrafi edytować istniejących postrzeganych obiektów, a jedynie je zamienia. Faktyczna zmiana istniejącej treści obrazu bez naruszania otaczającego materiału to prawdopodobnie znacznie trudniejsze zadanie, związane z długotrwałą walką sektora badań nad widzeniem komputerowym o rozłączaniu w różnych przestrzeniach latentnych popularnych frameworków.
Imagic
Jest to zadanie, które Imagic podejmuje. Nowy artykuł prezentuje liczne przykłady edycji, które skutecznie modyfikują poszczególne elementy zdjęcia, pozostawiając resztę obrazu nietkniętą.

W Imagic zmodyfikowane obrazy nie cierpią na charakterystyczne rozciąganie, zniekształcenia i „zgadywanie zakryć” typowe dla marionetek deepfake, które wykorzystują ograniczone priory oparte na pojedynczym obrazie.
System wykorzystuje trójstopniowy proces – optymalizację osadzenia tekstowego; dostrajanie modelu; oraz ostatecznie generowanie zmodyfikowanego obrazu.

Imagic koduje docelową podpowiedź tekstową, aby uzyskać początkowe osadzenie tekstowe, a następnie optymalizuje wynik, aby otrzymać obraz wejściowy. Następnie model generatywny jest dostrajany do obrazu źródłowego, dodając szereg parametrów, przed zastosowaniem żądanej interpolacji.
Nic dziwnego, że framework opiera się na architekturze tekst‑do‑wideo Google Imagen, choć badacze twierdzą, że zasady systemu mają szerokie zastosowanie do modeli dyfuzji latentnej.
Imagen wykorzystuje trójwarstwową architekturę, w przeciwieństwie do siedmiowarstwowej struktury używanej w nowszej wersji tekst‑do‑wideo oprogramowania firmy. Trzy odrębne moduły to: model generatywny dyfuzji działający w rozdzielczości 64 × 64 px; model super‑rozdzielczości, który podnosi tę rozdzielczość do 256 × 256 px; oraz dodatkowy model super‑rozdzielczości, który podnosi wynik aż do 1024 × 1024 px.
Imagic interweniuje już na najwcześniejszym etapie tego procesu, optymalizując żądane osadzenie tekstowe na etapie 64 px przy użyciu optymalizatora Adam z stałą szybkością uczenia 0,0001.

Mistrzowska lekcja rozłączania: użytkownicy, którzy próbowali zmienić coś tak prostego jak kolor renderowanego obiektu w modelu dyfuzji, GAN czy NeRF, wiedzą, jak istotne jest to, że Imagic potrafi przeprowadzić takie transformacje bez „rozerwania” spójności reszty obrazu.
Dostrajanie odbywa się następnie na bazowym modelu Imagen, przez 1500 kroków na każdy obraz wejściowy, warunkowane zaktualizowanym osadzeniem. Jednocześnie warstwa drugorzędna 64 px→256 px jest optymalizowana równolegle na obrazie warunkowanym. Badacze zauważają, że podobna optymalizacja końcowej warstwy 256 px→1024 px ma „mały lub żaden wpływ” na ostateczne wyniki, dlatego nie została wdrożona.
W publikacji podano, że proces optymalizacji zajmuje około ośmiu minut na każdy obraz przy użyciu podwójnych chipów TPUV4. Ostateczne renderowanie odbywa się w rdzeniu Imagen według schematu próbkowania DDIM.
Podobnie jak w przypadku podobnych procesów dostrajania dla Google DreamBooth, uzyskane osadzenia mogą dodatkowo służyć do stylizacji, a także do fotorealistycznych edycji zawierających informacje pochodzące z szerszej bazy danych napędzającej Imagen (ponieważ, jak pokazuje pierwsza kolumna poniżej, obrazy źródłowe nie zawierają niezbędnej treści…).

Elastyczne, fotorealistyczne ruchy i edycje można uzyskać za pomocą Imagic, a wyprowadzone i rozłączone kody uzyskane w tym procesie mogą równie łatwo służyć do stylizowanego wyjścia.
Badacze porównali Imagic z wcześniejszymi pracami SDEdit, podejściem opartym na GAN z 2021 roku, będącym współpracą Uniwersytetu Stanforda i Carnegie Mellon University; oraz Text2Live, współpracą z kwietnia 2022 roku między Instytutem Nauk Weizmann a NVIDIA.

Wizualne porównanie Imagic, SDEdit i Text2Live.
Jasne jest, że wcześniejsze podejścia mają trudności, ale w dolnym wierszu, który wymaga wprowadzenia drastycznej zmiany pozy, dotychczasowi gracze całkowicie nie radzą sobie z przekształceniem materiału źródłowego, w przeciwieństwie do wyraźnego sukcesu Imagic.
Wymagania zasobowe Imagic oraz czas treningu na obraz, choć krótkie w porównaniu z tego typu przedsięwzięciami, czynią go mało prawdopodobnym dodatkiem do lokalnej aplikacji do edycji obrazów na komputerach osobistych – i nie jest jasne, w jakim stopniu proces dostrajania mógłby zostać zredukowany do poziomu konsumenckiego.
Obecnie Imagic to imponująca propozycja, bardziej przystosowana do API – środowiska, w którym Google Research, ostrożny wobec krytyki związanej z ułatwianiem deepfake’ów, może czuć się najbardziej komfortowo.
Pierwsze opublikowanie 18 października 2022.


