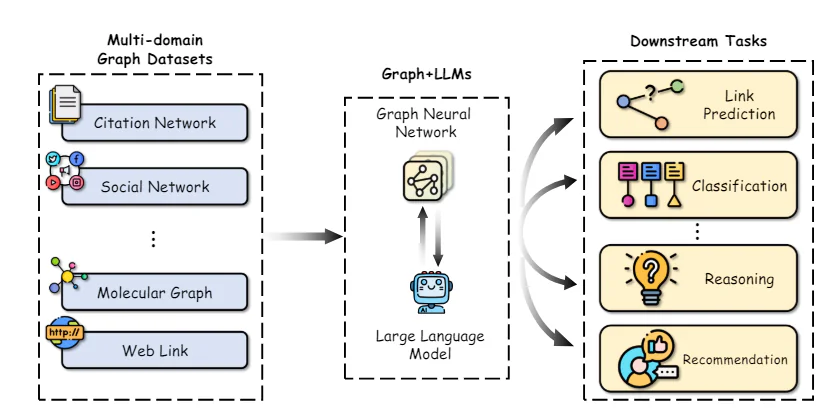
Grafy są strukturami danych, które reprezentują złożone relacje w szerokim zakresie dziedzin, w tym sieci społeczne, bazy wiedzy, systemy biologiczne i wiele innych. W tych grafach, jednostki są reprezentowane jako węzły, a ich relacje są przedstawiane jako krawędzie.
Możliwość skutecznej reprezentacji i rozumienia tych złożonych struktur relacyjnych jest kluczowa dla umożliwienia postępów w dziedzinach takich jak nauka o sieciach, chemia informacyjna i systemy rekomendacyjne.
Sieci neuronowe grafów (GNN) wyłoniły się jako potężna ramka głębokiego uczenia się dla zadań związanych z grafami. Poprzez włączenie topologii grafu do architektury sieci neuronowej za pomocą schematu agregacji sąsiedztwa lub konwolucji grafów, GNN mogą uczyć się niskowymiarowych wektorowych reprezentacji, które kodują zarówno cechy węzłów, jak i ich role strukturalne. Pozwala to GNN na osiąganie wyników na poziomie stanu sztuki w zadaniach takich jak klasyfikacja węzłów, predykcja połączeń i klasyfikacja grafów w różnych dziedzinach zastosowań.
Podczas gdy GNN przyniosły znaczny postęp, pozostają pewne kluczowe wyzwania. Uzyskanie wysokiej jakości danych etykietowanych do szkolenia nadzorowanego modelu GNN może być kosztowne i czasochłonne. Ponadto, GNN mogą mieć trudności z heterogenicznymi strukturami grafów i sytuacjami, w których dystrybucja grafu w czasie testowania znacznie różni się od danych szkoleniowych (generalizacja poza dystrybucją).
Równolegle, duże modele językowe (LLM) takie jak GPT-4 i LLaMA zrewolucjonizowały świat dzięki ich niesamowitym zdolnościom zrozumienia i generowania języka naturalnego. Szkolone na ogromnych korpusach tekstowych z miliardami parametrów, LLM wykazują zdumiewające zdolności do nauki w kilku przypadkach, generalizacji między zadaniami i zdolności do rozumowania, które wcześniej uważano za niezwykle trudne dla systemów AI.
Olbrzymi sukces LLM spowodował zainteresowanie wykorzystaniem ich mocy do zadań związanych z grafami. Z jednej strony, wiedza i zdolności rozumowania LLM prezentują możliwości poprawy tradycyjnych modeli GNN. Z drugiej strony, strukturalne reprezentacje i wiedza faktograficzna wewnętrznie obecne w grafach mogą być niezwykle przydatne w rozwiązaniu niektórych kluczowych ograniczeń LLM, takich jak halucynacje i brak interpretowalności.
Sieci neuronowe grafów i samouczne uczenie
Aby zapewnić niezbędny kontekst, najpierw krótko przypomnimy podstawowe pojęcia i metody w sieciach neuronowych grafów i samoucznym uczeniu reprezentacji grafów.
Kluczowa różnica między tradycyjnymi głębokimi sieciami neuronowymi a GNN polega na ich zdolności do bezpośredniej pracy z danymi o strukturze grafu. GNN stosują schemat agregacji sąsiedztwa, w którym każdy węzeł agreguje wektory cech z sąsiednich węzłów, aby obliczyć własną reprezentację.
Niedawno graficzne transformatory zyskały popularność, adaptując mechanizm uwagi samą z transformatorów językowych do pracy z danymi o strukturze grafu. Przykłady obejmują GraphormerTransformer i GraphFormers. Te modele są w stanie lepiej uchwycić dalekosiężne zależności w grafie w porównaniu z czysto sąsiedzkimi GNN.
Samouczne uczenie na grafach
Podczas gdy GNN są potężnymi modelami reprezentacji, ich wydajność jest często ograniczona przez brak dużych zbiorów danych z etykietami wymaganych do nadzorowanego szkolenia. Samouczne uczenie się wyłoniło jako obiecująca para dygma do wstępnego szkolenia GNN na nieoznaczonych danych grafowych, wykorzystując zadania pretekstowe, które wymagają tylko wewnętrznej struktury grafu i cech węzłów.
Niektóre powszechne zadania pretekstowe stosowane w samoucznym wstępnym szkoleniu GNN obejmują:
Predykcja właściwości węzłów: Losowe maskowanie lub uszkadzanie części atrybutów/właściwości węzłów i zlecenie GNN odtworzenia ich.
Predykcja krawędzi/łączy: Uczenie się predykcji, czy krawędź istnieje między parą węzłów, często w oparciu o losowe maskowanie krawędzi.
Nauka kontrastowa: Maksymalizacja podobieństw między widokami tego samego przykładu grafu, a jednocześnie oddalanie widoków z różnych grafów.
Maksymalizacja wzajemnej informacji: Maksymalizacja wzajemnej informacji między lokalnymi reprezentacjami węzłów a docelową reprezentacją, taką jak globalna reprezentacja grafu.
Zadania pretekstowe takie jak te pozwalają GNN na wydobycie znaczących strukturalnych i semantycznych wzorców z nieoznaczonych danych grafowych podczas wstępnego szkolenia. Wstępnie wytrenowany GNN może następnie zostać dostosowany do mniejszych zbiorów danych z etykietami, aby osiągnąć doskonałe wyniki w zadaniach takich jak klasyfikacja węzłów, predykcja połączeń i klasyfikacja grafów.
Dzięki wykorzystaniu samouczenia, GNN wstępnie szkolone na dużych nieoznaczonych zbiorach danych wykazują lepszą generalizację, wytrzymałość na zmiany dystrybucji i wydajność w porównaniu z trenowaniem od podstaw. Jednak niektóre kluczowe ograniczenia tradycyjnych metod samoucznego uczenia się opartych na GNN pozostają, które będziemy wykorzystywać do dalszego rozwoju z użyciem LLM.
Poprawa uczenia maszynowego grafów za pomocą dużych modeli językowych
Niesamowite możliwości LLM w zrozumieniu języka naturalnego, rozumowaniu i nauce w kilku przypadkach prezentują możliwości poprawy wielu aspektów potoków uczenia maszynowego grafów. Eksplorujemy niektóre kluczowe kierunki badań w tym obszarze:
Kluczowym wyzwaniem w stosowaniu GNN jest uzyskanie wysokiej jakości reprezentacji cech dla węzłów i krawędzi, zwłaszcza gdy zawierają bogate atrybuty tekstowe, takie jak opisy, tytuły lub abstrakty. Tradycyjnie proste worki słów lub wstępnie wytrenowane modele wektorów słów były używane, które często nie są w stanie uchwycić nuansów semantyki.
Niedawne prace wykazały potęgę wykorzystania dużych modeli językowych jako kodera tekstów do konstruowania lepszych reprezentacji cech węzłów/krówędzi przed przekazaniem ich do GNN. Na przykład Chen et al. wykorzystują LLM takie jak GPT-3 do kodowania atrybutów tekstowych węzłów, pokazując znaczne zyski wydajności w porównaniu z tradycyjnymi wektorami słów w zadaniach klasyfikacji węzłów.
Poza lepszymi kodowaniem tekstu, LLM mogą być wykorzystane do generowania uzupełniających informacji z oryginalnych atrybutów tekstowych w półnadzorowanym trybie. TAPE generuje potencjalne etykiety/wyjaśnienia dla węzłów za pomocą LLM i wykorzystuje je jako dodatkowe uzupełniające cechy. KEA wyodrębnia terminy z atrybutów tekstowych za pomocą LLM i uzyskuje szczegółowe opisy tych terminów, aby uzupełnić cechy.
Poprawiając jakość i wyrażalność wejściowych cech, LLM mogą nadać swoje wyższe zdolności zrozumienia języka naturalnego GNN, zwiększając wydajność w zadaniach podrzędnych.
Zmniejszanie zależności od danych z etykietami
Kluczową zaletą LLM jest ich zdolność do osiągania przyzwoitych wyników w nowych zadaniach z niewielką ilością lub bez danych z etykietami, dzięki ich wstępnemu szkoleniu na ogromnych korpusach tekstowych. Ta zdolność do nauki w kilku przypadkach może być wykorzystana do zmniejszenia zależności GNN od dużych zbiorów danych z etykietami.
Jednym z podejść jest użycie LLM do bezpośrednich predykcji na zadaniach grafowych, opisując strukturę grafu i informacje o węzłach w naturalnych prompach językowych. Metody takie jak InstructGLM i GPT4Graph dostosowują LLM takie jak LLaMA i GPT-4, wykorzystując starannie zaprojektowane prompty, które uwzględniają szczegóły topologii grafu, takie jak połączenia węzłów, sąsiedztwa itp. Dostosowane LLM mogą następnie generować predykcje dla zadań takich jak klasyfikacja węzłów i predykcja połączeń w trybie zero-shot podczas inferencji.
Podczas gdy użycie LLM jako czarnej skrzynki predykcyjnej wykazało obietnice, ich wydajność pogarsza się w przypadku bardziej złożonych zadań grafowych, w których korzystne jest jawne modelowanie struktury. Niektóre podejścia wykorzystują więc LLM w połączeniu z GNN – GNN koduje strukturę grafu, podczas gdy LLM zapewnia lepsze zrozumienie semantyki węzłów z ich opisów tekstowych.
GraphLLM eksploruje dwie strategie: 1) LLM jako wzmacniacze, gdzie LLM koduje atrybuty tekstowe węzłów przed przekazaniem ich do GNN, i 2) LLM jako predykatory, gdzie LLM przyjmuje pośrednie reprezentacje GNN jako dane wejściowe do ostatecznych predykcji.
GLEM idzie dalej, proponując algorytm EM z variacją, który na przemian aktualizuje składniki LLM i GNN dla wzajemnego wzmocnienia.
Zmniejszając zależność od danych z etykietami za pomocą zdolności do nauki w kilku przypadkach i półnadzorowanego uzupełniania, metody uczenia grafów z udziałem LLM mogą odblokować nowe aplikacje i poprawić efektywność danych.
Poprawa LLM za pomocą grafów
Podczas gdy LLM odniosły ogromny sukces, nadal cierpią na kluczowe ograniczenia, takie jak halucynacje (generowanie niefaktualnych oświadczeń), brak interpretowalności w procesie rozumowania i niezdolność do utrzymania spójnej wiedzy faktograficznej.
Grafy, zwłaszcza grafy wiedzy, które reprezentują strukturalną wiedzę faktograficzną z wiarygodnych źródeł, prezentują obiecujące ścieżki do rozwiązania tych ograniczeń. Eksplorujemy niektóre nowe podejścia w tym kierunku:
Wstępne szkolenie LLM z użyciem grafów wiedzy
Podobnie jak LLM są wstępnie szkolone na dużych korpusach tekstowych, niedawne prace wykorzystują je do wstępnego szkolenia na grafach wiedzy, aby nadać lepszą świadomość faktograficzną i zdolności rozumowania.
Niektóre podejścia modyfikują dane wejściowe, łącząc prosto lub wyrównując faktograficzne trójki KG z tekstem naturalnym podczas wstępnego szkolenia. E-BERT wyrównuje wektory encji KG z wektorami wordpiece BERT, podczas gdy K-BERT konstruuje drzewa zawierające oryginalne zdanie i odpowiednie trójki KG.
Rola LLM w uczeniu maszynowym grafów:
Badacze wykorzystali kilka sposobów integracji LLM w potoku uczenia grafów, każdy z nich ma swoje unikalne zalety i aplikacje. Oto niektóre z głównych ról, które LLM mogą odegrać:
LLM jako wzmacniacz: W tym podejściu LLM są wykorzystywane do wzbogacenia atrybutów tekstowych skojarzonych z węzłami w TAG. Możliwość LLM do generowania wyjaśnień, encji wiedzy lub pseudo-etykiet może uzupełnić informacje semantyczne dostępne dla GNN, prowadząc do poprawy reprezentacji węzłów i wyników zadań podrzędnych.
Na przykład model TAPE (Text Augmented Pre-trained Encoders) wykorzystuje ChatGPT do generowania wyjaśnień i pseudo-etykiet dla artykułów w sieci cytowań, które są następnie wykorzystywane do dalszego szkolenia modelu językowego. Wynikające z tego wektory są wprowadzane do GNN do zadań klasyfikacji węzłów i predykcji połączeń, osiągając wyniki na poziomie stanu sztuki.
LLM jako predykator: Zamiast wzmocnienia cech wejściowych, niektóre podejścia wykorzystują LLM bezpośrednio jako składnik predykcyjny dla zadań związanych z grafami. Obejmuje to konwersję struktury grafu w reprezentację tekstową, która może być przetworzona przez LLM, a następnie generuje pożądany wynik, taki jak etykiety węzłów lub predykcje poziomu grafu.
Jednym z godnych uwagi przykładów jest model GPT4Graph, który reprezentuje grafy za pomocą języka modelowania grafów (GML) i wykorzystuje potężny LLM GPT-4 do zadań rozumowania grafów w trybie zero-shot.
Wyrównanie GNN i LLM: Inny kierunek badań koncentruje się na wyrównaniu przestrzeni wektorowych GNN i LLM, umożliwiając bezproblemową integrację informacji strukturalnej i semantycznej. Podejścia te traktują GNN i LLM jako odrębne modality i wykorzystują techniki takie jak nauka kontrastowa lub destylacja do wyrównania ich reprezentacji.
Model MoleculeSTM, na przykład, wykorzystuje cel kontrastowy do wyrównania wektorów GNN i LLM, umożliwiając LLM uwzględnienie informacji strukturalnych z GNN, podczas gdy GNN korzysta z wiedzy semantycznej LLM.
Wyzwania i rozwiązania
Podczas gdy integracja LLM i uczenia grafów ma ogromne obietnice, kilka wyzwań musi być rozwiązanych:
Wydajność i skalowalność: LLM są notorycznie wymagające pod względem zasobów, często wymagając miliardów parametrów i ogromnej mocy obliczeniowej do szkolenia i inferencji. Może to być znaczącą przeszkodą w wdrożeniu modeli uczenia grafów z udziałem LLM w aplikacjach świata rzeczywistego, zwłaszcza na urządzeniach o ograniczonych zasobach.
Jednym z obiecujących rozwiązań jest destylacja wiedzy, w której wiedza z dużego LLM (model nauczyciela) jest przenoszona do mniejszego, bardziej wydajnego GNN (model ucznia).
Przecieki danych i ocena: LLM są wstępnie szkolone na ogromnych ilościach publicznie dostępnych danych, które mogą zawierać zestawy testowe z powszechnych zbiorów benchmarkowych, prowadząc do potencjalnych przecieków danych i przeszacowania wyników. Badacze zaczęli gromadzić nowe zbiory danych lub pobierać dane testowe z okresów po zakończeniu szkolenia LLM, aby złagodzić ten problem.
Ponadto ustanowienie sprawiedliwych i kompleksowych benchmarków oceny dla modeli uczenia grafów z udziałem LLM jest kluczowe do pomiaru ich prawdziwych możliwości i umożliwienia znaczących porównań.
Przenoszalność i wyjaśnialność: Chociaż LLM wyróżniają się w nauce w kilku przypadkach, ich zdolność do przenoszenia wiedzy na różne dziedziny i struktury grafów pozostaje otwartym wyzwaniem. Poprawa przenoszalności tych modeli jest kluczowym kierunkiem badań.
Ponadto poprawa wyjaśnialności modeli uczenia grafów z udziałem LLM jest niezbędna do budowania zaufania i umożliwienia ich przyjęcia w aplikacjach o wysokich stawkach. Wykorzystanie wewnętrznych zdolności rozumowania LLM za pomocą technik takich jak wyzwania myślowe może przyczynić się do lepszej wyjaśnialności.
Integracja multimodalna: Grafy często zawierają więcej niż tylko informacje tekstowe, a węzły i krawędzie mogą być skojarzone z różnymi modalnościami, takimi jak obrazy, audio lub dane numeryczne. Rozszerzenie integracji LLM na te multimodalne ustawienia grafów prezentuje ekscytującą możliwość przyszłych badań.
Aplikacje świata rzeczywistego i studia przypadków
Integracja LLM i uczenia maszynowego grafów już wykazała obietnice w różnych aplikacjach świata rzeczywistego:
Predykcja właściwości molekularnych: W dziedzinie chemii obliczeniowej i odkrywania leków, LLM zostały wykorzystane do poprawy predykcji właściwości molekularnych, integrując informacje strukturalne z molekularnych grafów. Model LLM4Mol, na przykład, wykorzystuje ChatGPT do generowania wyjaśnień dla reprezentacji molekuł w postaci SMILES, które są następnie wykorzystywane do poprawy dokładności zadań predykcji właściwości.
Uzupełnianie i rozumowanie grafów wiedzy: Grafy wiedzy są specjalnym rodzajem struktury grafu, reprezentującym encje świata rzeczywistego i ich relacje. LLM zostały wykorzystane do zadań takich jak uzupełnianie grafów wiedzy i rozumowanie, gdzie struktura grafu i informacje tekstowe (np. opisy encji) muszą być rozważane łącznie.
Systemy rekomendacyjne: W dziedzinie systemów rekomendacyjnych, struktury grafu są często wykorzystywane do reprezentowania interakcji między użytkownikami i elementami, z węzłami reprezentującymi użytkowników i elementy, a krawędziami oznaczającymi interakcje lub podobieństwa. LLM mogą być wykorzystane do wzmocnienia tych grafów, generując informacje o użytkownikach/elementach lub wzmacniając krawędzie interakcji.
Podsumowanie
Synergia między dużymi modelami językowymi a uczeniem maszynowym grafów prezentuje ekscytującą granicę badań w dziedzinie sztucznej inteligencji. Łącząc strukturalne uprzywilejowanie indukcyjne GNN z potężnymi zdolnościami zrozumienia semantyki LLM, możemy odblokować nowe możliwości w zadaniach związanych z grafami, zwłaszcza dla grafów z atrybutami tekstowymi.
Chociaż znaczny postęp został już dokonany, pozostają wyzwania w obszarach takich jak wydajność, skalowalność, przenoszalność i wyjaśnialność. Techniki takie jak destylacja wiedzy, sprawiedliwe benchmarki oceny i integracja multimodalna przygotowują drogę do praktycznego wdrożenia modeli uczenia grafów z udziałem LLM w aplikacjach świata rzeczywistego.
Przez ostatnie pięć lat zanurzałem się w fascynującym świecie Machine Learning i Deep Learning. Moja pasja i ekspertyza doprowadziły mnie do udziału w ponad 50 różnorodnych projektach inżynierii oprogramowania, ze szczególnym uwzględnieniem AI/ML. Moja nieustanna ciekawość również skierowała mnie w stronę Natural Language Processing, dziedziny, którą chcę dalej eksplorować.


 Dodaj Unite.AI do preferowanych źródeł w Google