
Modele i platformy AI
Sztuczna inteligencja wielomodalna ewoluuje, gdy ChatGPT zyskuje wzrok z GPT-4V(ision)

 Dodaj Unite.AI do preferowanych źródeł w Google

W ramach ciągłych wysiłków, aby uczynić sztuczną inteligencję bardziej podobną do ludzi, modele GPT OpenAI ciągle posuwają granice. GPT-4 jest teraz w stanie akceptować polecenia zarówno w postaci tekstu, jak i obrazów.
Wielomodalność w generatywnej sztucznej inteligencji oznacza zdolność modelu do generowania różnorodnych danych wyjściowych, takich jak tekst, obrazy lub dźwięk, w oparciu o dane wejściowe. Modele te, przeszkolone na określonych danych, uczą się podstawowych wzorców, aby generować podobne nowe dane, wzbogacając aplikacje sztucznej inteligencji.
Ostatnie postępy w sztucznej inteligencji wielomodalnej
Warto zwrócić uwagę na ostatni znaczący skok w tej dziedzinie, który jest widoczny w integracji DALL-E 3 z ChatGPT, co jest znaczącym ulepszeniem technologii tekst-to-image OpenAI. To połączenie pozwala na gładką interakcję, w której ChatGPT pomaga w tworzeniu precyzyjnych poleceń dla DALL-E 3, zmieniając pomysły użytkowników w żywe sztucznie generowane dzieła sztuki. Tak więc, podczas gdy użytkownicy mogą bezpośrednio wchodzić w interakcje z DALL-E 3, posiadanie ChatGPT w połączeniu sprawia, że proces tworzenia sztuki sztucznej inteligencji staje się znacznie bardziej przyjazny dla użytkownika.
Zobacz więcej na temat DALL-E 3 i jego integracji z ChatGPT tutaj. To połączenie nie tylko pokazuje postęp w sztucznej inteligencji wielomodalnej, ale także sprawia, że tworzenie sztuki sztucznej inteligencji staje się łatwiejsze dla użytkowników.

Firma Google wprowadziła Med-PaLM M w czerwcu tego roku. Jest to model generatywny wielomodalny, który jest zdolny do kodowania i interpretowania różnorodnych danych biomedycznych. To osiągnięcie zostało uzyskane poprzez dostosowanie modelu językowego PaLM-E do dziedzin medycznych, wykorzystując otwarte benchmarki, MultiMedBench. Ten benchmark składa się z ponad 1 miliona próbek w 7 typach danych biomedycznych i 14 zadaniach, takich jak generowanie raportów radiologicznych i odpowiedzi na pytania medyczne.
Różne branże przyjmują innowacyjne narzędzia sztucznej inteligencji wielomodalnej, aby napędzać rozwój biznesu, usprawniać operacje i podnosić zaangażowanie klientów. Postęp w zdolnościach sztucznej inteligencji głosowej, wideo i tekstowej napędza wzrost sztucznej inteligencji wielomodalnej.
Przedsiębiorstwa szukają aplikacji sztucznej inteligencji wielomodalnej, które mogą zmienić modele biznesowe i procesy, otwierając drogi wzrostu w całym ekosystemie sztucznej inteligencji generatywnej, od narzędzi danych do nowych aplikacji sztucznej inteligencji.
Po wydaniu GPT-4 w marcu niektórzy użytkownicy zauważyli spadek jakości odpowiedzi w czasie, co jest problemem, który został potwierdzony przez znanych deweloperów i na forach OpenAI. Początkowo odrzucony przez OpenAI, późniejsze badanie potwierdziło problem. Wykazało ono spadek dokładności GPT-4 z 97,6% do 2,4% między marcem a czerwcem, co wskazuje na spadek jakości odpowiedzi wraz z kolejnymi aktualizacjami modelu.

ChatGPT (niebieski) & sztuczna inteligencja (czerwony) trendy wyszukiwania Google
Hype wokół Open AI’s ChatGPT powrócił. Teraz posiada funkcję wizji GPT-4V, która pozwala użytkownikom na analizę obrazów podanych przez nich. Jest to najnowsza funkcja, która została udostępniona użytkownikom.
Dodanie analizy obrazu do dużych modeli językowych, takich jak GPT-4, jest postrzegane przez niektórych jako duży krok naprzód w badaniach i rozwoju sztucznej inteligencji. Ten rodzaj modelu językowego wielomodalnego otwiera nowe możliwości, przenosząc modele językowe poza tekst, aby oferować nowe interfejsy i rozwiązywać nowe rodzaje zadań, tworząc nowe doświadczenia dla użytkowników.
Szkolenie GPT-4V zostało zakończone w 2022 roku, a wczesny dostęp został udostępniony w marcu 2023 roku. Funkcja wizualna w GPT-4V jest napędzana przez technologię GPT-4. Proces szkolenia pozostał taki sam. Początkowo model został przeszkolony do przewidywania następnego słowa w tekście przy użyciu ogromnego zbioru danych tekstowych i obrazów z różnych źródeł, w tym z Internetu.
Później został dostosowany z użyciem dodatkowych danych, wykorzystując metodę wzmocnionego uczenia się z ludzkimi opiniami (RLHF), aby generować dane wyjściowe, które są preferowane przez ludzi.
Mechanika wizji GPT-4
Zdjęcia językowe GPT-4, chociaż imponujące, mają podstawowe metody, które pozostają na powierzchni.
Aby zbadać tę hipotezę, wprowadzono nowy model językowy wizji, MiniGPT-4, wykorzystujący zaawansowany model językowy o nazwie Vicuna. Ten model wykorzystuje kodery wizji z pre-trenowanymi komponentami do percepcji wizualnej, wyrównując zakodowane cechy wizualne z modelem językowym Vicuna za pomocą jednej warstwy projekcji. Architektura MiniGPT-4 jest prosta, ale skuteczna, z naciskiem na wyrównywanie cech wizualnych i językowych w celu poprawy zdolności konwersacyjnych.
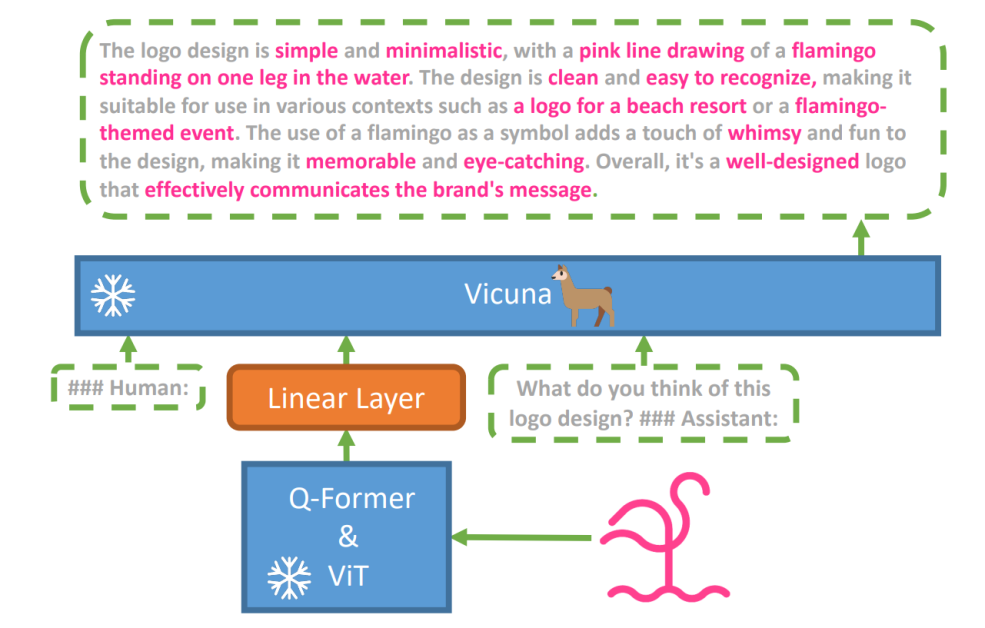
Architektura MiniGPT-4 zawiera kodery wizji z pre-trenowanymi komponentami ViT i Q-Former, jedną liniową warstwę projekcji oraz zaawansowany model językowy Vicuna.
Trend autoregresyjnych modeli językowych w zadaniach wizji-języka również wzrasta, wykorzystując transfer między modalnościami do udostępniania wiedzy między domenami języka i multimodalnymi.
MiniGPT-4 mostkuje domeny wizualne i językowe, wyrównując informacje wizualne z pre-trenowanego kodera wizji z zaawansowanym modelem językowym. Model wykorzystuje Vicuna jako dekodera językowego i stosuje dwuetapowy proces szkolenia. Początkowo jest szkolony na dużym zbiorze par obraz-tekst, aby zrozumieć wiedzę wizji-języka, a następnie dostosowany do mniejszego, wysokiej jakości zbioru danych, aby poprawić niezawodność i użyteczność generacji.
Aby poprawić naturalność i użyteczność generowanych języków w MiniGPT-4, badacze opracowali dwuetapowy proces wyrównywania, rozwiązując brak odpowiednich zestawów danych wizji-języka. Stworzyli specjalny zestaw danych do tego celu.
Początkowo model generował szczegółowe opisy obrazów wejściowych, poprawiając szczegółowość za pomocą konwersacyjnego polecenia wyrównanego z formatem modelu językowego Vicuna. Ten etap miał na celu generowanie bardziej kompletnych opisów obrazów.
Początkowe polecenie opisu obrazu:
###Człowiek: <Img><ImageFeature></Img>Opisz ten obraz szczegółowo. Podaj jak najwięcej szczegółów. Powiedz wszystko, co widzisz. ###Asystent:
Do przetwarzania danych wykorzystano korektę nieścisłości lub błędów w wygenerowanych opisach za pomocą ChatGPT, a następnie ręczną weryfikację, aby zapewnić wysoką jakość.
Polecenie dokładnego dostosowania:
###Człowiek: <Img><ImageFeature></Img><Instruction>###Asystent:
To badanie otwiera okno do zrozumienia mechaniki generatywnej sztucznej inteligencji wielomodalnej, takiej jak GPT-4, rzucając światło na to, jak modalności wizji i języka mogą być skutecznie zintegrowane, aby generować spójne i bogate kontekstowo dane wyjściowe.
Eksploracja wizji GPT-4
Określanie pochodzenia obrazów z ChatGPT
GPT-4 Vision zwiększa możliwości ChatGPT do analizy obrazów i określania ich pochodzenia geograficznego. Ta funkcja przenosi interakcje użytkowników z samego tekstu na połączenie tekstu i wizji, stając się przydatnym narzędziem dla tych, którzy są ciekawi różnych miejsc poprzez dane obrazowe.

Zapytanie ChatGPT o to, gdzie został wykonany obraz pomnika
Złożone pojęcia matematyczne
GPT-4 Vision wyróżnia się w analizowaniu złożonych pojęć matematycznych poprzez analizę wyrażeń graficznych lub odręcznych. Ta funkcja działa jako przydatne narzędzie dla osób, które chcą rozwiązać skomplikowane problemy matematyczne, czyniąc GPT-4 Vision godnym uwagi wsparciem w dziedzinach edukacyjnych i akademickich.

Zapytanie ChatGPT o zrozumienie złożonego pojęcia matematycznego
Przekształcanie danych wejściowych odręcznych w kody LaTeX
Jedną z godnych uwagi zdolności GPT-4V jest jego zdolność do tłumaczenia danych wejściowych odręcznych na kody LaTeX. Ta funkcja jest błogosławieństwem dla badaczy, akademików i studentów, którzy często muszą przekształcać wyrażenia matematyczne lub inne informacje techniczne zapisane odręcznie w postać cyfrową. Przekształcenie z odręcznego w LaTeX rozszerza horyzont cyfryzacji dokumentów i upraszcza proces pisania technicznego.

GPT-4V’s ability to convert handwritten input into LaTeX codes
Wydobywanie szczegółów tabeli
GPT-4V prezentuje umiejętność wydobywania szczegółów z tabel i odpowiadania na związane z nimi pytania, co jest istotnym atutem w analizie danych. Użytkownicy mogą wykorzystać GPT-4V do przeszukiwania tabel, gromadzenia kluczowych informacji i rozwiązywania pytań, czyniąc go solidnym narzędziem dla analityków danych i innych specjalistów.

GPT-4V deciphering table details and responding to related queries
Pochopienie wskazywania wizualnego
Unikalna zdolność GPT-4V do pochopenia wskazywania wizualnego dodaje nowy wymiar do interakcji użytkownika. Poprzez zrozumienie wskazań wizualnych, GPT-4V może odpowiadać na pytania z wyższym kontekstowym zrozumieniem.

GPT-4V showcases the distinct ability to comprehend visual pointing
Budowanie prostych stron internetowych za pomocą rysunku
Zainspirowany tym tweetem, próbowałem stworzyć makietę dla strony unite.ai.
Chociaż wynik nie całkowicie odpowiadał moim początkowym wizjom, oto efekt, jaki osiągnąłem.

ChatGPT Vision based output HTML Frontend
Ograniczenia i wady GPT-4V(ision)
Aby przeanalizować GPT-4V, zespół Open AI przeprowadził jakościowe i ilościowe oceny. Ocenę jakościową przeprowadzono za pomocą wewnętrznych testów i zewnętrznych recenzji ekspertów, a ocenę ilościową przeprowadzono, mierząc odmowy modelu i dokładność w różnych scenariuszach, takich jak identyfikacja szkodliwych treści, rozpoznawanie demograficzne, problemy z prywatnością, geolokalizacja, bezpieczeństwo cybernetyczne i multimodalne ataki.
Jednak model ten nie jest doskonały.
Artykuł artykuł podkreśla ograniczenia GPT-4V, takie jak błędne wnioski i brakujący tekst lub znaki w obrazach. Może on wymyślać lub wymyślać fakty. Szczególnie nie nadaje się do identyfikacji niebezpiecznych substancji w obrazach, często myląc je.
W obrazach medycznych GPT-4V może dostarczać niekonsekwentne odpowiedzi i brakuje mu świadomości standardowych praktyk, co może prowadzić do potencjalnych błędnych diagnoz.

Niewiarygodne wyniki dla celów medycznych (Źródło)
Ono również nie potrafi zrozumieć nuansów pewnych symboli nienawiści i może generować nieodpowiednie treści na podstawie wizualnych danych wejściowych. OpenAI zaleca, aby nie używać GPT-4V do krytycznych interpretacji, szczególnie w kontekstach medycznych lub wrażliwych.
Podsumowanie

Utworzone przy użyciu Fast Stable Diffusion XL https://huggingface.co/spaces/google/sdxl
Przybycie GPT-4 Vision (GPT-4V) wnosi wiele interesujących możliwości i nowych wyzwań. Przed wprowadzeniem go do użytku, wiele wysiłku włożono w minimalizowanie ryzyka, zwłaszcza w odniesieniu do zdjęć ludzi. Impresjonujące jest to, jak GPT-4V zwiększył swoje możliwości, pokazując duży potencjał w trudnych dziedzinach, takich jak medycyna i nauka.
Teraz pojawiają się duże pytania. Na przykład, czy te modele powinny być w stanie identyfikować znane osoby na zdjęciach? Czy powinny one zgadywać płeć, rasę lub uczucia osoby na podstawie obrazu? Czy powinny być specjalne dostosowania, aby pomóc osobom z niepełnosprawnościami wzroku? Te pytania otwierają puszkę robaka w kwestiach prywatności, sprawiedliwości i tego, jak sztuczna inteligencja powinna wpisywać się w nasze życie, co jest czymś, w czym każdy powinien mieć głos.


