
Modele i platformy AI
Llama 2: Głębokie wprowadzenie do otwartoźródłowego rywala ChatGPT

 Dodaj Unite.AI do preferowanych źródeł w Google

Duże modele językowe (LLM) zdolne do złożonych zadań rozumowania wykazały obiecujące wyniki w specjalistycznych dziedzinach, takich jak programowanie i twórcze pisanie. Jednak świat LLM nie jest po prostu rajem plug-and-play; istnieją wyzwania związane z użytecznością, bezpieczeństwem i wymaganiami obliczeniowymi. W tym artykule będziemy się zagłębiać w możliwości Llama 2, jednocześnie zapewniając szczegółową instrukcję dotyczącą konfigurowania tego wysokowydajnego LLM za pomocą Hugging Face i T4 GPU na Google Colab.
Został opracowany przez Meta we współpracy z Microsoft (MSFT ), ten otwarty model języka ma na celu zrewolucjonizować dziedziny sztucznej inteligencji generatywnej i rozumienia języka naturalnego. Llama 2 nie jest po prostu kolejnym modelem statystycznym wyszkolonym na terabajtach danych; jest wcieleniem filozofii. Jednej, która podkreśla podejście open-source jako podstawę rozwoju AI, szczególnie w przestrzeni AI generatywnej.
Llama 2 i jego dialogowo zoptymalizowana wersja, Llama 2-Chat, są wyposażone w maksymalnie 70 miliardów parametrów. Przechodzą one proces dokształcania, który ma na celu dopasowanie ich ściśle do ludzkich preferencji, co sprawia, że są one bezpieczniejsze i skuteczniejsze niż wiele innych publicznie dostępnych modeli. Ten poziom szczegółowości w dokształcaniu jest zwykle zarezerwowany dla zamkniętych “produktowych” LLM, takich jak ChatGPT i BARD, które nie są ogólnie dostępne do publicznej kontroli lub dostosowania.
Techniczne wprowadzenie do Llama 2
Do szkolenia modelu Llama 2; podobnie jak jego poprzednicy, wykorzystuje auto-regresyjną architekturę transformatora, wstępnie wyszkoloną na obszernym korpusie danych samouczących. Jednak dodaje dodatkową warstwę złożoności, wykorzystując uczenie ze wzmocnieniem z ludzką informacją zwrotną (RLHF), aby lepiej dopasować się do ludzkiego zachowania i preferencji. Jest to obliczeniowo drogie, ale niezbędne do poprawy bezpieczeństwa i skuteczności modelu.

Architektura szkoleniowa Meta Llama 2
Wstępne szkolenie i wydajność danych
Innowacyjność Llama 2 tkwi w jego reżimie wstępnego szkolenia. Model czerpie inspirację ze swojego poprzednika, Llama 1, ale wprowadza kilka kluczowych ulepszeń, aby poprawić swoją wydajność. Warto zauważyć, że wzrost o 40% w łącznej liczbie tokenów szkoleniowych i dwukrotny wzrost długości kontekstu wyróżniają się. Ponadto model wykorzystuje uwagę grupowaną (GQA), aby zwiększyć skalowalność wnioskowania.
Nadzorowane dokształcanie (SFT) i uczenie ze wzmocnieniem z ludzką informacją zwrotną (RLHF)
Llama-2-Chat został starannie dostosowany przy użyciu zarówno SFT, jak i RLHF. W tym kontekście SFT służy jako integralna część ramy RLHF, doskonaląc odpowiedzi modelu, aby ściśle dopasować się do ludzkich preferencji i oczekiwań.
OpenAI zapewnił przekonywujące ilustracje, które wyjaśniają metody SFT i RLHF stosowane w InstructGPT. Podobnie jak LLaMa 2, InstructGPT również wykorzystuje te zaawansowane techniki szkolenia, aby zoptymalizować wydajność modelu.
Krok 1 na poniższym obrazie koncentruje się na nadzorowanym dokształcaniu (SFT), podczas gdy następne kroki ukończą proces uczenia ze wzmocnieniem z ludzką informacją zwrotną (RLHF).

Nadzorowane dokształcanie (SFT) jest specjalnym procesem mającym na celu zoptymalizowanie wstępnie wyszkolonego dużego modelu językowego (LLM) do określonego zadania downstream. W przeciwieństwie do metod nienadzorowanych, które nie wymagają walidacji danych, SFT wykorzystuje zestaw danych, który został wcześniej zwalidowany i oznaczony.
Ogólnie tworzenie tych zestawów danych jest kosztowne i czasochłonne. Podejście Llama 2 było jakością nad ilością. Zaledwie 27 540 adnotacjami zespół Meta osiągnął poziomy wydajności konkurencyjne z ludzkimi adnotatorami. To odpowiada niedawnym badaniom, które pokazują, że nawet ograniczone, ale czyste zestawy danych mogą prowadzić do wysokiej jakości wyników.
W procesie SFT wstępnie wyszkolony LLM jest narażony na oznaczony zestaw danych, gdzie algorytmy uczenia nadzorowanego wchodzą w grę. Wewnętrzne wagi modelu są skalibrowane na podstawie gradientów obliczonych z funkcji straty określonej dla zadania.
Ta optymalizacja pozwala LLM na zrozumienie złożonych wzorców i niuansów wbudowanych w oznaczony zestaw danych. W konsekwencji model nie jest tylko ogólnym narzędziem, ale ewoluuje w specjalistyczne aktywo, biegłe w wykonywaniu zadania docelowego z wysokim stopniem dokładności.
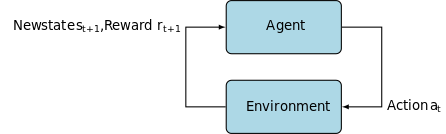
Uczenie ze wzmocnieniem jest następnym krokiem, mającym na celu dopasowanie zachowania modelu do ludzkich preferencji.
Faza strojenia wykorzystywała uczenie ze wzmocnieniem z ludzką informacją zwrotną (RLHF), zastosowując techniki takie jak Importance Sampling i Proximal Policy Optimization, aby wprowadzić algorytmiczny szum, tym samym unikając lokalnych optymalnych rozwiązań. To iteracyjne dokształcanie nie tylko poprawiło model, ale także dopasowało jego dane wyjściowe do ludzkich oczekiwań.
Llama 2-Chat wykorzystywał protokół porównawczy binarny do zbierania danych preferencji ludzkich, co stanowi znaczący trend w kierunku bardziej jakościowych podejść. Ten mechanizm poinformował Modele Nagrody, które są następnie wykorzystywane do dalszego dokształcania modelu AI konwersacyjnego.
Uwaga upiórów: dialogi wieloobrotowe
Meta wprowadził nową funkcję, Uwagę upiórów (GAtt), która jest zaprojektowana, aby poprawić wydajność Llama 2 w dialogach wieloobrotowych. To skutecznie rozwiązuje trwały problem utraty kontekstu w trwających rozmowach. GAtt działa jak kotwica, łącząc początkowe instrukcje ze wszystkimi następującymi wiadomościami użytkownika. Połączone z technikami uczenia ze wzmocnieniem, pomaga w generowaniu spójnych, istotnych i zgodnych z użytkownikiem odpowiedzi na dłuższe dialogi.
Z repozytorium Meta za pomocą download.sh
- Odwiedź stronę Meta: Przejdź do oficjalnej strony Llama 2 i kliknij ‘Pobierz model’
- Wypełnij szczegóły: Przeczytaj i zaakceptuj warunki, aby kontynuować.
- Potwierdzenie e-mail: Po wysłaniu formularza otrzymasz e-mail od Meta z linkiem do pobrania modelu z ich repozytorium.
- Uruchom download.sh: Sklonuj repozytorium i uruchom skrypt
download.sh. Ten skrypt poprosi Cię o uwierzytelnienie przy użyciu adresu URL od Meta, który wygasa w ciągu 24 godzin. Wybierzesz również rozmiar modelu – 7B, 13B lub 70B.
Z Hugging
- Otrzymaj e-mail z akceptacją: Po uzyskaniu dostępu od Meta, przejdź do Hugging Face.
- Poproś o dostęp: Wybierz swój model i złoż wniosek o przyznanie dostępu.
- Potwierdzenie: Oczekuj e-maila z potwierdzeniem w ciągu 1-2 dni.
- Wygeneruj tokeny dostępu: Przejdź do ‘Ustawień’ w swoim koncie Hugging Face, aby utworzyć tokeny dostępu.
Wydanie 4.31 Transformers jest w pełni kompatybilne z LLaMa 2 i otwiera wiele narzędzi i funkcjonalności w ekosystemie Hugging Face. Od skryptów szkoleniowych i inferencyjnych po kwantyzację 4-bitową z bitsandbytes i wydajne dokształcanie (PEFT), zestaw narzędzi jest obszerny. Aby rozpocząć, upewnij się, że używasz najnowszego wydania Transformers i że jesteś zalogowany w swoim koncie Hugging Face.
Oto przewodnik po uruchomieniu inferencji modelu LLaMa 2 w środowisku Google Colab, wykorzystując środowisko GPU:

Model Google Colab – T4 GPU
Instalacja pakietu
<p>!pip install transformers
!huggingface-cli login
Importuj niezbędne biblioteki Pythona.
from transformers import AutoTokenizer
import transformers
import torch
Zainicjuj model i tokenizator
W tym kroku określ, jaki model Llama 2 będziesz używał. W tym przewodniku użyjemy meta-llama/Llama-2-7b-chat-hf.
model = "meta-llama/Llama-2-7b-chat-hf"
tokenizer = AutoTokenizer.from_pretrained(model)
Skonfiguruj potok
Wykorzystaj potok Hugging Face do generowania tekstu z określonymi ustawieniami:
pipeline = transformers.pipeline(
"text-generation",
model=model,
torch_dtype=torch.float16,
device_map="auto")
Wygeneruj sekwencje tekstu
Na koniec uruchom potok i wygeneruj sekwencję tekstu na podstawie Twojego wejścia:
sequences = pipeline(
'Kto są kluczowymi współtwórcami w dziedzinie sztucznej inteligencji?\n',
do_sample=True,
top_k=10,
num_return_sequences=1,
eos_token_id=tokenizer.eos_token_id,
max_length=200)
for seq in sequences:
print(f"Wynik: {seq['generated_text']}")
Interfejs A16Z dla LLaMa 2
Andreessen Horowitz (A16Z) niedawno uruchomił zaawansowany interfejs oparty na Streamlit dla Llama 2. Hostowany na GitHub, ten interfejs zachowuje historię sesji czatu i zapewnia elastyczność w wyborze spośród wielu punktów końcowych Llama 2 hostowanych na Replicate. Ten interfejs ukierunkowany na użytkownika ma na celu uproszczenie interakcji z Llama 2, czyniąc go idealnym narzędziem zarówno dla deweloperów, jak i użytkowników końcowych. Dla zainteresowanych dostępny jest demo na żywo na Llama2.ai.

Llama 2: Co sprawia, że różni się od modeli GPT i jego poprzednika Llama 1?
Różnorodność w skali
W przeciwieństwie do wielu modeli językowych, które oferują ograniczoną skalowalność, Llama 2 oferuje wiele różnych opcji modeli o różnych parametrach. Model skaluje się od 7 miliardów do 70 miliardów parametrów, zapewniając szereg konfiguracji, aby spełnić różne potrzeby obliczeniowe.
Poprawiona długość kontekstu
Model ma zwiększoną długość kontekstu o 4K tokenów w porównaniu z Llama 1. To pozwala mu na zachowanie większej ilości informacji, co zwiększa jego zdolność do zrozumienia i wygenerowania bardziej złożonego i obszernego treści.
Uwaga grupowana (GQA)
Architektura wykorzystuje koncepcję GQA, zaprojektowaną, aby przyspieszyć obliczenia uwagi, buforując poprzednie pary tokenów. To skutecznie poprawia skalowalność wnioskowania modelu, zwiększając dostępność.
Wskaźniki wydajności

Analiza wydajności modeli Llama 2-Chat z ChatGPT i innymi konkurentami
Llama 2 ustanowił nowy standard w wskaźnikach wydajności. Nie tylko przewyższa swojego poprzednika, Llama 1, ale również stanowi znaczącą konkurencję dla innych modeli, takich jak Falcon i GPT-3.5.
Największy model Llama 2-Chat, 70B, również przewyższa ChatGPT w 36% przypadków i równa się wydajności w kolejnych 31,5% przypadków. Źródło: Artykuł
Otwarty kod: Siła społeczności
Meta i Microsoft zamierzają, aby Llama 2 był nie tylko produktem, ale także narzędziem napędzanym przez społeczność. Llama 2 jest bezpłatny do użytku zarówno w celach badawczych, jak i niekomercyjnych. Ich celem jest udostępnienie możliwości AI, czyniąc je dostępnymi dla startupów, badaczy i firm. Podejście open-source pozwala na “crowdsourced troubleshooting” modelu. Deweloperzy i etycy AI mogą testować, identyfikować słabości i oferować rozwiązania w przyspieszonym tempie.
Chociaż warunki licencyjne LLaMa 2 są generalnie permissive, wyjątki istnieją. Duże przedsiębiorstwa z ponad 700 milionami użytkowników miesięcznie, takie jak Google, wymagają wyraźnego upoważnienia od Meta do jego wykorzystania. Ponadto licencja zabrania wykorzystania LLaMa 2 do ulepszania innych modeli językowych.
Bieżące wyzwania z Llama 2
- Uogólnienie danych: Zarówno Llama 2, jak i GPT-4 czasami zawodzą w jednolicie wysokiej wydajności we wszystkich zadaniach. Jakość i różnorodność danych są równie ważne jak ich objętość w tych scenariuszach.
- Przezroczystość modelu: Biorąc pod uwagę wcześniejsze niepowodzenia AI w generowaniu mylących danych wyjściowych, zbadanie podstawy decyzyjnej tych złożonych modeli jest kluczowe.
Code Llama – Najnowszy start Meta
Meta niedawno ogłosiła Code Llama, który jest dużym modelem językowym specjalizującym się w programowaniu o rozmiarach parametrów od 7B do 34B. Podobnie jak ChatGPT Code Interpreter; Code Llama może usprawnić przepływ pracy deweloperskiej i uczynić programowanie bardziej dostępnym. Obsługuje wiele języków programowania i jest dostępny w specjalistycznych wersjach, takich jak Code Llama–Python do zadań specyficznych dla Pythona. Model oferuje również różne poziomy wydajności, aby spełnić różne wymagania dotyczące opóźnień. Udostępniony na zasadach otwartego oprogramowania, Code Llama zaprasza do udziału społeczności w ciągłym doskonaleniu.
https://about.fb.com/news/2023/08/code-llama-ai-for-coding/
Podsumowanie
Ten artykuł przeprowadził Cię przez proces konfigurowania modelu Llama 2 do generowania tekstu na Google Colab z obsługą Hugging Face. Wydajność Llama 2 jest napędzana przez szereg zaawansowanych technik, od architektury transformatora auto-regresyjnego po uczenie ze wzmocnieniem z ludzką informacją zwrotną (RLHF). Z maksymalnie 70 miliardami parametrów i funkcjami takimi jak Uwaga upiórów, ten model przewyższa obecne standardy branżowe w pewnych obszarach, a dzięki swojej otwartej naturze, otwiera drogę do nowej ery w rozumieniu języka naturalnego i sztucznej inteligencji generatywnej.


