
Kąt Andersona
Identyfikowanie fałszywych twarzy celebrytów z zewnętrznych obszarów twarzy

 Dodaj Unite.AI do preferowanych źródeł w Google
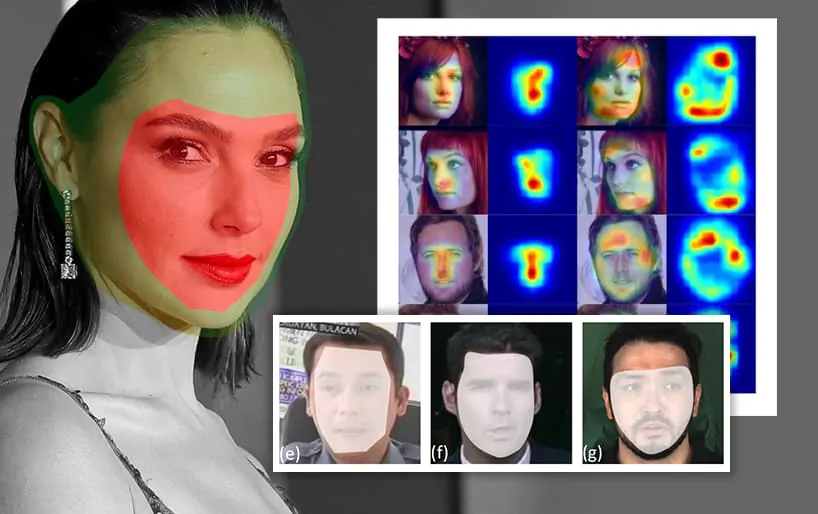
Nowe współpraca między firmą Microsoft (MSFT ) a chińskim uniwersytetem zaproponowała nowy sposób identyfikacji fałszywych twarzy celebrytów, wykorzystując słabości obecnych technik fałszywych twarzy do rozpoznania tożsamości, które zostały “przełożone” na innych ludzi.
Podejście to nazywa się Identity Consistency Transformer (ICT) i działa przez porównanie zewnętrznych części twarzy (żuchwy, kości policzkowych, linii włosów i innych zewnętrznych cech) z wnętrzem twarzy. System wykorzystuje powszechnie dostępne dane obrazowe znanych osób, co ogranicza jego skuteczność do popularnych celebrytów, których obrazy są dostępne w dużych ilościach w powszechnie dostępnych zbiorach danych i w Internecie.

The forgery coverage of faked faces across seven techniques: DeepFake in FF+; DeepFake in Google DeepFake Detection; DeepFaceLab; Face2Face; FSGAN; and DF-VAE. Popular packages such as DeepFaceLab and FaceSwap provide similarly constrained coverage. Source: https://arxiv.org/pdf/2203.01318.pdf
Jak ilustruje powyższy obraz, obecne popularne metody fałszywych twarzy są dość ograniczone i opierają się na odpowiednich twarzach-gospodarzach (obrazie lub filmie osoby, której tożsamość zostanie zastąpiona przez fałszywą twarz), aby zminimalizować dowody podmiany twarzy.
Chociaż różne metody mogą obejmować całą czoło i dużą część policzków i żuchwy, wszystkie są bardziej lub mniej ograniczone w ramach twarzy-gospodarza.

A saliency map that emphasizes the ‘inner’ and ‘outer’ identities calculated by ICT. Where an inner facial match is established but an outer identity does not correspond, ICT evaluates the image as false.
W testach ICT okazał się w stanie wykryć fałszywe treści w fałszywych warunkach, takich jak niska rozdzielczość wideo, gdzie zawartość całego filmu jest pogorszona przez artefakty kompresji, co utrudnia wykrycie fałszywej twarzy – okoliczność, która utrudnia wiele konkurencyjnych metod wykrywania fałszywych twarzy.

ICT outperforms contenders in recognizing deepfake content. See video embedded at end of article for more examples and better resolution. See embedded source video at end of article for further examples. Source: https://www.youtube.com/watch?v=zgF50dcymj8
The paper is titled Protecting Celebrities with Identity Consistency Transformer, and comes from nine researchers variously affiliated to the University of Science and Technology of China, Microsoft Research Asia, and Microsoft Cloud + AI.
Luka wiarygodności
Istnieją co najmniej dwa powody, dla których popularne algorytmy zamiany twarzy, takie jak DeepFaceLab i FaceSwap, zaniedbują zewnętrzne obszary zamienianych tożsamości.
Po pierwsze, szkolenie modeli fałszywych twarzy jest czasochłonne i wymaga dużych zasobów, a przyjęcie “kompatybilnych” twarzy-gospodarzy zwalnia cykle GPU i epoki, aby skoncentrować się na względnie niezmiennych wewnętrznych obszarach twarzy, których używamy do rozróżnienia tożsamości (ponieważ zmienne, takie jak wahania wagi i starzenie, są najmniej prawdopodobne, aby zmienić te podstawowe cechy twarzy w krótkim czasie).
Po drugie, większość podejść fałszywych twarzy (i jest to zdecydowanie przypadkiem z DeepFaceLab, oprogramowaniem używanym przez najbardziej popularnych lub najbardziej znanych praktyków) ma ograniczoną możliwość replikacji “końcowych” marginesów twarzy, takich jak policzki i żuchwa, i są ograniczone przez fakt, że ich kod źródłowy (z 2017 roku) nie rozwiązał tego problemu w sposób wystarczający.
W przypadkach, gdy tożsamości nie pasują dobrze, algorytm fałszywych twarzy musi “wypełnić” tło wokół twarzy, co robi niezręcznie, nawet w rękach najlepszych fałszerzy, takich jak Ctrl Shift Face, którego prace zostały wykorzystane w badaniach.

The best of the best: stills from a deepfake video from acclaimed deepfaker Ctrl-Shift-Face, swapping Jim Carrey over Gary Oldman. This work arguably represents some of the best output currently available via DeepFaceLab and post-processing techniques. Nonetheless, the swaps remain limited to the relatively scant attention that DFL gives to the outer face, requiring a Herculean effort of data curation and training to address the outermost lineaments. Source: https://www.youtube.com/watch?v=x8igrh1eyLk
To “sztuczne” lub odwrócenie uwagi w dużej mierze umyka uwadze publicznej w obecnym niepokoju o rosnącej realizmie fałszywych twarzy, ponieważ nasze zdolności krytyczne wokół fałszywych twarzy są jeszcze w fazie rozwoju poza etapem “szoku i podziwu”.
Podzielone tożsamości
Nowy artykuł zauważa, że większość poprzednich metod wykrywania fałszywych twarzy opiera się na artefaktach, które zdradzają proces zamiany, takich jak niespójne pozy head i mruganie, wśród wielu innych technik. Tylko w zeszłym tygodniu inny nowy artykuł o wykrywaniu fałszywych twarzy zapropponował wykorzystanie “sygnatury” różnych typów modeli w ramach FaceSwap, aby pomóc w identyfikacji sfałszowanych filmów wideo utworzonych za pomocą tego oprogramowania (patrz poniższy obraz).

Identifying deepfakes by characterizing the signatures of different model types in the FaceSwap framework. Source: https://arxiv.org/pdf/2202.12951.pdf
Natomiast architektura ICT tworzy dwie oddzielne, zagnieżdżone tożsamości dla osoby, z których każda musi być zweryfikowana, zanim cała tożsamość zostanie uznana za “prawdziwą” lub sfałszowaną.

Architecture for the training and testing phases of ICT.
Podział tożsamości jest ułatwiony przez transformator wizyjny, który wykonuje identyfikację twarzy, a następnie dzieli badane obszary na tokeny należące do wewnętrznych lub zewnętrznych tożsamości.

Distributing patches among the two parallel identity signifiers.
Artykuł stwierdza:
‘Niestety, istniejące metody weryfikacji twarzy tendencję do charakteryzowania najbardziej dyskryminacyjnego obszaru, tj. wewnętrznej twarzy do weryfikacji i nie udaje się uchwycić informacji o tożsamości w zewnętrznej twarzy. Z Identity Consistency Transformer, trenujemy model, aby nauczyć się pary wektorów tożsamości, jeden dla wewnętrznej twarzy i inny dla zewnętrznej twarzy, projektując transformator, tak aby wewnętrzna i zewnętrzna tożsamość mogły być nauczone jednocześnie w zunifikowanym modelu.’
Ponieważ nie istnieje żaden istniejący model dla tego protokołu identyfikacji, autorzy opracowali nowy rodzaj straty spójności, który może działać jako miara autentyczności. “Token wewnętrzny” i “token zewnętrzny”, które wynikają z modelu ekstrakcji tożsamości, są dodawane do bardziej konwencjonalnych patch embeddings wytworzonych przez ramy identyfikacji twarzy.
Dane i szkolenie
Sieć ICT została przeszkolona na zbiorze danych Microsoft Research’s MS-Celeb-1M, który zawiera 10 milionów obrazów twarzy celebrytów, obejmujących jeden milion tożsamości, w tym aktorów, polityków i innych typów prominentnych postaci. Zgodnie z procedurą poprzedniej metody Face X-ray (innej inicjatywy Microsoft Research), rutyna generowania fałszywych danych ICT wymienia wewnętrzne i zewnętrzne obszary twarzy pobrane z tego zbioru danych, aby utworzyć materiał do testowania algorytmu.
Aby wykonać te wewnętrzne zamiany, ICT identyfikuje dwa obrazy w zbiorze danych, które wykazują podobne pozy głowy i cechy twarzy, generuje region maski cech centralnych (do którego można wykonać zamianę), a następnie wykonuje fałszywą zamianę twarzy z korekcją koloru RGB.
Przyczyną, dla której ICT jest ograniczony do identyfikacji celebrytów, jest to, że opiera się (w swojej najbardziej efektywnej wersji) na nowym zbiorze odniesień, który zawiera pochodne wektory twarzy z centralnego korpusu (w tym przypadku MS-Celeb-1M, chociaż odniesienia mogą być rozszerzone do obrazów sieciowych, które najprawdopodobniej istnieją tylko w wystarczającej jakości i ilości dla znanych postaci publicznych).
Te pochodne pary wektorów działają jako tokeny autentyczności, aby zweryfikować wewnętrzne i zewnętrzne obszary twarzy jednocześnie.
Autorzy zauważają, że tokeny uzyskane z tych metod reprezentują “wysokiego poziomu” cechy, w wyniku czego proces wykrywania fałszywych twarzy jest bardziej prawdopodobny, aby przetrwać w trudnych środowiskach, takich jak niska rozdzielczość lub inne pogorszone wideo.
Kluczowe jest to, że ICT nie szuka dowodów opartych na artefaktach, ale raczej koncentruje się na metodach weryfikacji tożsamości, które są bardziej zgodne z technikami rozpoznawania twarzy – podejściem, które jest trudne z niskim wymiarem danych, takim jak w przypadku dochodzenia w sprawie incydentów fałszywych twarzy zemsty przeciwko nieznanej osobie.
Testy
Przeszkolony na MS-Celeb-1M, ICT został podzielony na wersje z odniesieniami i “ślepe” algorytmu, a następnie przetestowany wobec szeregu konkurencyjnych zbiorów danych i metod. Te metody obejmowały FaceForensics++ (FF++), zbiór 1000 autentycznych i fałszywych filmów wideo utworzonych przy użyciu czterech metod, w tym Face2Face i FaceSwap; Google’s Deepfake Detection (DFD), również składający się z tysięcy filmów wideo fałszywych twarzy wygenerowanych przez Google; Celeb-DeepFake v1 (CD1), który zawiera 408 prawdziwych i 795 sfabrykowanych, niskich artefaktów filmów wideo; Celeb-DeepFake v2, rozszerzenie wersji V1, zawierające 590 prawdziwych i 5,639 fałszywych filmów wideo; oraz chiński zbiór Deeper-Forensics (Deeper) z 2020 roku.
Te są zbiory danych; metody wykrywania fałszywych twarzy w teście obejmowały Multi-task, MesoInc4, Capsule, Xception-c0, c2 (metoda zastosowana w FF++), FWA/DSP-FW z University at Albany, Two-Branch, PCL+I2G, oraz metodę kontekstowej niespójności Yuvala Nirkin.
Wspomniane metody wykrywania są ukierunkowane na wykrywanie konkretnych typów manipulacji twarzą. Oprócz tych, autorzy nowego artykułu przetestowali bardziej ogólne oferty wykrywania fałszywych twarzy Face X-ray, FFD z Michigan State University, CNNDetection, oraz Patch-Forensics z MIT CSAIL.
Najbardziej widoczne wyniki z testu są takie, że metody konkurencyjne dramatycznie spadają w skuteczności, gdy rozdzielczość i jakość wideo maleją. Ponieważ część najbardziej poważnych możliwości fałszywych twarzy leży (nie tylko obecnie) w nie-HD lub innych pogorszonych wideo, wydaje się to znaczący wynik.

Na powyższym wykresie wyników niebieska i czerwona linia wskazują na wytrzymałość metod ICT na pogorszenie obrazu we wszystkich obszarach, z wyjątkiem przeszkody szumu Gaussa (co nie jest prawdopodobne w przypadku filmów wideo z Zoom i kamery internetowej), podczas gdy metody konkurencyjne mają malejącą niezawodność.
W tabeli wyników poniżej widzimy skuteczność różnych metod wykrywania fałszywych twarzy w danych nieznanego pochodzenia. Szare i gwiazdkowane wyniki wskazują porównanie z oryginalnymi wynikami z zamkniętych projektów, które nie mogą być zweryfikowane zewnętrznie. Przez większość porównywalnych ram, ICT przewyższa rywalizujące metody wykrywania fałszywych twarzy (wyróżnione pogrubieniem) w danych testowych.

Jako dodatkowy test, autorzy uruchomili zawartość z kanału YouTube uznanego fałszerza Ctrl Shift Face i stwierdzili, że metody konkurencyjne osiągnęły znacznie gorsze wyniki identyfikacji:

Godne uwagi jest to, że metody FF++ (Xception-c23) i FFD, które osiągają niektóre z najwyższych wyników w niektórych danych testowych w nowym artykule, osiągają znacznie niższy wynik niż ICT w “rzeczywistym” kontekście wysiłku fałszywych twarzy.
Autorzy kończą artykuł z nadzieją, że jego wyniki skierują społeczność wykrywania fałszywych twarzy ku podobnym inicjatywom, które koncentrują się na bardziej ogólnych cechach wysokiego poziomu, i z dala od “zimnej wojny” wykrywania artefaktów, w której najnowsze metody są rutynowo unieważniane przez rozwój fałszywych twarzy lub przez inne czynniki, które sprawiają, że takie metody są mniej wytrzymałe.
Sprawdź załączony film uzupełniający poniżej, aby zobaczyć więcej przykładów ICT identyfikujących fałszywe treści, które często przewyższają alternatywne metody.
Pierwotnie opublikowane 4 marca 2022 r.


