
Kąt Andersona
Jak Stable Diffusion może stać się produktem dla masowego odbiorcy

 Dodaj Unite.AI do preferowanych źródeł w Google
Kluczowe punktyPopularna aplikacja Stable Diffusion musi rozwiązać swoje złożone problemy z instalacją…
Zobacz więcej
- Popularna aplikacja Stable Diffusion musi rozwiązać swoje złożone problemy z instalacją z linii poleceń i zależnościami.
- Komercyjni deweloperzy stoją przed ryzykiem prawnym związanym z generowaniem deepfake'ów i filtrami treści NSFW.
- Zaawansowane funkcje, takie jak spójność czasowa i inwersja tekstowa, wymagają przetwarzania w chmurze do użytku konsumenckiego.
Jak na ironię, Stable Diffusion, nowy system syntezy obrazów AI, który podbił świat, nie jest ani stabilny, ani naprawdę rozpowszechniony — przynajmniej jeszcze nie.
Pełne możliwości systemu są rozproszone wśród zmieniającej się mieszanki rozwiązań kilku programistów, którzy gorączkowo wymieniają najnowsze informacje i teorie w różnych dyskusjach na Discordzie. Większość procedur instalacyjnych tworzonych lub modyfikowanych przez nich pakietów jest bardzo daleka od plug and play.
Zazwyczaj potrzebna jest instalacja z wiersza poleceń lub za pomocą plików BAT z użyciem GIT, Conda, Pythona, Minicondy i innych najnowocześniejszych środowisk programistycznych. Pakiety te są tak rzadkie na komputerach zwykłych konsumentów, że ich instalacja jest często oznaczana przez programy antywirusowe i antymalware jako dowód naruszenia bezpieczeństwa komputera.

Zaledwie niewielki wybór etapów trudnej ścieżki, której wymaga obecnie standardowa instalacja Stable Diffusion. Wiele dystrybucji wymaga też określonych wersji Pythona, mogących kolidować z wersjami zainstalowanymi na komputerze użytkownika. Można temu zapobiec za pomocą Dockera, a do pewnego stopnia także środowisk Conda.
Wątki w społecznościach Stable Diffusion zarówno SFW, jak i NSFW są pełne porad dotyczących modyfikowania skryptów Pythona i standardowych instalacji, aby rozszerzyć funkcje, usunąć częste błędy zależności i rozwiązać inne problemy.
Przeciętny konsument zainteresowany tworzeniem niesamowitych obrazów z promptów tekstowych jest więc w dużej mierze zdany na rosnącą liczbę płatnych interfejsów internetowych API. Większość pozwala wygenerować tylko kilka obrazów bezpłatnie, zanim zażąda kupna tokenów.
Ponadto niemal wszystkie te usługi odmawiają tworzenia treści NSFW. Wiele takich treści może dotyczyć niepornograficznych tematów ogólnego zainteresowania, takich jak wojna. Właśnie ta możliwość odróżnia Stable Diffusion od ocenzurowanych usług DALL-E 2 firmy OpenAI.
Photoshop dla Stable Diffusion
Codzienne fantastyczne, śmiałe lub nieziemskie obrazy pod hashtagiem #stablediffusion na Twitterze rozbudzają apetyt. Szersza publiczność zapewne czeka na Photoshop dla Stable Diffusion — instalowalny program wieloplatformowy łączący najlepsze i najmocniejsze funkcje architektury Stability.ai z pomysłowymi innowacjami rodzącej się społeczności SD, bez osobnych okien wiersza poleceń, niejasnych i zmiennych procedur instalacji i aktualizacji oraz brakujących funkcji.
Obecnie większość bardziej zaawansowanych instalacji udostępnia mniej lub bardziej elegancką stronę internetową połączoną z osobnym oknem poleceń, której URL wskazuje port localhost:

Podobnie jak narzędzia syntezy sterowane z wiersza poleceń, takie jak FaceSwap i oparty na BAT DeepFaceLab, gotowy pakiet Stable Diffusion zdradza swoje korzenie. Interfejs otwiera się przez port localhost, widoczny u góry obrazu, który komunikuje się z funkcjami Stable Diffusion w wierszu poleceń.
Bardziej dopracowana aplikacja niewątpliwie nadejdzie. Już teraz można pobrać kilka zintegrowanych aplikacji opartych na Patreon, takich jak GRisk i NMKD (patrz poniżej), ale żadna nie łączy jeszcze wszystkich funkcji dostępnych w bardziej zaawansowanych i mniej przystępnych implementacjach Stable Diffusion.

Wczesne pakiety Stable Diffusion oparte na Patreon, lekko przerobione na aplikacje. NMKD jako pierwszy integruje wyjście wiersza poleceń bezpośrednio w GUI.
Zobaczmy, jak mogłaby wyglądać bardziej dopracowana i kompletna implementacja tego zdumiewającego projektu open source i jakie wyzwania mogłaby napotkać.
Kwestie prawne dotyczące dobrze finansowanej komercyjnej aplikacji Stable Diffusion
Czynnik NSFW
Kod źródłowy Stable Diffusion udostępniono na bardzo liberalnej licencji, która nie zabrania komercyjnych reimplementacji ani utworów pochodnych szeroko korzystających z tego kodu.
Poza wspomnianymi i coraz liczniejszymi wersjami opartymi na Patreon powstaje wiele wtyczek do aplikacji takich jak Figma, Krita, Photoshop, GIMP i Blender. Nie ma zatem praktycznego powodu, dla którego dobrze finansowana firma programistyczna nie mogłaby stworzyć znacznie bardziej zaawansowanej aplikacji Stable Diffusion. Z perspektywy rynku istnieją wszelkie powody, by sądzić, że kilka takich inicjatyw już daleko zaszło.
Takie projekty od razu muszą rozstrzygnąć, czy aplikacja, podobnie jak większość internetowych API Stable Diffusion, pozwoli wyłączyć natywny filtr NSFW, czyli fragment kodu.
Ukrycie przełącznika NSFW
Chociaż licencja open source Stability.ai dla Stable Diffusion zawiera szeroko interpretowaną listę zastosowań, do których nie wolno go używać, obejmującą zapewne treści pornograficzne i deepfake’i, jedynym skutecznym sposobem zakazania takiego użycia byłoby skompilowanie filtra NSFW do nieprzejrzystego pliku wykonywalnego zamiast parametru w pliku Pythona albo wymuszenie sprawdzania sumy kontrolnej pliku Python lub DLL zawierającego ustawienie NSFW. Po zmianie ustawienia przez użytkownika renderowanie nie byłoby możliwe.
Ograniczyłoby to aplikację podobnie jak obecnie DALL-E 2, zmniejszając jej atrakcyjność komercyjną. W społeczności torrentowej i hakerskiej zapewne pojawiłyby się jednak zdekompilowane i zmodyfikowane wersje tych elementów, zarówno oryginalnych komponentów uruchomieniowych Pythona, jak i skompilowanych DLL, używanych obecnie w narzędziach Topaz do poprawiania obrazów AI. Wystarczyłoby zastąpić blokujące elementy i ominąć wymagania sum kontrolnych.
Ostatecznie dostawca może po prostu powtórzyć ostrzeżenie Stability.ai przed nadużyciami, pojawiające się przy pierwszym uruchomieniu wielu obecnych dystrybucji.
Mali twórcy open source stosujący takie swobodne zastrzeżenia mają jednak znacznie mniej do stracenia niż firma, która zainwestowała dużo czasu i pieniędzy w kompletny i przystępny produkt. To wymaga głębszego namysłu.
Odpowiedzialność za deepfake’i
Jak niedawno zauważyliśmy, baza LAION-aesthetics, będąca częścią 4,2 miliarda obrazów użytych do treningu rozwijanych modeli Stable Diffusion, zawiera wiele zdjęć celebrytów. Umożliwia to tworzenie deepfake’ów, w tym pornografii deepfake z celebrytami.

Z naszego ostatniego artykułu: Jennifer Connelly na czterech etapach kariery obejmujących cztery dekady, wygenerowana przez Stable Diffusion.
To odrębna i bardziej sporna kwestia niż generowanie zwykle legalnej pornografii abstrakcyjnej, która nie przedstawia prawdziwych ludzi, choć obrazy są wywodzone z wielu rzeczywistych zdjęć w materiale treningowym.
Coraz więcej stanów USA i państw opracowuje lub wprowadziło przepisy przeciw pornografii deepfake. Zdolność Stable Diffusion do tworzenia pornografii z celebrytami może więc oznaczać, że aplikacja komercyjna, która nie jest całkowicie ocenzurowana i może tworzyć pornografię, nadal potrzebuje filtrowania rozpoznanych twarzy celebrytów.
Jedna metoda to wbudowana lista blokowanych słów w promptach, dotyczących nazwisk celebrytów i powiązanych postaci fikcyjnych. Zapewne wymagałoby to obsługi więcej niż angielskiego, bo dane źródłowe obejmują inne języki. Inne podejście to rozpoznawanie celebrytów, na przykład systemami Clarifai.
Producenci mogą potrzebować takich metod, być może początkowo wyłączonych, aby pomóc zapobiec generowaniu twarzy celebrytów przez pełną samodzielną aplikację Stable Diffusion do czasu nowych przepisów, które mogłyby uznać tę funkcję za nielegalną.
I te zabezpieczenia zapewne dałoby się zdekompilować i odwrócić. Producent mógłby jednak uznać to za nieautoryzowany wandalizm, o ile taka inżynieria wsteczna nie byłaby nadmiernie ułatwiona.
Funkcje, które mogłyby się znaleźć w aplikacji
Od każdej dobrze finansowanej aplikacji komercyjnej należałoby oczekiwać podstawowych funkcji wszystkich dystrybucji Stable Diffusion. Obejmują one tworzenie odpowiednich obrazów z promptów tekstowych (tekst na obraz); użycie szkiców lub innych obrazów jako wskazówek dla nowych obrazów (obraz na obraz); regulację wyobraźni systemu; wybór między czasem renderowania a jakością; oraz podstawy takie jak opcjonalna automatyczna archiwizacja obrazów i promptów, rutynowe opcjonalne zwiększanie rozdzielczości przez RealESRGAN i przynajmniej podstawowe poprawianie twarzy przy użyciu GFPGAN lub CodeFormer.
To dość podstawowa instalacja. Przyjrzyjmy się bardziej zaawansowanym funkcjom, obecnie rozwijanym lub rozbudowywanym, które mogłyby wejść do kompletnej tradycyjnej aplikacji Stable Diffusion.
Zamrażanie stochastyczne
Nawet jeśli ponownie użyjesz ziarna z wcześniejszego udanego renderowania, bardzo trudno skłonić Stable Diffusion do dokładnego powtórzenia przekształcenia, jeżeli jakakolwiek część promptu lub obrazu źródłowego, bądź obu, zmieni się przy następnym renderowaniu.
To problem, jeśli chcesz użyć EbSynth do przeniesienia przekształceń Stable Diffusion na prawdziwy film w sposób spójny w czasie. Technika może być jednak bardzo skuteczna przy prostych ujęciach głowy i ramion:
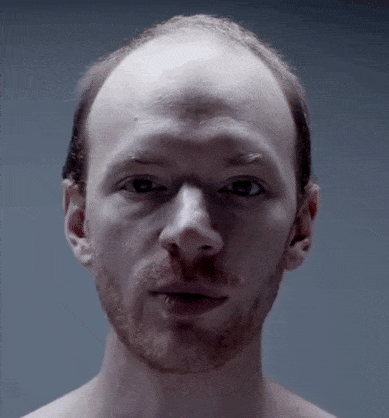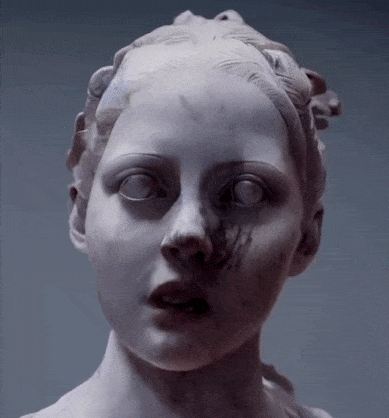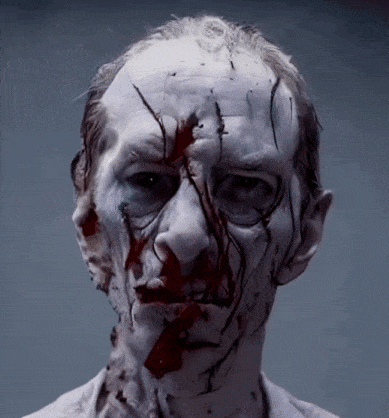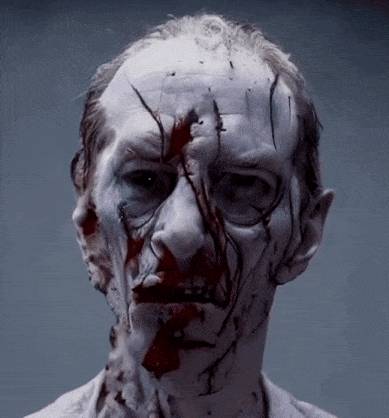
Ograniczony ruch może sprawić, że EbSynth skutecznie przełoży przekształcenia Stable Diffusion na realistyczny film. Źródło: https://streamable.com/u0pgzd
EbSynth ekstrapoluje niewielki wybór zmienionych klatek kluczowych na film wyeksportowany do serii plików graficznych. Później można je ponownie złożyć w film.

W przykładzie ze strony EbSynth kilka klatek filmu pomalowano w artystyczny sposób. Program używa ich jako wzorców stylu, by podobnie zmienić cały film i nadać mu malarski wygląd. Źródło: https://www.youtube.com/embed/eghGQtQhY38
W poniższym przykładzie prawdziwa blond instruktorka jogi po lewej niemal się nie porusza. Mimo to Stable Diffusion ma trudność z zachowaniem tej samej twarzy, bo trzy obrazy przekształcane w klatki kluczowe nie są całkowicie identyczne, choć używają tego samego ziarna liczbowego.

Nawet przy tym samym prompcie i ziarnie we wszystkich trzech przekształceniach oraz niewielkich zmianach klatek źródłowych mięśnie zmieniają rozmiar i kształt. Co ważniejsze, twarz jest niespójna, utrudniając ciągłość czasową w możliwym renderowaniu EbSynth.
Film SD/EbSynth poniżej jest pomysłowy: palce użytkownika zamieniają się odpowiednio w parę idących nóg w spodniach i kaczkę. Zmienność spodni ilustruje jednak problem Stable Diffusion z ciągłością między klatkami kluczowymi, nawet gdy obrazy źródłowe są podobne, a ziarno niezmienne.
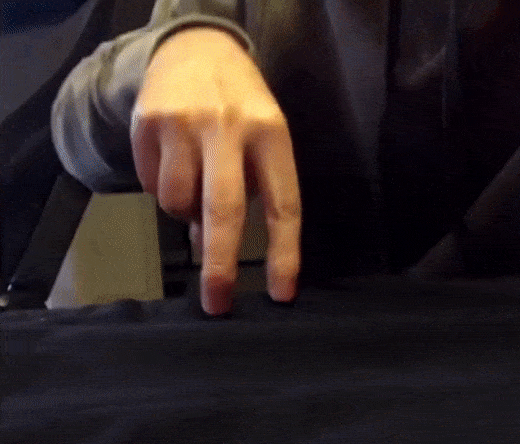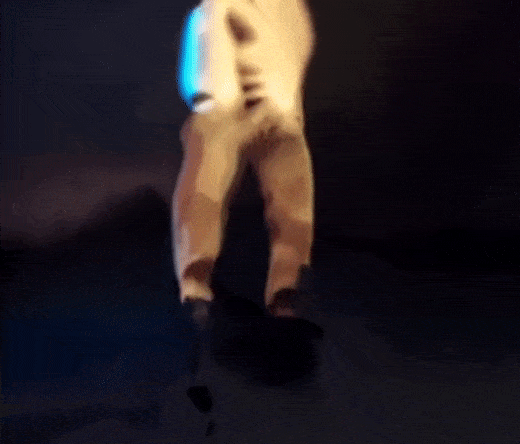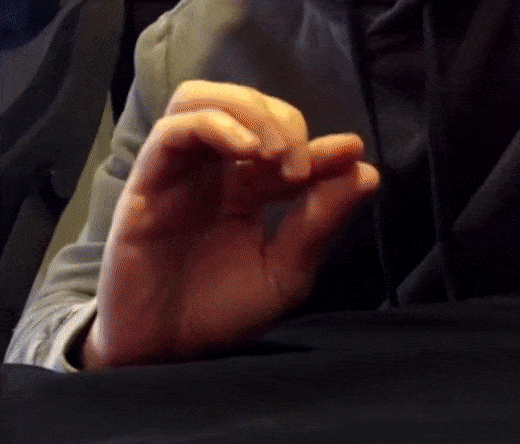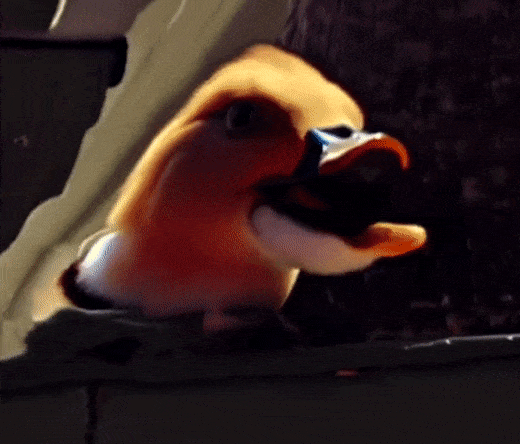
Palce mężczyzny zamieniają się w idącego człowieka i kaczkę dzięki Stable Diffusion oraz EbSynth. Źródło: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
Autor filmu skomentował, że przemiana w kaczkę, zapewne bardziej udana, choć mniej efektowna i oryginalna, wymagała tylko jednej przekształconej klatki kluczowej. Idące spodnie wymagały natomiast wyrenderowania 50 obrazów Stable Diffusion i wykazują większą niespójność czasową. Autor dodał, że osiągnięcie spójności każdej z 50 klatek wymagało pięciu prób.
Kompletna aplikacja Stable Diffusion bardzo skorzystałaby więc na funkcji zachowującej cechy między klatkami kluczowymi w maksymalnym stopniu.
Jedna możliwość to zamrożenie kodowania stochastycznego przekształcenia każdej klatki. Obecnie wymaga to ręcznej zmiany kodu źródłowego. Jak pokazuje przykład poniżej, pomaga to w ciągłości czasowej, ale nie rozwiązuje problemu całkowicie:
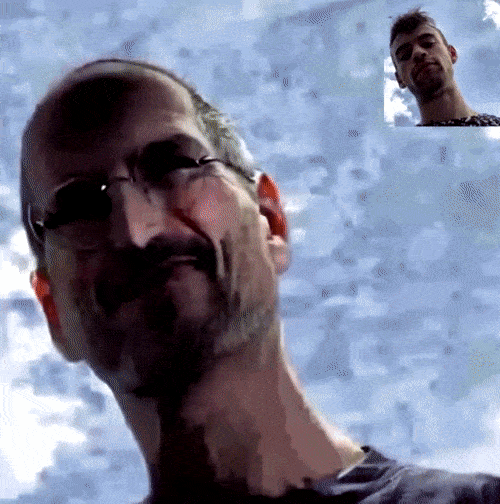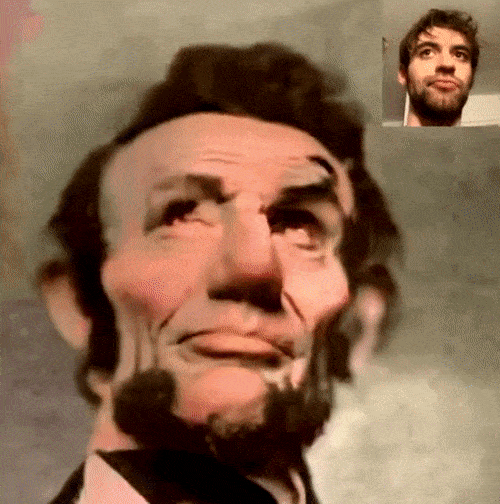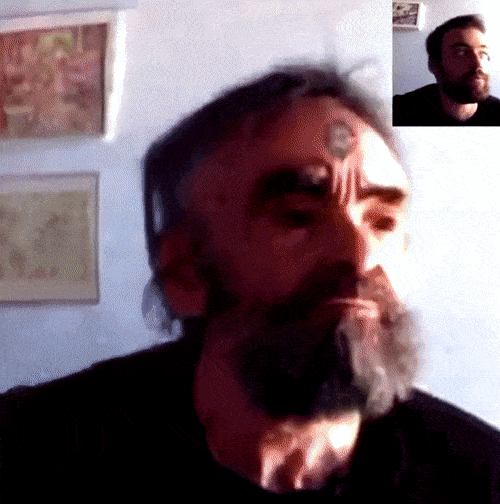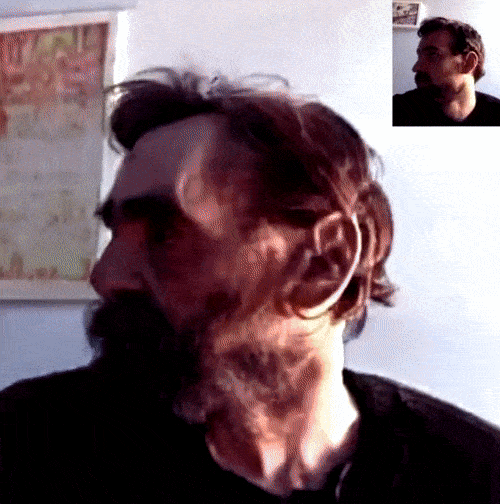
Użytkownik Reddita przekształcił nagranie z własnej kamery w różne znane osoby, zachowując nie tylko ziarno, co potrafi każda implementacja Stable Diffusion, ale też identyczny parametr stochastic_encode() w każdej transformacji. Wymagało to zmiany kodu, ale łatwo mogłoby stać się przełącznikiem dla użytkownika. Nie rozwiązuje jednak wszystkich problemów czasowych. Źródło: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
Inwersja tekstowa w chmurze
Lepszym sposobem uzyskania postaci i obiektów spójnych w czasie jest utrwalenie ich w inwersji tekstowej — pliku o rozmiarze 5 KB, który można wytrenować w kilka godzin na zaledwie pięciu opisanych obrazach, a potem przywołać specjalnym promptem *. Umożliwia to na przykład zachowanie wyglądu nowych postaci w narracji.

Obrazy z odpowiednimi tagami można przekształcić w odrębne byty przez inwersję tekstową i przywoływać jednoznacznie, we właściwym kontekście i stylu, za pomocą specjalnych słów-tokenów. Źródło: https://huggingface.co/docs/diffusers/training/text_inversion
Inwersje tekstowe są dodatkowymi plikami do bardzo dużego, wytrenowanego modelu Stable Diffusion. Włącza się je w proces generowania i obsługi promptów, aby mogły uczestniczyć w scenach tworzonych przez model i korzystać z jego ogromnej wiedzy o obiektach, stylach, otoczeniu i interakcjach.
Choć trening inwersji tekstowej nie trwa długo, wymaga dużo VRAM. Różne aktualne poradniki podają 12, 20, a nawet 40 GB.
Większość zwykłych użytkowników prawdopodobnie nie ma tak potężnego GPU, dlatego pojawiają się usługi chmurowe wykonujące tę operację, w tym wersja Hugging Face. Istnieją wprawdzie implementacje Google Colab tworzące inwersje tekstowe dla Stable Diffusion, lecz wymagania pamięci i czasu mogą być trudne do spełnienia dla użytkowników darmowego Colaba.
Dla potencjalnej kompletnej i dobrze finansowanej instalowanej aplikacji Stable Diffusion przekazanie tego ciężkiego zadania serwerom firmy wydaje się oczywistą strategią zarabiania. Zakłada to, że tani lub darmowy program zawiera takie płatne funkcje, co wydaje się prawdopodobne w wielu aplikacjach, które mogą wyrosnąć z tej technologii w ciągu najbliższych 6–9 miesięcy.
Dość skomplikowane opisywanie i formatowanie przesłanych obrazów i tekstów mogłoby też skorzystać z automatyzacji w zintegrowanym środowisku. Tworzenie unikatowych elementów, które mogą badać rozległe światy Stable Diffusion i wchodzić z nimi w interakcje, mogłoby silnie wciągać zarówno entuzjastów, jak i młodszych użytkowników.
Wszechstronne ważenie promptów
Wiele obecnych implementacji pozwala mocniej zaakcentować część długiego promptu, ale narzędzia bardzo się różnią i często są niezgrabne lub nieintuicyjne.
Na przykład popularne rozwidlenie Stable Diffusion autorstwa AUTOMATIC1111 może obniżyć lub podwyższyć wagę słowa przez ujęcie go w pojedyncze lub wielokrotne nawiasy okrągłe dla osłabienia albo w kwadratowe dla wzmocnienia.

Nawiasy kwadratowe i okrągłe mogą odmienić śniadanie w tej wersji ważenia promptów Stable Diffusion, ale tak czy inaczej to koszmar cholesterolowy.
Inne wersje Stable Diffusion używają wykrzykników do podkreślania znaczenia. Najbardziej wszechstronne pozwalają nadawać wagi każdemu słowu przez GUI.
System powinien też umożliwiać ujemne wagi promptów — nie tylko dla fanów horroru, lecz dlatego, że w przestrzeni ukrytej Stable Diffusion mogą kryć się mniej niepokojące i bardziej pouczające tajemnice niż te, które potrafi przywołać nasz ograniczony język.
Rozszerzanie obrazu, czyli outpainting
Niedługo po sensacyjnym udostępnieniu kodu Stable Diffusion OpenAI próbowało, w dużej mierze bezskutecznie, odzyskać część uwagi dla DALL-E 2, ogłaszając outpainting. Funkcja pozwala rozszerzyć obraz poza granice z zachowaniem logiki semantycznej i spójności wizualnej.
Naturalnie została już zaimplementowana w różnych formach dla Stable Diffusion oraz w Kricie i zdecydowanie powinna znaleźć się w kompletnej wersji Stable Diffusion na wzór Photoshopa.
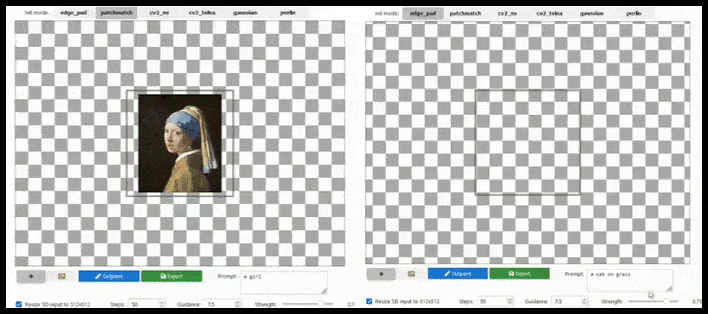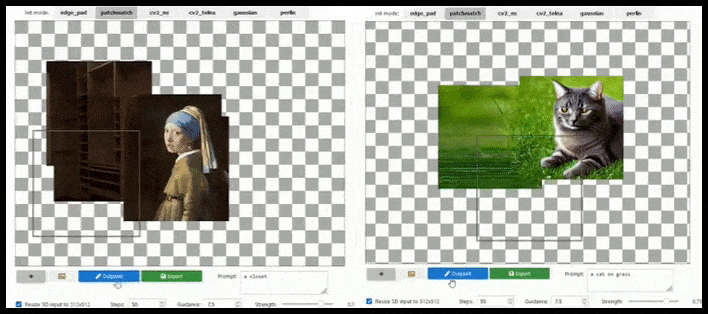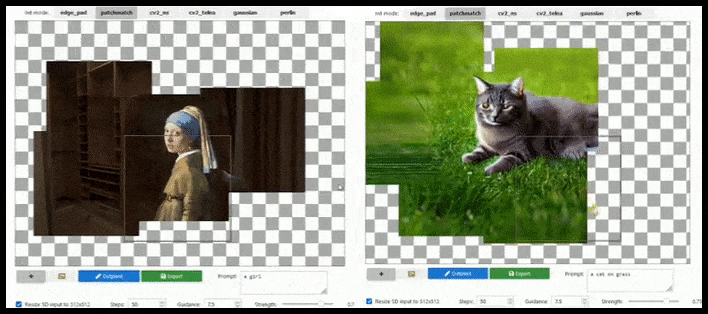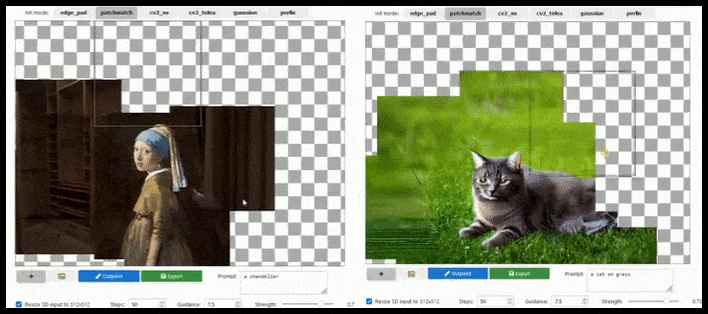
Rozbudowa oparta na kafelkach może rozszerzyć standardowy obraz 512 × 512 pikseli niemal bez końca, o ile pozwalają na to prompty, istniejący obraz i logika semantyczna. Źródło: https://github.com/lkwq007/stablediffusion-infinity
Ponieważ Stable Diffusion trenowano na obrazach 512 × 512 pikseli, a także z innych powodów, często ucina ludziom głowy lub inne istotne części ciała, nawet gdy prompt wyraźnie podkreśla głowę.

Typowe przykłady ucinania głów w Stable Diffusion; outpainting mógłby jednak przywrócić George’a do obrazu.
Każda implementacja outpaintingu podobna do animacji powyżej powinna też oferować rozwiązanie tego problemu jednym kliknięciem lub promptem. Choć przykład opiera się wyłącznie na bibliotekach Uniksa, powinien dać się odtworzyć w Windows.
Obecnie użytkownicy rozszerzają płótno obrazów bez głowy w górę, z grubsza wypełniają obszar głowy i używają img2img do dokończenia nieudanej grafiki.
Skuteczne maskowanie rozumiejące kontekst
Maskowanie bywa w Stable Diffusion bardzo nieprzewidywalne, zależnie od wersji lub rozwidlenia. Nawet gdy da się narysować spójną maskę, zaznaczony obszar często zostaje wypełniony treścią nieuwzględniającą całego kontekstu obrazu.
Raz zamaskowałem rogówki na zdjęciu twarzy i podałem prompt niebieskie oczy do wypełnienia maski. Okazało się, że wyglądam, jakbym patrzył przez dwoje wyciętych ludzkich oczu na odległy obraz nieziemskiego wilka. Chyba mam szczęście, że nie był to Frank Sinatra.
Edycja semantyczna jest też możliwa przez identyfikację szumu, z którego powstał obraz. Pozwala to ingerować w określone elementy strukturalne bez naruszania reszty:

Zmiana jednego elementu obrazu bez tradycyjnego maskowania i bez modyfikowania sąsiedniej treści: identyfikuje się szum, z którego powstał obraz, i jego części odpowiadające obszarowi docelowemu. Źródło: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
Metoda opiera się na samplerze K-Diffusion.
Filtry semantyczne na błędy anatomiczne
Jak wspominaliśmy, Stable Diffusion często dodaje lub odejmuje kończyny, głównie z powodu problemów z danymi i niedoskonałych opisów obrazów treningowych.

Jak niesforne dziecko pokazujące język na szkolnym zdjęciu grupowym, biologiczne potworki Stable Diffusion nie zawsze od razu rzucają się w oczy. Możesz opublikować nowe arcydzieło AI na Instagramie, zanim zauważysz dodatkowe dłonie lub stopione kończyny.
Takie błędy trudno naprawić. Pełna aplikacja Stable Diffusion mogłaby więc zawierać rozpoznawanie anatomii z segmentacją semantyczną, oceniające, czy obraz ma poważne braki anatomiczne, jak powyżej. Odrzucałaby taki obraz i tworzyła nowy, zanim pokaże go użytkownikowi.

Gdyby użytkownicy zaakceptowali telemetrię, takie błędy można byłoby przesyłać anonimowo we wspólnym przedsięwzięciu uczenia federacyjnego, pomagając przyszłym modelom lepiej rozumieć logikę anatomii.
Automatyczna poprawa twarzy oparta na LAION
Jak zauważyłem we wcześniejszej analizie trzech rzeczy, które Stable Diffusion może poprawić w przyszłości, ulepszania twarzy w pierwszej generacji nie należy pozostawiać wyłącznie jakiejkolwiek wersji GFPGAN.
Poprawki GFPGAN są bardzo ogólne, często naruszają tożsamość przedstawionej osoby i działają wyłącznie na twarzy, która zwykle została źle wyrenderowana, bo nie otrzymała więcej czasu ani uwagi niż inne części obrazu.
Profesjonalny program powinien zatem rozpoznać twarz standardową i stosunkowo lekką biblioteką, taką jak YOLO, wykorzystać całą dostępną moc GPU do ponownego wyrenderowania jej i wmieszać poprawioną twarz w oryginalny obraz z pełnym kontekstem albo zapisać ją osobno do ręcznego złożenia. Obecnie to dość ręczna operacja.
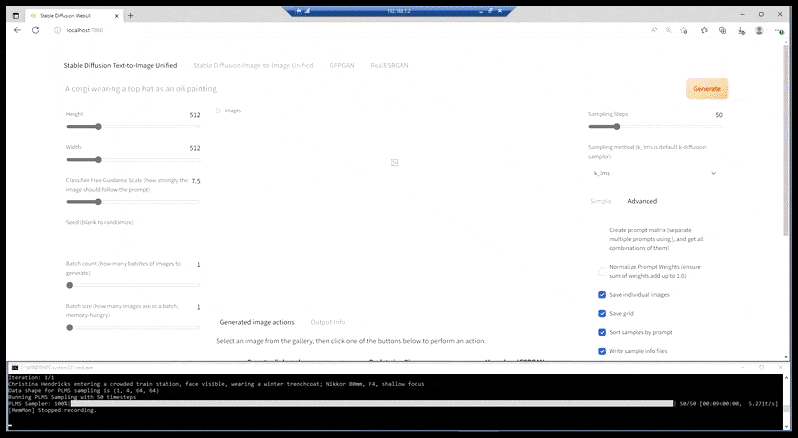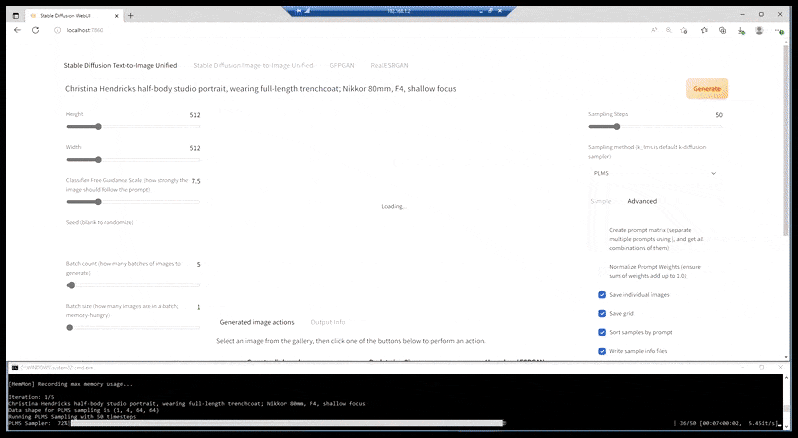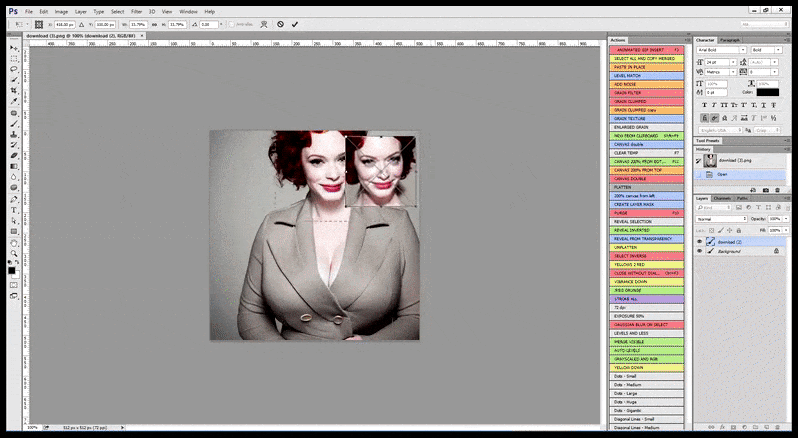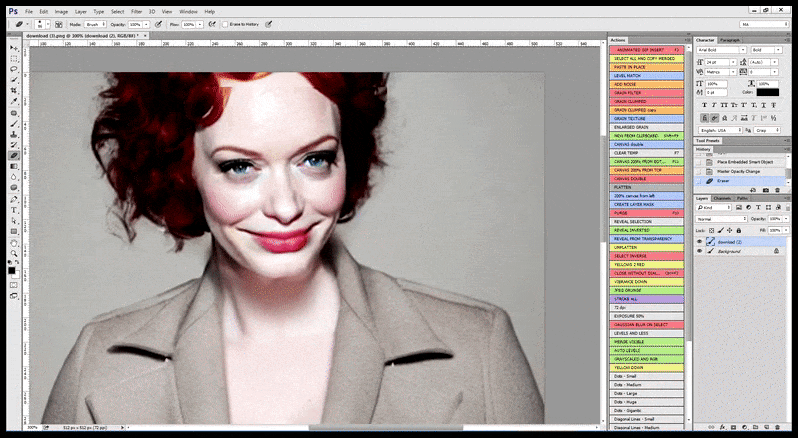
Jeśli Stable Diffusion trenowano na wystarczającej liczbie zdjęć celebryty, można skupić całą moc GPU na kolejnym renderowaniu wyłącznie twarzy. Zwykle daje to znaczną poprawę i, w przeciwieństwie do GFPGAN, korzysta z informacji uzyskanych z LAION, zamiast tylko zmieniać wygenerowane piksele.
Wyszukiwanie LAION w aplikacji
Odkąd użytkownicy odkryli, że wyszukiwanie pojęć, osób i tematów w LAION pomaga lepiej używać Stable Diffusion, powstało kilka internetowych eksploratorów, w tym haveibeentrained.com.

Wyszukiwanie na haveibeentrained.com pozwala badać obrazy zasilające Stable Diffusion i odkrywać, czy obiekty, osoby lub idee, które chce się przywołać, zapewne znalazły się w treningu. Takie systemy pomagają też znaleźć sąsiednie byty, na przykład grupy celebrytów lub następną ideę wynikającą z obecnej. Źródło: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
Choć internetowe bazy ujawniają część tagów obrazów, proces uogólniania zachodzący podczas treningu sprawia, że konkretnego obrazu raczej nie da się przywołać jego tagiem jako promptem.
Usuwanie słów stop oraz stemming i lematyzacja w przetwarzaniu języka naturalnego oznaczają też, że wiele widocznych fraz rozbito lub pominięto przed treningiem Stable Diffusion.
Jednak sposób łączenia grup estetycznych w tych interfejsach może nauczyć użytkownika wiele o logice lub osobowości Stable Diffusion i pomóc tworzyć lepsze obrazy.
Wnioski
Jest wiele innych funkcji, które chciałbym zobaczyć w pełnej natywnej aplikacji desktopowej Stable Diffusion. Przykładem jest wbudowana analiza obrazu oparta na CLIP, odwracająca standardowy proces i pozwalająca uzyskać frazy i słowa naturalnie kojarzone przez system z obrazem źródłowym lub wygenerowanym.
Prawdziwe zwiększanie rozdzielczości na kafelkach byłoby też mile widziane, bo ESRGAN jest niemal równie toporny jak GFPGAN. Na szczęście plany integracji txt2imghd, implementacji GOBIG, szybko urzeczywistniają to w dystrybucjach i wydają się oczywistym wyborem dla wersji desktopowej.
Inne popularne prośby z Discorda interesują mnie mniej, na przykład wbudowane słowniki promptów i listy artystów oraz stylów. Notatnik w aplikacji lub konfigurowalny leksykon fraz byłby jednak logicznym dodatkiem.
Animacja ludzi w Stable Diffusion nadal jest w powijakach, choć CogVideo i inne projekty dały jej impuls. Zależy od badań podstawowych nad czasową wiedzą a priori dotyczącą autentycznego ludzkiego ruchu.
Na razie filmy Stable Diffusion są ściśle psychodeliczne, ale niedaleka przyszłość może być jaśniejsza dla animowania deepfake’owych postaci przez EbSynth i inne młode inicjatywy tekst-na-wideo. Warto też zauważyć brak syntetycznych lub zmienionych ludzi w najnowszym filmie promocyjnym Runway.
Inną cenną funkcją byłby płynny przepływ obrazów do Photoshopa i z powrotem, od dawna obecny między innymi w edytorze tekstur Cinema4D. Pozwala to łatwo przesyłać obrazy między aplikacjami i wykorzystywać każdą do przekształceń, w których jest najlepsza.
Wreszcie, być może najważniejsze: pełny program desktopowy powinien nie tylko łatwo przełączać checkpointy, czyli wersje modelu bazowego, ale też aktualizować własne inwersje tekstowe, które działały z wcześniejszymi oficjalnymi modelami, a mogą przestać działać z późniejszymi. Taką możliwość wskazali twórcy na oficjalnym Discordzie.
Jak na ironię, Adobe, najlepiej przygotowane do zbudowania tak potężnego i zintegrowanego zestawu narzędzi, związało się tak silnie z Content Authenticity Initiative, że taki krok mógłby wyglądać na wizerunkowy regres firmy. Chyba że ograniczyłaby możliwości generowania tak gruntownie jak OpenAI w DALL-E 2 i przedstawiła je jako naturalny rozwój swojego dużego biznesu fotografii stockowej.
Pierwsza publikacja: 15 września 2022 r.


