
Podstawy AI
Modele generatywne vs. dyskryminacyjne w uczeniu maszynowym

 Dodaj Unite.AI do preferowanych źródeł w Google
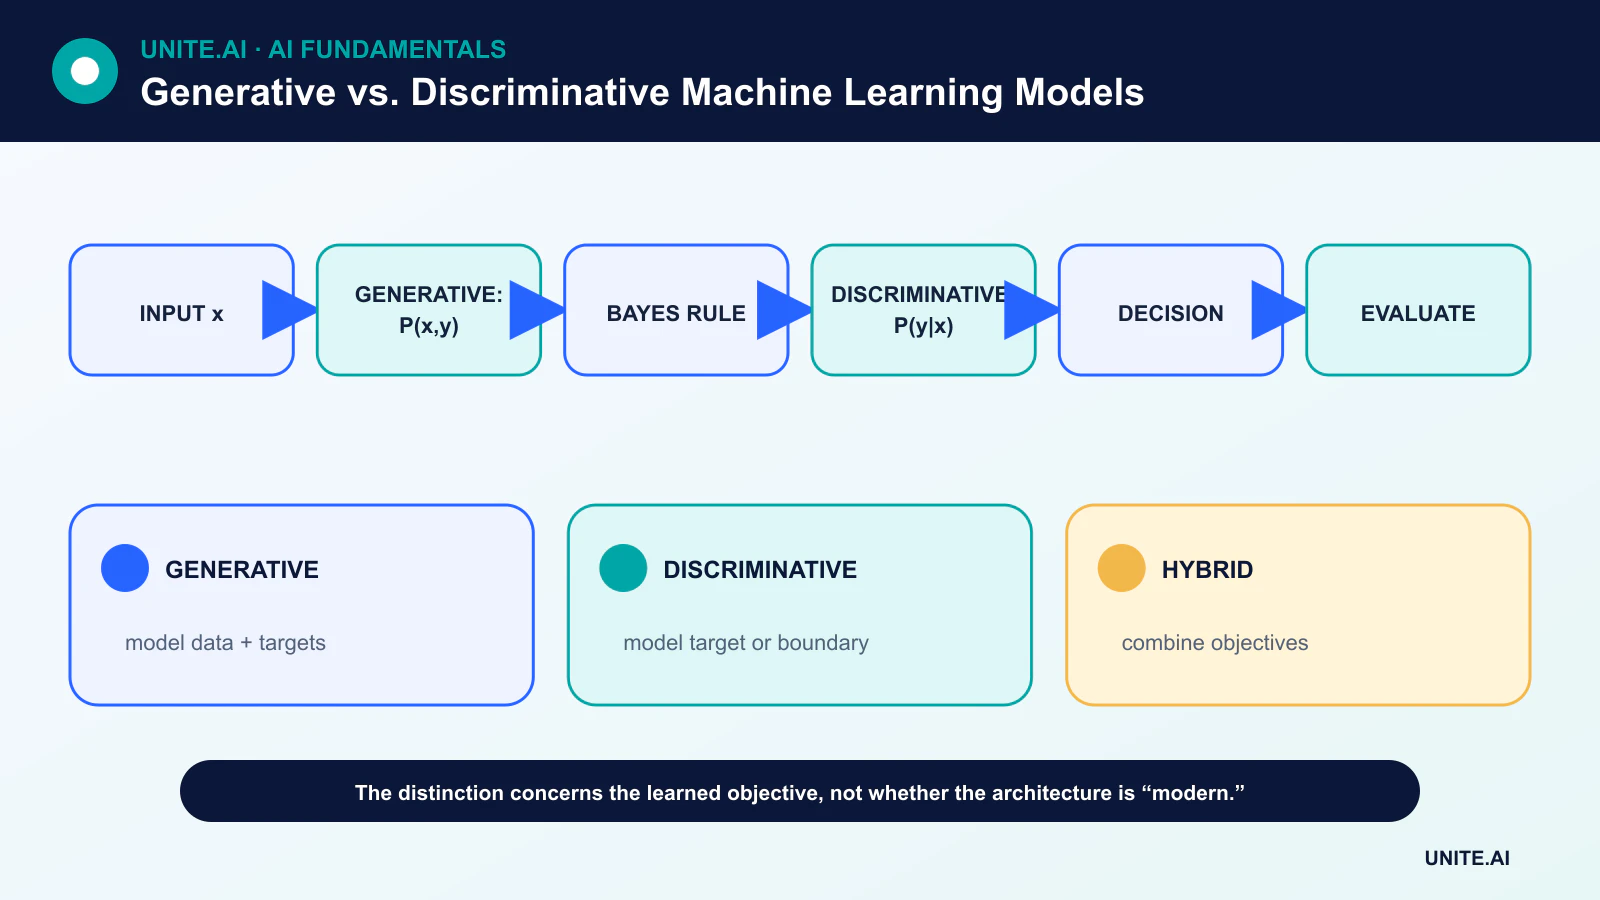
Generatywne i dyskryminacyjne opisują, czego model uczy się o danych i celach. W klasycznej nadzorowanej klasyfikacji model generatywny uczy się rozkładu łącznego, takiego jak P(x, y) lub rozkładu warunkowego klasy P(x|y), podczas gdy model dyskryminacyjny uczy się P(y|x) lub bezpośredniej granicy decyzyjnej.
Rozróżnienie jest przydatne, ale nowoczesne systemy często łączą cele. Model może nauczyć się reprezentacji generatywnych, a później być dostrojony do predykcji dyskryminacyjnej, lub współdzielić jedną architekturę pomiędzy generowaniem a klasyfikacją.
Kluczowe wnioski
- Klasyfikatory generatywne modelują, jak powstają dane wejściowe i etykiety; klasyfikatory dyskryminacyjne modelują etykietę w zależności od wejścia lub granicę decyzyjną.
- Założenia generatywne mogą pomóc przy ograniczonej liczbie oznakowanych danych, ale mogą też być błędne.
- Metody dyskryminacyjne często skupiają moc na zadaniu predykcji i mogą osiągać lepszy asymptotyczny błąd klasyfikacji.
- GAN-y, VAE-y i modele językowe są systemami generatywnymi, ale „generatywny” nie oznacza, że każdy komponent jest klasyfikatorem generatywnym.
Faktoryzacja prawdopodobieństwa
Klasyfikator generatywny może oszacować P(x|y) i P(y), a następnie użyć twierdzenia Bayesa, aby wyprowadzić P(y|x). Naiwny Bayes jest klasycznym przykładem. Klasyfikator dyskryminacyjny, taki jak regresja logistyczna, oszacowuje P(y|x) bezpośrednio; SVM uczy się granicy separującej.
Modelowanie P(x,y) jest szerszym zadaniem niż przewidywanie y na podstawie x. Dodatkowa struktura może wspierać próbkowanie lub wnioskowanie przy brakujących danych, ale wymaga również założeń dotyczących rozkładu wejściowego.
Wydajność danych i zachowanie asymptotyczne
Porównanie Ng i Jordana między naiwnym Bayesem a regresją logistyczną wykazało użyteczny kompromis: przy ich założeniach model generatywny może zbliżać się do swojej granicznej wydajności przy mniejszej liczbie przykładów, podczas gdy model dyskryminacyjny może osiągnąć niższy błąd asymptotyczny.
To nie jest uniwersalna hierarchia. Wyniki zależą od tego, czy rodzina modeli pasuje do danych, od wymiarowości, regularizacji, optymalizacji i jakości etykiet. Empiryczne porównanie na reprezentatywnym projekcie walidacji pozostaje niezbędne.
Reprezentatywne rodziny modeli
Modele generatywne obejmują rozkłady warunkowe klasy, ukryte modele Markowa, modele mieszane, wariacyjne autoenkodery, autoregresywne modele językowe, modele dyfuzyjne oraz GAN-y.
Modele dyskryminacyjne obejmują regresję logistyczną, drzewa decyzyjne, warunkowe pola losowe, maszyny wektorów nośnych oraz klasyfikatory neuronowe. Ta sama architektura neuronowa może uczestniczyć w obu kategoriach w zależności od celu treningowego i wyjścia.
Systemy hybrydowe i samonadzorowane
Wstępnie wytrenowany model językowy lub wizualny może uczyć się na nieoznakowanych danych przy użyciu celu generatywnego lub samonadzorowanego, a następnie otrzymać dyskryminacyjną głowicę dla zadania docelowego. Metody półnadzorowane mogą optymalizować klasyfikację oznakowaną oraz cel związany z danymi nieoznakowanymi jednocześnie.
Hybrydyzacja sprawia, że etykiety architektury są mniej informacyjne niż pełny proces treningowy. Dokumentacja powinna określać cel, dane, wyjścia i zamierzoną inferencję — nie wystarczy po prostu nazwać model generatywnym.
Wybór podejścia
Użyj zadania, aby podjąć decyzję. Jeśli celem jest skalibrowana granica przy obfitej liczbie etykiet, model dyskryminacyjny jest naturalną bazą. Jeśli kluczowe są próbkowanie, estymacja gęstości, struktura brakujących danych lub nieoznakowane dane, komponent generatywny może pomóc.
Porównaj odporność, efektywność próbkowania, moc obliczeniową, wiarygodność lub kalibrację w zależności od potrzeb. Dobre wygenerowane próbki nie dowodzą, że klasyfikator jest dobry, a klasyfikator o wysokiej dokładności nie oznacza realistycznego modelu rozkładu wejściowego.
Kierunki prawdopodobieństwa i cele modelowania
Model dyskryminacyjny uczy się granicy lub rozkładu warunkowego P(y|x): mając cechy x, przewiduje etykietę y. Regresja logistyczna, maszyny wektorów nośnych, warunkowe pola losowe i wiele klasyfikatorów są dyskryminacyjne. Model generatywny uczy się rozkładu łącznego P(x,y), rozkładu warunkowego klasy P(x|y) lub bezwarunkowego rozkładu danych, umożliwiając próbkowanie lub zadania związane z wiarygodnością. Naiwny Bayes i analiza dyskryminacji liniowej są klasyfikatorami generatywnymi; GAN-y, wariacyjne autoenkodery, modele dyfuzyjne i modele autoregresywne generują dane przy użyciu różnych celów.
Rozróżnienie dotyczy tego, jaki rozkład lub reguła decyzyjna jest modelowana, a nie tego, czy używa się sieci neuronowej. Generatywny model językowy może być wywołany do klasyfikacji, podczas gdy dyskryminacyjny reranker może kierować generacją. Założenia generatywne mogą poprawić efektywność danych lub obsłużyć brakujące zmienne, ale wprowadzają ryzyko niewłaściwej specyfikacji modelu. Metody dyskryminacyjne często radzą sobie lepiej przy obfitych danych oznakowanych, ponieważ koncentrują się bezpośrednio na granicy predykcji. Porównuj rodziny przy równych cechach, danych, strojeniach i mocy obliczeniowej, zamiast traktować jedną kategorię jako uniwersalnie lepszą.
Szkolenie i ocena w zależności od przypadku użycia
Ocena klasyfikacji wykorzystuje precyzję, czułość, kalibrację, odporność i koszt błędu. Ocena generatywna musi uwzględniać wierność, różnorodność, pokrycie, wiarygodność lub użyteczność zadania, zapamiętywanie oraz bezpieczeństwo. Model może generować atrakcyjne próbki, jednocześnie pomijając tryby, lub osiągać dobrą wiarygodność przy słabej jakości percepcyjnej. Przydatność danych syntetycznych powinna być testowana poprzez trenowanie i ocenę modeli downstream na niezależnych rzeczywistych danych, w tym na rzadkich grupach. Trzymaj dane testowe poza promptami generacji i selekcją.
W uczeniu półnadzorowanym model generatywny może wykorzystywać strukturę nieoznakowanych danych; w wykrywaniu anomalii wiarygodność może zawieść, gdy dane spoza rozkładu otrzymują wysoką gęstość z nieistotnych powodów. W generacji wspomaganej wyszukiwaniem model generatywny odpowiedzi i dyskryminacyjny wyszukiwacz lub reranker tworzą hybrydę. Diagnozuj etapy osobno, aby płynny wynik nie ukrywał niepowodzenia wyszukiwania. Wybierz dekompozycję, która umożliwia obserwację dowodów i kontroli.
Wdrożenie i zarządzanie
Systemy generatywne wprowadzają ryzyko pochodzenia treści, własności intelektualnej, podszywania się, wstrzykiwania promptów i moderacji wyjścia; systemy dyskryminacyjne dodają ryzyko progowego odrzutu, odmowy i nierównego błędu. Oba wymagają praw do danych, bezpiecznych artefaktów, wersjonowania, reprezentatywnych testów, monitorowania oraz ludzkiej władzy proporcjonalnej do konsekwencji. Dokumentuj dokładny cel i semantykę wyjścia. Rozróżnienie generatywne vs. dyskryminacyjne jest użytecznym podziałem statystycznym, ale rzeczywiste systemy często je łączą, a niezawodność zależy od całego przepływu danych i decyzji.
Przykład praktyczny: klasyfikacja i generowanie odpowiedzi wsparcia
Platforma wsparcia używa klasyfikatora dyskryminacyjnego do identyfikacji typu problemu i pilności oraz modelu generatywnego do przygotowania odpowiedzi na podstawie zatwierdzonych polityk. Klasyfikator jest oceniany przy użyciu czułości specyficznej dla klasy i kalibracji; wyszukiwacz – przy użyciu czułości dowodowej; generator – pod kątem uzasadnienia, poprawności i odmowy. Każdy etap ma nieznany wynik, a model generatywny nie może zmienić klasyfikacji ani uprawnień klienta poprzez perswazyjny tekst.
Agenci widzą przewidywaną ścieżkę, źródła oraz szkic i zatwierdzają lub korygują przed wysłaniem. Filtry uprawnień stosowane są przed wyszukiwaniem, a wstrzykiwanie promptów w tekście klienta nie może autoryzować narzędzi. Monitorowanie oddziela błędy routingu, luki w wyszukiwaniu, nieobsługiwane stwierdzenia i edycje agentów. Zmiana polityki natychmiast aktualizuje źródła i wyzwala testy regresji; strojenie zarezerwowane jest dla stabilnego zachowania. Projekt hybrydowy wykorzystuje mocne strony dyskryminacyjne i generatywne, jednocześnie zachowując dowody i ludzką władzę.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę i wersjonowany zestaw oceny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, przesunięcie rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najbardziej narażone na niedostateczną obsługę. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania. Stosuj etapowe wdrażanie, zachowaj bezpieczną rezerwę i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjścia, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych danych wrażliwych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline wydajność utrzyma się. Przeprowadzaj ponowną ocenę, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga również udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy dyskryminator GAN‑a jest modelem dyskryminacyjnym?
Wykonuje dyskryminację podczas treningu, ale cały GAN jest generatywnym frameworkiem, którego wyjście jest generowane przez generator.
Czy uczenie dyskryminacyjne jest zawsze nadzorowane?
Nie. Termin opisuje modelowaną relację lub granicę, natomiast nadzór opisuje sygnał treningowy. Współczesne cele mogą rozmywać te kategorie.
Podstawowe źródła












