
Kąt Andersona
GAN jako renderer twarzy dla tradycyjnego CGI

 Dodaj Unite.AI do preferowanych źródeł w Google

Kluczowe punktyOddzielenie tożsamości od ekspresji w przestrzeni latentnej GAN pozostaje głównym…
Zobacz więcej
- Oddzielenie tożsamości od ekspresji w przestrzeni latentnej GAN pozostaje głównym nierozwiązanym wyzwaniem syntezy wideo twarzy.
- Parametryczne modele CGI, takie jak SMPL i 3DMM, są coraz częściej używane do narzucania porządku na nieokiełznane kody latentne GAN-ów.
- Hybrydowe podejście Disneya Rendering with Style przyniosło niesamowite rezultaty poprzez połączenie tradycyjnych map tekstur z obrazami generowanymi przez GAN.
Opinia Kiedy generatywne sieci przeciwstawne (GAN) po raz pierwszy zademonstrowały swoją zdolność do odtworzenia oszałamiająco realistycznych twarzy 3D, ten przełom wywołał gorączkę złota w poszukiwaniu niewykorzystanego potencjału GAN do tworzenia spójnych w czasie filmów wideo z ludzkimi twarzami.
Gdzieś w przestrzeni latentnej GAN wydawało się, że musi istnieć ukryty porządek i racjonalność – schemat rodzącej się logiki semantycznej, zakopanej w kodach latentnych, które pozwolą GAN generować spójne, wielokrotne widoki i interpretacje (takie jak zmiany wyrazu) tej samej twarzy – i tym samym zapewnić przekonującą w czasie metodę tworzenia wideo deepfake, która wyeliminuje autoencodery z gry.
Wysokiej rozdzielczości dane wyjściowe byłyby trywialne w porównaniu z ubogimi środowiskami niskiej rozdzielczości, w których ograniczenia GPU zmuszają DeepFaceLab i FaceSwap do pracy, podczas gdy “strefa wymiany” twarzy (w przepływach pracy autoencoderów) stanie się “strefą tworzenia” GAN, poinformowaną o kilku obrazach wejściowych lub nawet tylko jednym obrazie.
Nie będzie już niezgodności między “wymianą” a “gospodarzem” twarzy, ponieważ całość obrazu będzie generowana od podstaw, w tym włosy, linie szczęki i zewnętrzne krańce rysów twarzy, które często okazują się wyzwaniem dla “tradycyjnych” autoencoderów deepfake.
Zima GAN w wideo twarzy
Jak się okazało, nie było to takie proste. Ostatecznie rozłączanie okazało się głównym problemem i nadal pozostaje największym wyzwaniem. Jak można utrzymać odrębną tożsamość twarzy i zmienić jej pozę lub wyraz bez zebrania tysięcy obrazów referencyjnych, które nauczą sieci neuronowej, co się dzieje, gdy te zmiany są wprowadzane, tak jak to robią systemy autoencoderowe?
Późniejsze myślenie w badaniach nad GAN i syntezą twarzy było takie, że tożsamość wejściowa mogłaby być poddana teleologicznym, ogólnym, schematycznym transformacjom, które nie są specyficzne dla tożsamości. Przykładem tego mogłoby być zastosowanie wyrazu twarzy do twarzy GAN, który nie był obecny w żadnym z obrazów tej osoby, które GAN zna.

Z 2022 roku, z artykułu Tensor-based Emotion Editing in the StyleGAN Latent Space, schematyczne wyrazy są stosowane do twarzy wejściowej z zestawu danych FFHQ. Źródło: https://arxiv.org/pdf/2205.06102.pdf
Jest oczywiste, że podejście “jedna wielkość pasuje do wszystkiego” nie może objąć różnorodności wyrazów twarzy unikalnych dla jednostki. Musimy się zastanowić, czy uśmiech tak unikalny jak u Jacka Nicholsona lub Willem Dafoe mógłby kiedykolwiek otrzymać wierną interpretację pod wpływem takich “średnich wyrazów” kodów latentnych.

Kim jest ten uroczy latynoski nieznajomy? Chociaż metoda GAN produkuje bardziej “realistyczną” i wyższej rozdzielczości twarz, transformacja nie jest poinformowana przez wiele obrazów rzeczywistych aktora, tak jak to ma miejsce w przypadku DeepFaceLab, który trenuje intensywnie na bazie tysięcy takich obrazów, i w związku z tym podobieństwo jest naruszone. Tutaj (w tle) model DeepFaceLab jest importowany do DeepFaceLive, implementacji strumieniowej popularnego i kontrowersyjnego oprogramowania. Przykłady pochodzą z https://www.youtube.com/watch?v=9tr35y-yQRY (2022) i https://arxiv.org/pdf/2205.06102.pdf.
Wiele edytorów wyrazów twarzy GAN zostało przedstawionych w ciągu ostatnich kilku lat, z których większość dotyczy nieznanych tożsamości, gdzie wierność transformacji jest niemożliwa do ustalenia przez przeciętnego czytelnika, ponieważ są to nieznane twarze.

Nieznane tożsamości przekształcone w 2020 roku w Cascade-EF-GAN. Źródło: https://arxiv.org/pdf/2003.05905.pdf
Być może edytorem twarzy GAN, który w ostatnich trzech latach przyciągnął najwięcej uwagi i cytowań, jest InterFaceGAN, który może wykonywać przejścia w przestrzeni latentnej, odnoszące się do pozy (kąta kamery/twarzy), wyrazu, wieku, rasy, płci i innych istotnych cech.
Możliwości “morfowania” z lat 80. InterFaceGAN i podobnych ram są głównie sposobem ilustracji drogi do transformacji jako obraz jest reprojektowany z powrotem przez odpowiedni kod latentny (taki jak “wiek”). Jednak pod względem tworzenia materiału wideo z ciągłością czasową takie metody pozostawały dotąd „imponującymi katastrofami”.
Jeśli dodamy do tego trudność tworzenia czasowo spójnych włosów, oraz fakt, że technika eksploracji/manipulacji kodami latentnymi nie ma wewnętrznych wytycznych czasowych, z którymi mogłaby pracować (i trudno jest wiedzieć, jak wstrzyknąć takie wytyczne do ramy zaprojektowanej do generowania obrazów statycznych, i która nie ma rodzimej obsługi dla danych wideo), można by logicznie wnioskować, że GAN nie jest wszystkim, czego potrzebujesz™ do syntezy wideo twarzy.
Dlatego późniejsze wysiłki doprowadziły do stopniowych ulepszeń w rozłączaniu, podczas gdy inni dodali inne konwencje z dziedziny widzenia komputerowego jako “warstwę sterującą”, taką jak użycie segmentacji semantycznej jako mechanizmu kontrolnego w późnym 2021 roku artykule SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing.
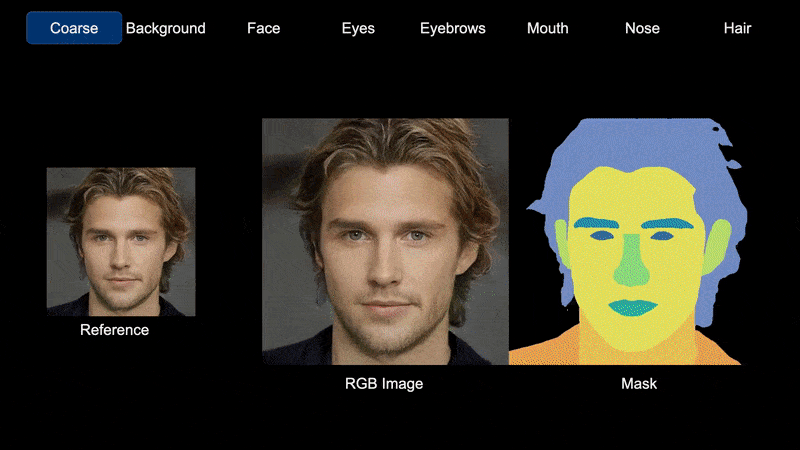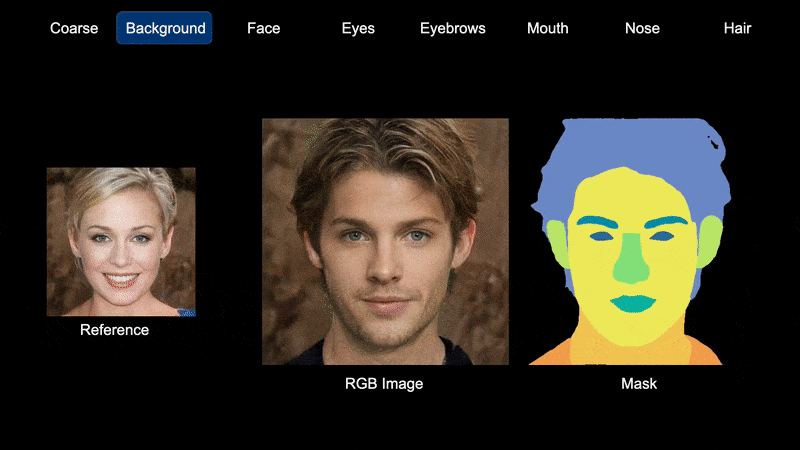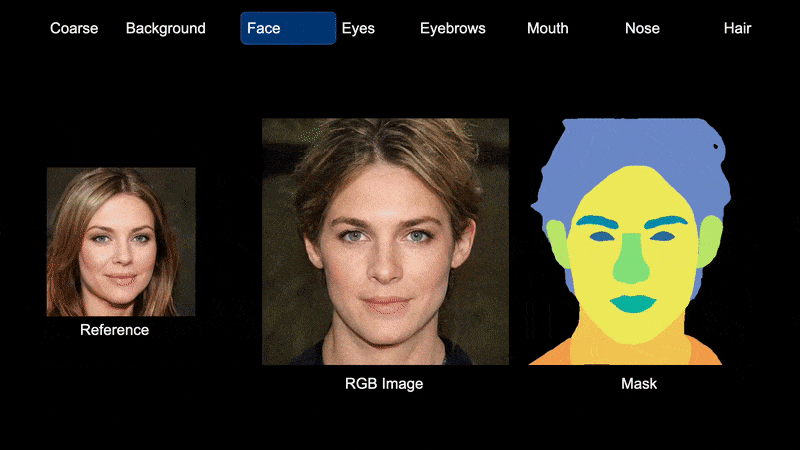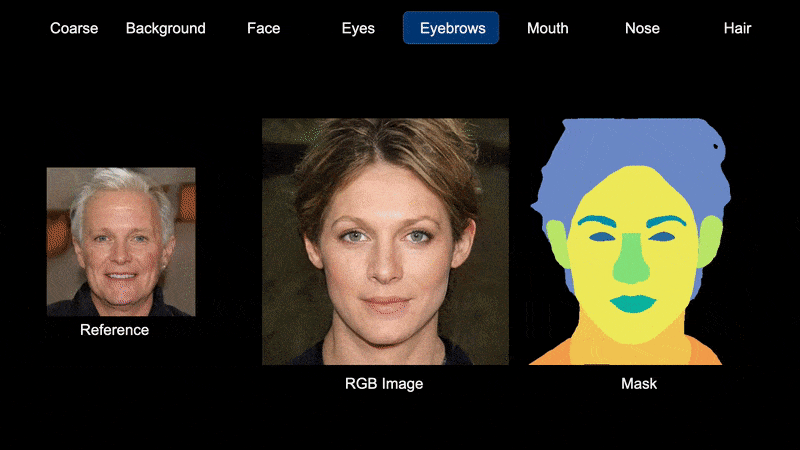
Segmentacja semantyczna jako metoda instrumentacji przestrzeni latentnej w SemanticStyleGAN. Źródło: https://semanticstylegan.github.io/
Parametryczne sterowanie
Społeczność badawcza GAN twarzy jest coraz bardziej skłonna do korzystania z “tradycyjnych” parametrycznych twarzy CGI jako metody sterowania i nadania porządku imponującym, ale nieposłusznym kodom latentnym w przestrzeni GAN.
Chociaż parametryczne prymitywy twarzy były podstawą badań nad widzeniem komputerowym przez ponad dwadzieścia lat, zainteresowanie tym podejściem wzrosło ostatnio, zwłaszcza ze wzrostem użycia Skinned Multi-Person Linear Model (SMPL) prymitywów CGI, podejście zapoczątkowane przez Max Planck Institute i ILM, oraz później udoskonalone za pomocą Sparse Trained Articulated Human Body Regressor (STAR) framework.

SMPL (w tym przypadku wariant SMPL-X) może narzucić siatkę parametryczną CGI, która zgadza się z oszacowaną pozycją (w tym wyrazem, jeśli jest to konieczne) całej ludzkiej postaci na obrazie, umożliwiając wykonanie nowych operacji na obrazie przy użyciu siatki parametrycznej jako wolumetrycznej lub percepcyjnej wytycznej. Źródło: https://arxiv.org/pdf/1904.05866.pdf
Najbardziej wyróżniający się rozwój w tym kierunku miał miejsce w 2019 roku w ramach inicjatywy Rendering with Style Disneya, który połączył użycie tradycyjnych map tekstur z generowanymi obrazami GAN, w celu stworzenia lepszych animowanych rezultatów w stylu deepfake.

Stare spotyka nowe w hybrydowym podejściu Disneya do generowanych przez GAN deepfake. Źródło: https://www.youtube.com/watch?v=TwpLqTmvqVk
Podejście Disneya narzuca tradycyjnie renderowane elementy CGI do sieci StyleGAN2, aby “wypełnić” ludzkie twarze w “problemowych” obszarach, gdzie spójność czasowa jest problemem dla generowania wideo – obszarach takich jak tekstura skóry.

Przepływ pracy Rendering with Style.
Ponieważ parametryczna głowa CGI, która steruje tym procesem, może być dostosowana i zmieniona zgodnie z potrzebami użytkownika, twarz generowana przez GAN może odzwierciedlać te zmiany, w tym zmiany pozy i wyrazu.
Chociaż zaprojektowane, aby połączyć instrumentację CGI z naturalnym realizmem twarzy GAN, ostatecznie wyniki demonstrują najgorsze cechy obu światów i nadal nie są w stanie utrzymać spójności włosów i nawet podstawowego umiejscowienia cech.
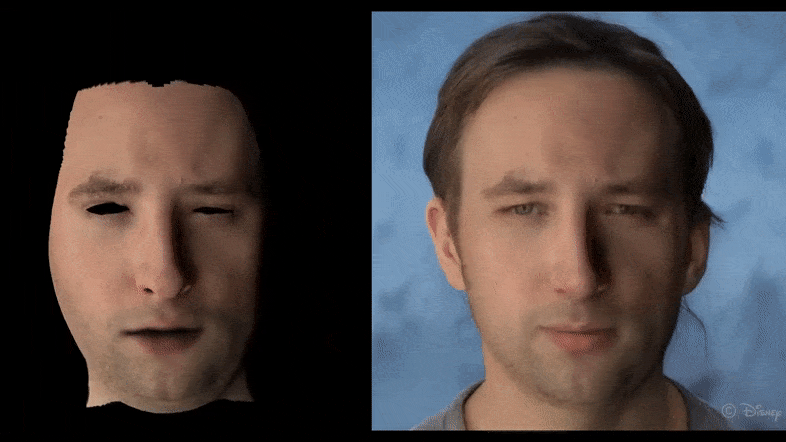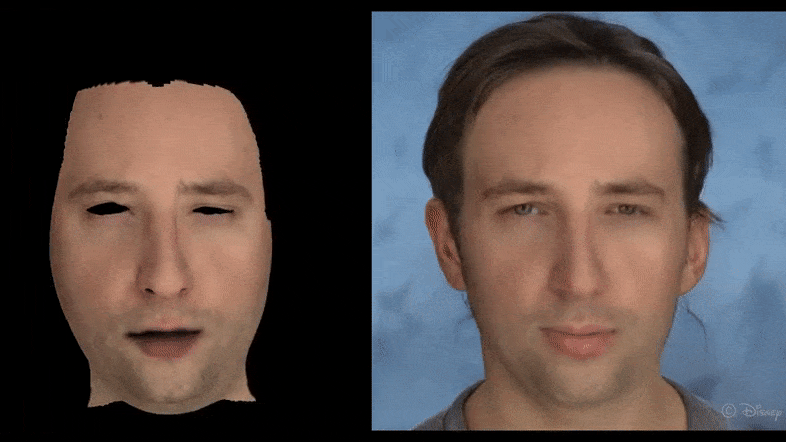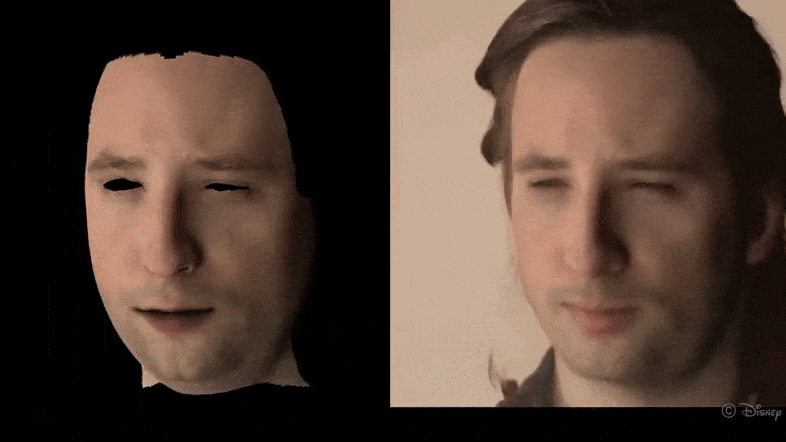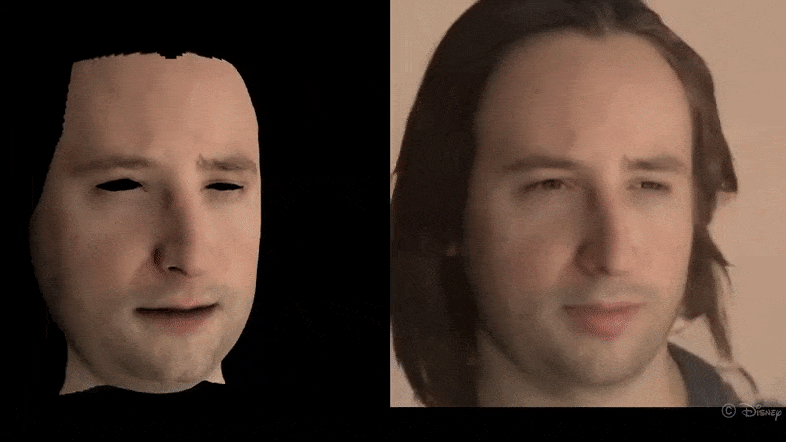
Nowy rodzaj doliny niesamowitości pojawia się z Rendering with Style, chociaż zasada nadal ma pewne możliwości.
Artykuł z 2020 roku StyleRig: Rigging StyleGAN for 3D Control over Portrait Images stosuje coraz bardziej popularne podejście, z użyciem trójwymiarowych deformowalnych modeli twarzy (3DMM) jako proxy do zmiany cech w środowisku StyleGAN, w tym przypadku za pomocą nowej sieci riggingowej zwanej RigNet:

3DMM służą jako proxy do interpretacji przestrzeni latentnej w StyleRig. Źródło: https://arxiv.org/pdf/2004.00121.pdf
Jednak, jak zwykle w przypadku tych inicjatyw, wyniki na razie wydają się ograniczone do minimalnych manipulacji pozy i “niepoinformowanych” zmian wyrazu/afektu.

StyleRig poprawia poziom kontroli, chociaż spójne w czasie włosy nadal pozostają nierozwiązanym wyzwaniem. Źródło: https://www.youtube.com/watch?v=eaW_P85wQ9k
Podobne wyniki można znaleźć w MOST-GAN, Mitsubishi Research, z 2021 roku artykułu, który wykorzystuje nieliniowe 3DMM jako architekturę rozłączania, ale który również zmagają się z osiągnięciem dynamicznego i spójnego ruchu.
Najnowsze badania, które próbują osiągnąć instrumentację i rozłączanie, to One-Shot Face Reenactment on Megapixels, które ponownie wykorzystują parametryczne głowy 3DMM jako przyjazny interfejs dla StyleGAN.

W przepływie pracy MegaFR One-Shot Face Reenactment, sieć wykonuje syntezę twarzy, łącząc rzeczywisty obraz odwzorowany do reprezentacji latentnej z parametrami pobranymi z wyrenderowanego modelu 3DMM. Źródło: https://arxiv.org/pdf/2205.13368.pdf
OSFR należy do rosnącej klasy edytorów twarzy GAN, które próbują rozwijać liniowe przepływy edycyjne w stylu Photoshop/After Effects, gdzie użytkownik może wprowadzić pożądany obraz, na którym można wykonać transformacje, zamiast szukać w przestrzeni latentnej kodów latentnych związanych z tożsamością.
Ponownie, parametryczne wyrazy reprezentują ogólny, nieosobisty sposób wstrzyknięcia wyrazu, prowadząc do manipulacji, które wydają się niesamowite i niepokojące na swój własny, nie zawsze pozytywny sposób.

Wstrzyknięte wyrazy w OSFR.
Jak i poprzednie prace, OSFR może wywnioskować prawie oryginalne pozy z jednego obrazu i również wykonać “frontalizację”, gdzie obraz z pozycji bocznej jest przekształcany w zdjęcie portretowe:

Oryginalne (powyżej) i inferowane zdjęcia portretowe z jednej z implementacji OSFR opisanych w nowym artykule.
W praktyce, ten rodzaj inferencji jest podobny do niektórych zasad fotogrametrii, które leżą u podstaw Neural Radiance Fields (NeRF), z wyjątkiem, że geometria tutaj musi być określona przez jeden zdjęcie, a nie 3-4 punkty widzenia, które pozwalają NeRF na interpretację brakujących pozy i tworzenie eksplorowalnych neuralowych scen 3D z ludźmi.
(Jednak NeRF nie jest wszystkim, czego potrzebujesz™, ponieważ ma prawie całkowicie inny zestaw przeszkód do GAN w kwestii produkcji syntezy wideo twarzy)
Czy GAN ma miejsce w syntezie wideo twarzy?
Osiągnięcie dynamicznych wyrazów twarzy i póz spoza rozkładu treningowego na podstawie jednego obrazu źródłowego wydaje się być rodzajem alchemiczną obsesją w badaniach nad syntezą twarzy GAN, głównie dlatego, że GAN są jedyną metodą, która może wyprowadzić dość wysokiej rozdzielczości i względnie wysokiej wierności twarze neuronowe: chociaż ramy deepfake autoencoderowe mogą trenować na wielu rzeczywistych pozach i wyrazach, muszą one działać w ograniczonym przez VRAM rozdzielczości wejścia/wyjścia i wymagają “gospodarza”; NeRF jest podobnie ograniczony i – w przeciwieństwie do dwóch pozostałych podejść – nie ma jeszcze ustalonych metodologii do zmiany wyrazów twarzy i ma ograniczoną edytowalność w ogóle.
Wydaje się, że jedyną drogą do osiągnięcia dokładnego systemu syntetyzowania twarzy CGI/GAN jest znalezienie nowej inicjatywy, która pozwoli na zmontowanie wieloobrazowej jednostki tożsamości w przestrzeni latentnej, gdzie kod latentny dla tożsamości osoby nie musi podróżować przez całą przestrzeń latentną, aby wykorzystać niezwiązane parametry pozy, ale może odnosić się do własnych powiązanych (rzeczywistych) obrazów jako odniesienia do transformacji.
Nawet w takim przypadku, lub nawet gdyby cała sieć StyleGAN była trenowana na zestawie twarzy jednej osoby (podobnie jak zestawy treningowe, których używają autoencodery), brakująca logika semantyczna nadal prawdopodobnie wymagałaby dostarczenia przez technologie takie jak segmentacja semantyczna lub parametryczne twarze 3DMM, które, w takim przypadku, miałyby przynajmniej więcej materiału do pracy.


