
Andersons vinkel
ST-NeRF: Composisjon og redigering for video-syntese

 Legg til Unite.AI blant dine foretrukne kilder på Google

Et kinesisk forskningskonsortium har utviklet teknikk for å bringe redigerings- og komposisjonsfunksjoner til ett av de heteste bildesyntese-forskningsområdene i løpet av det siste året – Neural Radiance Fields (NeRF). Systemet kalles ST-NeRF (Spatio-Temporal Coherent Neural Radiance Field).
Det som ser ut som en fysisk kamera-panorama i bildet under er faktisk bare en bruker som ‘blar’ gjennom forskjellige perspektiver på videoinnhold som eksisterer i et 4D-rom. POV er ikke låst til ytelsen til personene avbildet i videoen, hvis bevegelser kan sees fra hvilket som helst punkt i en 180-graders radius.
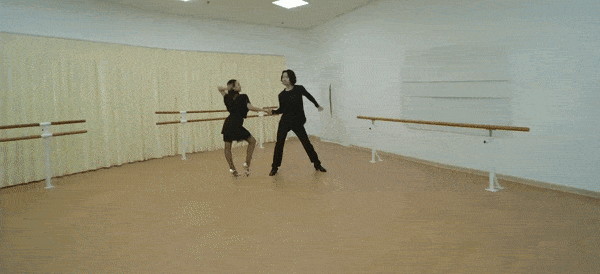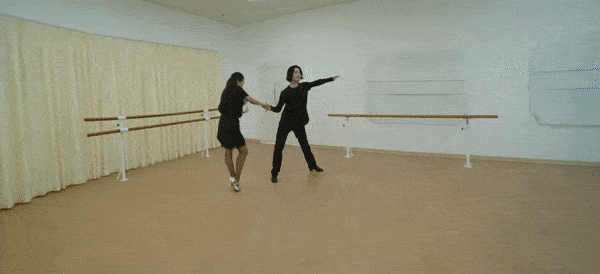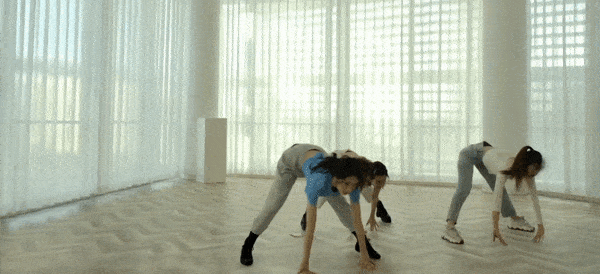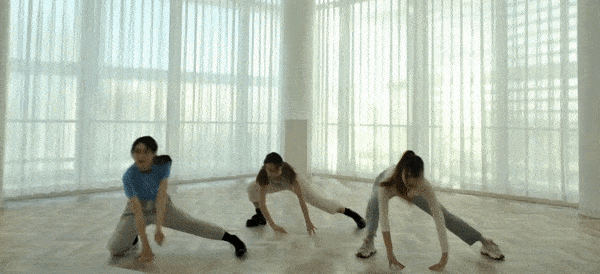
Hver fasett innenfor videoen er et diskret fanget element, komponert sammen til en sammenhengende scene som kan dynamisk utforskes.
Fasettene kan fritt dupliseres innenfor scenen, eller endres i størrelse:
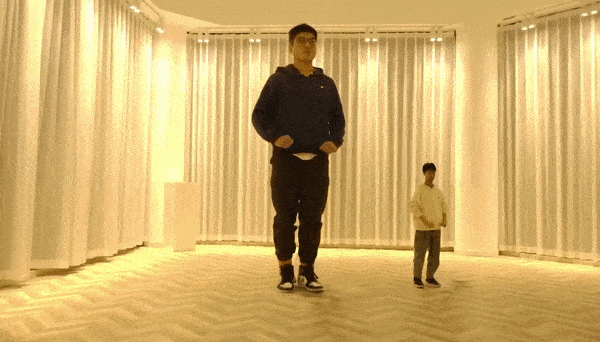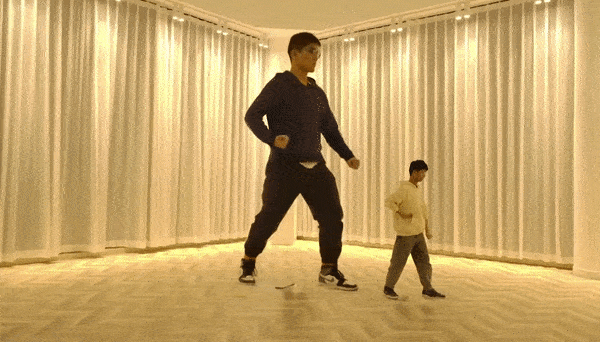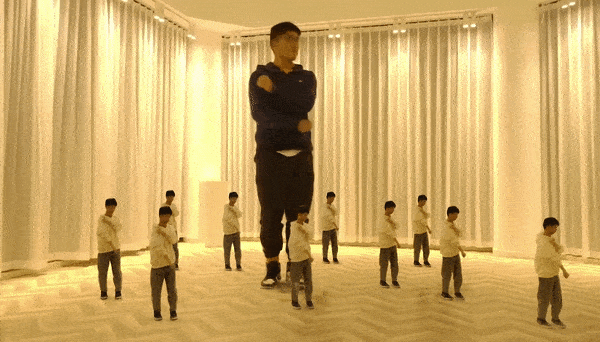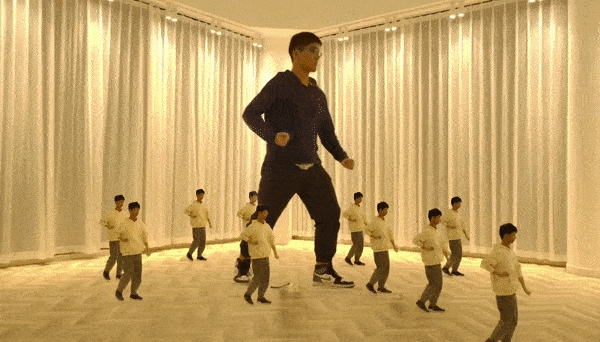
I tillegg kan den temporale atferden til hver fasett lett endres, sakt ned, kjørt baklengs eller manipulert på en rekke måter, åpner veien for filter-arkitekturer og en ekstremt høy grad av tolkbarhet.
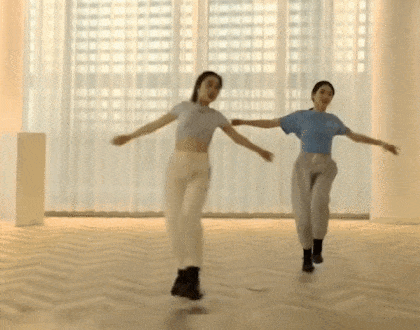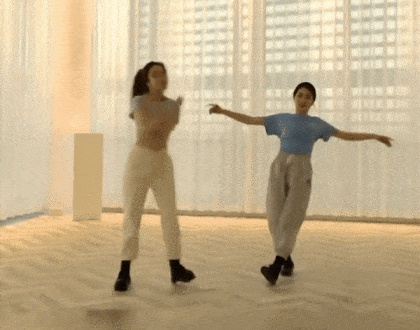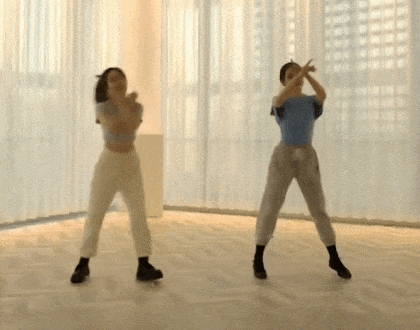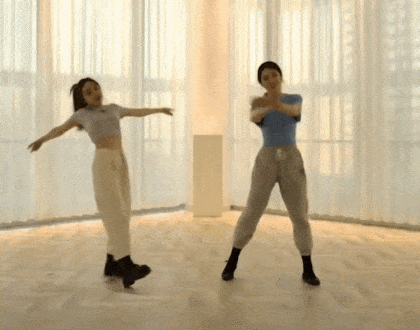
To separate NeRF-fasetter kjører i forskjellige hastigheter i samme scene. Kilde: https://www.youtube.com/watch?v=Wp4HfOwFGP4

Det er ingen behov for å rotoscope utøvere eller miljøer, eller å få utøvere til å utføre bevegelser blindt og utenfor sammenhengen med den ønskede scenen. I stedet blir opptakene tatt naturlig via en rekke på 16 videokameraer som dekker 180 grader:


De tre elementene avbildet over, de to personene og miljøet, er distinkte og konturet bare for illustrasjonens skyld. Hver kan byttes ut, og hver kan settes inn i scenen på et tidligere eller senere punkt i deres individuelle opptakstidslinje.
ST-NeRF er en innovasjon på forskning i Neural Radiance Fields (NeRF), et maskinlærings-rammeverk hvor multiple perspektiver opptak syntetiseres til et navigerbart virtuelt rom ved omfattende trening (selv om enkelt perspektiv opptak også er en undersektor av NeRF-forskning).

Neural Radiance Fields fungerer ved å samle inn multiple perspektiver opptak til et enkelt kohorent og navigerbart 3D-rom, med hullene mellom dekning estimert og renderet av et neuralt nettverk. Der video (i stedet for stillbilder) brukes, er renderingressursene som oftest betydelige. Kilde: https://www.matthewtancik.com/nerf
Interessen for NeRF har blitt intens i løpet av de siste ni månedene, og en Reddit-vedlikeholdt liste over deriverte eller utforskende NeRF-papirer listar for øyeblikket seksti prosjekter.

Bare noen av de mange avleggerne av den opprinnelige NeRF-papiren. Kilde: https://crossminds.ai/graphlist/nerf-neural-radiance-fields-ai-research-graph-60708936c8663c4cfa875fc2/
Rimelig trening
Artikkelen er et samarbeid mellom forskere ved Shanghai Tech University og DGene Digital Technology, og har blitt akseptert med noe entusiasme på Open Review.
ST-NeRF tilbyr en rekke innovasjoner over tidligere initiativer i ML-avledede navigerbare video-rom. Ikke minst, oppnår det en høy grad av realisme med bare 16 kameraer. Selv om Facebooks DyNeRF bruker bare to kameraer mer enn dette, tilbyr det et mye mer begrenset navigerbart bue.
Et eksempel på Facebooks DyNeRF-miljø, med en mer begrenset bevegelsesfelt og flere kameraer per kvadratfot nødvendig for å rekonstruere scenen. Kilde: https://neural-3d-video.github.io
Foruten å mangle evnen til å redigere og komponere individuelle fasetter, er DyNeRF særlig dyrt i forhold til beregningsressurser. I kontrast til dette sier de kinesiske forskerne at treningkostnadene for deres data kommer ut til å ligge mellom $900-$3,000, sammenlignet med $30,000 for den state-of-the-art video-genereringsmodellen DVDGAN, og intensive systemer som DyNeRF.
Recensenter har også notert at ST-NeRF gjør en stor innovasjon i å skille prosessen med å lære bevegelse fra prosessen med bilde-syntese. Denne separasjonen er det som muliggjør redigering og komposisjon, med tidligere tilnærminger begrensede og lineære i sammenligning.
Selv om 16 kameraer er et svært begrenset antall for et så fullt halvsirkel-utsyn, håper forskerne å kutte dette tallet ned ytterligere i senere arbeid gjennom å bruke proxy-pre-skannet statiske bakgrunner og mer data-drevne scenemodelleringstilnærminger. De håper også å inkorporere re-lysbare evner, en ny innovasjon i NeRF-forskning.
Behandling av begrensninger i ST-NeRF
I sammenheng med akademiske CS-papirer som tenderer til å kaste bort den faktiske brukbarheten av et nytt system i en kast-til-slutt-paragraph, er selv begrensningene som forskerne anerkjenner for ST-NeRF usedvanlige.
De observerer at systemet ikke kan individuelt rendre ut bestemte objekter i en scene, fordi personene i opptakene er segmentert i individuelle enheter via et system designet for å gjenkjenne mennesker og ikke objekter – et problem som ser ut til å være lett løst med YOLO og lignende rammer, med det hardeste arbeidet med å trekke ut menneskelig video allerede utført.
Selv om forskerne noterer at det for øyeblikket ikke er mulig å generere slow-motion, ser det ut til å være lite som kan forhindre implementeringen av dette ved å bruke eksisterende innovasjoner i ramme-interpolasjon som DAIN og RIFE.
Som med alle NeRF-implementasjoner, og i mange andre sektorer av datavisjonsforskning, kan ST-NeRF feile i tilfeller av alvorlig okklusjon, der subjektet er midlertidig skjult av en annen person eller et objekt, og kan være vanskelig å kontinuerlig spore eller å gjenopprette etterpå. Som andre steder, kan denne vanskeligheten måtte vente på oppstrøms løsninger. I mellomtiden, innrømmer forskerne at manuell inngripen er nødvendig i disse okkluderte rammer.
Til slutt observerer forskerne at de menneskelige segmenteringsprosedyrene for øyeblikket avhenger av fargeforskjeller, som kunne føre til utilsiktet sammenslåing av to personer i én segmentblokk – en hindring som ikke er begrenset til ST-NeRF, men intrinsic til biblioteket som brukes, og som kunne muligens løses ved optisk flytanalyse og andre fremvoksende tekniker.
Først publisert 7. mai 2021.


