
Andersons vinkel
Hvordan Stable Diffusion kan utvikles til et forbrukerprodukt for folk flest

 Legg til Unite.AI blant dine foretrukne kilder på Google
Viktige punkterEn mainstream Stable Diffusion-app må løse sine komplekse kommandolinjeinstallasjons…
Vis mer
- En mainstream Stable Diffusion-app må løse sine komplekse kommandolinjeinstallasjons- og avhengighetsproblemer.
- Kommersielle utviklere står overfor juridiske risikoer fra deepfake-generering og NSFW-innholdsfiltre.
- Avanserte funksjoner som temporal konsistens og tekstuell inversjon krever skybasert prosessering for forbrukerbruk.
Ironisk nok er Stable Diffusion, det nye AI-bilde syntese-rammeverket som har tatt verden med storm, hverken stabilt eller særlig “diffus” – i alle fall, ikke ennå.
Det fulle spekteret av systemets funksjoner er spredt over en varierende samling av konstant muterende tilbud fra en håndfull utviklere som frenetisk bytter på de nyeste informasjonene og teoriene i diverse diskusjoner på Discord – og det aller meste av installasjonsprosedyrene for pakken de lager eller modifiserer er langt ifra “plug and play”.
I stedet tenderer de til å kreve kommandolinje- eller BAT-drevne installasjoner via GIT, Conda, Python, Miniconda og andre utviklingsrammeverk i teknologiens fremste rekke – programvarepakker som er så sjeldne blant den generelle gjengen av forbrukere at deres installasjon ofte blir flagget av antivirus- og anti-malware-leverandører som bevis på et kompromittert verts-system.

Kun et lite utvalg av stadiene i hinderløypen som den standard Stable Diffusion-installasjonen nå krever. Mange av distribusjonene krever også spesifikke versjoner av Python, som kan være i konflikt med eksisterende versjoner installert på brukerens maskin – selv om dette kan unngås med Docker-baserte installasjoner og, til en viss grad, gjennom bruk av Conda-miljøer.
Meldingstråder i både SFW- og NSFW-Stable Diffusion-samfunn er oversvømmet med tips og triks relatert til hacking av Python-skript og standard-installasjoner, for å aktivere forbedret funksjonalitet eller løse hyppige avhengighetsfeil og en rekke andre problemer.
Dette etterlater den gjennomsnittlige forbrukeren, som er interessert i å lage fantastiske bilder fra tekstprompt, ganske enkelt prisgitt den voksende mengden monetiserte API-nettgrensesnitt, hvor de fleste tilbyr en minimal mengde gratis bildegenerering før de krever kjøp av token.
I tillegg nekter nesten alle disse nettbaserte tilbudene å utgi NSFW-innhold (mye av hvilket kan relatere til ikke-pornografiske emner av generell interesse, som “krig”), som skiller Stable Diffusion fra de sensurerte tjenestene til OpenAI’s DALL-E 2.
‘Photoshop for Stable Diffusion’
Lokket av de fantastiske, vågale eller utenomjordiske bildene som daglig fyller Twitters #stablediffusion-hashtag, venter den brede offentligheten trolig på ‘Photoshop for Stable Diffusion’ – et cross-platform installerbart program som samler de beste og kraftigste funksjonene til Stability.ai’s arkitektur, samt de forskjellige geniale innovasjonene til den nye SD-utviklingsamfunnet, uten noen flytende CLI-vinduer, obskure og konstant endrede installasjons- og oppdateringsrutiner, eller manglende funksjoner.
Hva vi nå har, i de fleste av de mer kapable installasjonene, er en variert elegant nettside koblet til et separat kommandolinjevindu, og hvis URL er en localhost-port:

Lignende CLI-drevne syntese-applikasjoner som FaceSwap og BAT-sentriske DeepFaceLab, viser ‘prepack’-installasjonen av Stable Diffusion sine kommandolinje-røtter, med grensesnittet tilgjengelig via en localhost-port (se toppen av bildet ovenfor) som kommuniserer med CLI-basert Stable Diffusion-funksjonalitet.
Uten tvil er et mer strømlinjeformet program på vei. Allerede er det flere Patreon-baserte integrale applikasjoner som kan lastes ned, som GRisk og NMKD (se bildet under) – men ingen som, ennå, integrerer det fulle spekteret av funksjoner som noen av de mer avanserte og mindre tilgjengelige implementeringene av Stable Diffusion kan tilby.

Tidlige, Patreon-baserte pakker av Stable Diffusion, lett ‘app-ized’. NMKD’s er den første som integrerer CLI-utdata direkte i GUI-en.
La oss se på hva en mer polert og integrert implementering av denne forbløffende åpne kilde-undret kan se ut som – og hvilke utfordringer den kan møte.
Rettslige overveielser for en fullt finansiert kommersiell Stable Diffusion-applikasjon
NSFW-faktoren
Stable Diffusion-kildekoden er utgitt under en ekstremt tillatende lisens som ikke forbyr kommersielle gjennomføringer og avledede verk som bygger omfattende fra kildekoden.
Foruten den ovennevnte og voksende mengden Patreon-baserte Stable Diffusion-versjoner, samt det omfattende antallet applikasjons-tillegg som utvikles for Figma, Krita, Photoshop, GIMP og Blender (blant andre), er det ingen praktisk grunn til at en godt finansierte programvareutviklingshus ikke kunne utvikle en langt mer sofistikert og kapabel Stable Diffusion-applikasjon. Fra et markedsperspektiv er det alle grunner til å tro at flere slike initiativer allerede er godt i gang.
Her møter slike anstrengelser umiddelbart dilemmaet om hvorvidt eller ikke Stable Diffusion’s native NSFW-filter (en fragment av kode), skal tillates å bli slått av.
‘Begraving’ av NSFW-bryteren
Selv om Stability.ai’s åpne kilde-lisens for Stable Diffusion inkluderer en bredt tolkbar liste over applikasjoner som det ikke kan brukes til (inkludert pornografisk innhold og deepfakes), er den eneste måten en leverandør kunne effektivt forby slik bruk å kompilere NSFW-filtret til en uklar eksekverbar fil i stedet for en parameter i en Python-fil, eller å påtvinge en kontrollsumsammenligning på Python-filen eller DLL-en som inneholder NSFW-direktivet, så at rendering ikke kan skje hvis brukerne endrer denne innstillingen.
Dette ville etterlate den påståtte applikasjonen “kastrert” på samme måte som DALL-E 2 nå er, og redusere dens kommersielle appel. Dessuten ville det uunngåelig være dekompilerte og modifiserte versjoner av disse komponentene (enten originale Python-kjøretids-elementer eller kompilerte DLL-filer, som nå brukes i Topaz-linjen av AI-bildeforbedringsverktøy) som ville dukke opp i torrent/hacking-samfunnet for å låse opp slike begrensninger, bare ved å erstatte hindrende elementer og neglisere eventuelle kontrollsumakrav.
Til slutt kan leverandøren velge å bare gjenta Stability.ai’s advarsel mot misbruk som karakteriserer den første kjøringen av mange nåværende Stable Diffusion-distribusjoner.
Men de små åpne kilde-utviklerne som nå bruker uformelle ansvarsfraskrivelser på denne måten, har lite å tape i sammenligning med et programvareselskap som har investert betydelige mengder tid og penger i å gjøre Stable Diffusion fullt funksjonell og tilgjengelig – noe som inviterer til en dyptere overveielse.
Deepfake-ansvar
Som vi nylig har notert, inneholder LAION-aesthetics-databasen, en del av de 4,2 milliarder bildene som Stable Diffusion’s gjeldende modeller ble trent på, et stort antall kjendisbilder, som gjør det mulig for brukerne å effektivt lage deepfakes, inkludert deepfake-kjendis-porn.

Fra vår nylige artikkel, fire stadier av Jennifer Connelly over fire tiår av hennes karriere, inferert fra Stable Diffusion.
Dette er et separat og mer kontroversielt spørsmål enn genereringen av (vanligvis) lovlige “abstrakte” porn, som ikke avbilder “ekte” mennesker (selv om slike bilder er inferert fra flere ekte fotos i treningsmaterialet).
Ettersom en økende mengde US-stater og land utvikler eller har innført lover mot deepfake-porn, kan Stable Diffusion’s evne til å lage kjendis-porn bety at en kommersiell applikasjon som ikke er fullstendig censurert (dvs. som kan lage pornografisk materiale) likevel kan trenge en evne til å filtrere oppfatte kjendis-ansikter.
En metode ville være å tilby en innbygd “svartliste” over termer som ikke vil bli akseptert i en bruker-prompt, relatert til kjendisnavn og til fiktive karakterer som de kan være assosiert med. Antageligvis ville slike innstillinger trenge å bli instituert i flere språk enn bare engelsk, ettersom de opprinnelige dataene inkluderer andre språk. En annen tilnærming kunne være å inkorporere kjendis-gjenkjennelsessystemer som de som er utviklet av Clarifai.
Det kan være nødvendig for programvareprodusenter å inkorporere slike metoder, kanskje initialt slått av, som kan hjelpe med å forhindre at en fullstendig Stable Diffusion-applikasjon genererer kjendis-ansikter, i påvente av nye lover som kan gjøre en slik funksjonalitet ulovlig.
Igjen, likevel, kan en slik funksjonalitet uunngåelig bli dekompilert og omgått av interesserte parter; likevel kan programvareprodusenten, i en slik hendelse, hevde at dette i virkeligheten er uautorisert vandalisme – så lenge en slik omvendt ingeniørkunst ikke gjøres overdrevent enkel.
Funksjoner som kan inkluderes
Kjernefunksjonaliteten i noen Stable Diffusion-distribusjon ville være forventet av noen godt finansierte kommersiell applikasjon. Disse inkluderer evnen til å bruke tekstprompt til å generere passende bilder (tekst-til-bilde); evnen til å bruke skisser eller andre bilder som retningslinjer for nye genererte bilder (bilde-til-bilde); midlene til å justere hvor “fantasifullt” systemet er instruert til å være; en måte å avveie render-tid mot kvalitet; og andre “grunnleggende” funksjoner, som valgfri automatisk bilde/prompt-arkivering, og rutinemessig valgfri oppskalering via RealESRGAN, og minst grunnleggende “ansiktsfiksering” med GFPGAN eller CodeFormer.
Dette er en ganske grunninstallasjon. La oss se på noen av de mer avanserte funksjonene som nå utvikles eller utvides, som kan inkorporeres i en fullstendig “tradisjonell” Stable Diffusion-applikasjon.
Stokastisk frysning
Selv om du gjenbruker en startverdi fra en tidligere vellykket render, er det fryktelig vanskelig å få Stable Diffusion til å nøyaktig gjenta en transformasjon hvis noen del av prompten eller kildebildet (eller begge) endres for en påfølgende render.
Dette er et problem hvis du ønsker å bruke EbSynth til å påtvinge Stable Diffusion’s transformasjoner på virkelig video på en temporelt kohærent måte – selv om teknikken kan være svært effektiv for enkle opptak av hode og skuldre:
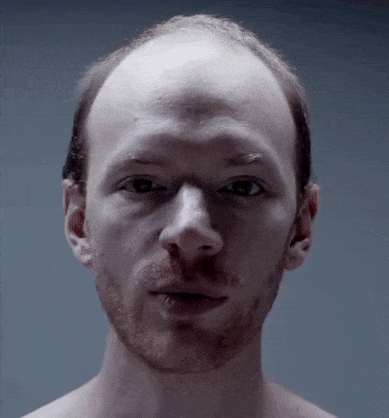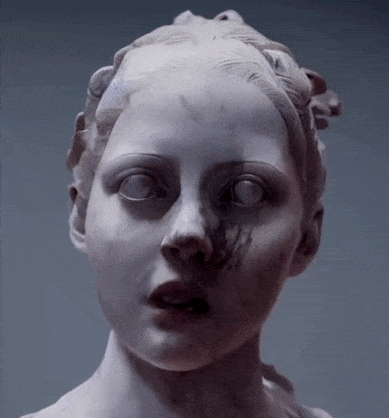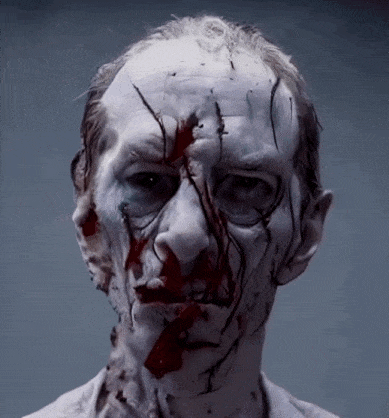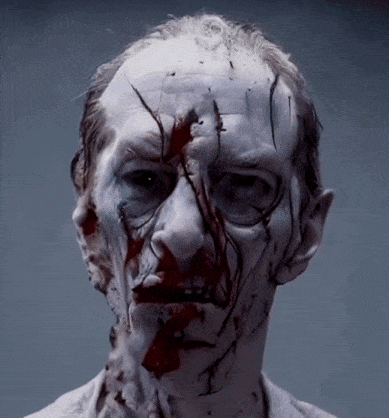
Begrenset bevegelse kan gjøre EbSynth til et effektivt medium for å omdanne Stable Diffusion-transformasjoner til realistisk video. Kilde: https://streamable.com/u0pgzd
EbSynth ekstrapolerer et lite utvalg endrede nøkkelbilder til en video som er eksportert som en serie bildefiler. Disse kan senere settes sammen til video igjen.

I dette eksemplet fra EbSynth-nettstedet er en håndfull videobilder malt kunstnerisk. EbSynth bruker dem som stilguider for å endre hele videoen til den malte stilen. Kilde: https://www.youtube.com/embed/eghGQtQhY38
I eksemplet nedenfor beveger den virkelige blonde yogainstruktøren til venstre seg nesten ikke. Likevel har Stable Diffusion problemer med å holde ansiktet konsekvent, fordi de tre bildene som endres til nøkkelbilder ikke er helt identiske, selv om de bruker samme numeriske startverdi.

Selv med samme prompt og startverdi i alle tre omformingene og svært små endringer mellom kildebildene varierer musklenes størrelse og form. Viktigere er det at ansiktet er inkonsekvent, noe som hindrer tidsmessig sammenheng i en mulig EbSynth-rendering.
SD/EbSynth-videoen nedenfor er oppfinnsom: brukerens fingre blir henholdsvis et par gående ben med bukser og en and. De varierende buksene viser likevel problemet Stable Diffusion har med sammenheng mellom nøkkelbilder, selv med lignende kildebilder og samme startverdi.
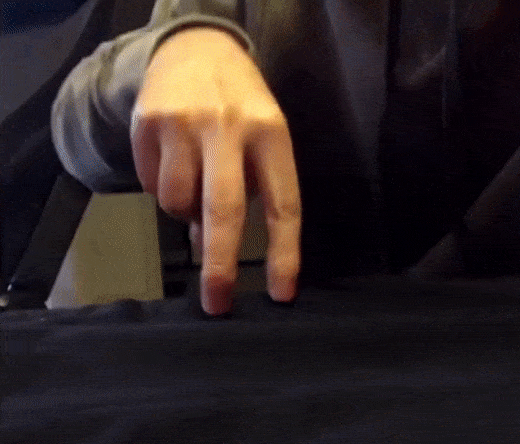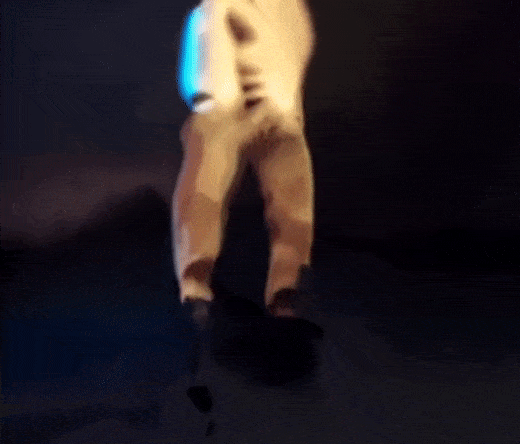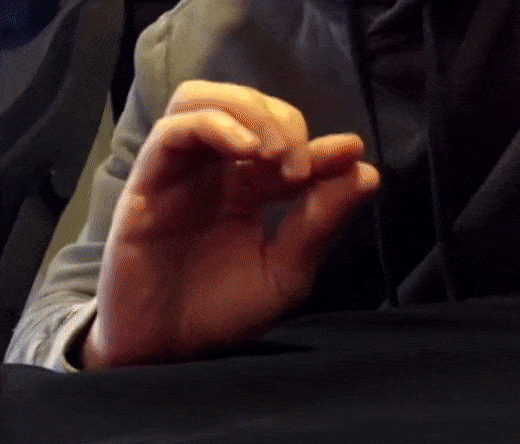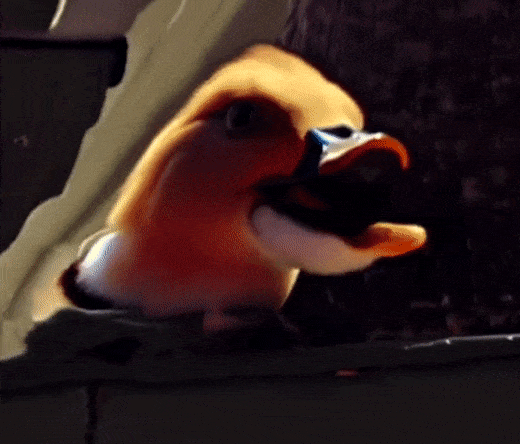
En manns fingre blir en gående mann og en and gjennom Stable Diffusion og EbSynth. Kilde: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
Brukeren som laget videoen, kommenterte at andeforvandlingen, kanskje den mest vellykkede av de to, men mindre slående og original, bare krevde ett endret nøkkelbilde. De gående buksene krevde derimot 50 Stable Diffusion-bilder og viser mer tidsmessig inkonsekvens. Brukeren bemerket også at det tok fem forsøk å oppnå sammenheng for hvert av de 50 nøkkelbildene.
En virkelig komplett Stable Diffusion-applikasjon ville derfor ha stor nytte av funksjoner som bevarer egenskaper best mulig mellom nøkkelbilder.
En mulighet er å la brukeren fryse den stokastiske kodingen av hver bilderutes omforming. I dag krever dette manuell endring av kildekoden. Eksemplet nedenfor viser at det hjelper, men ikke løser alle problemer med tidsmessig sammenheng:
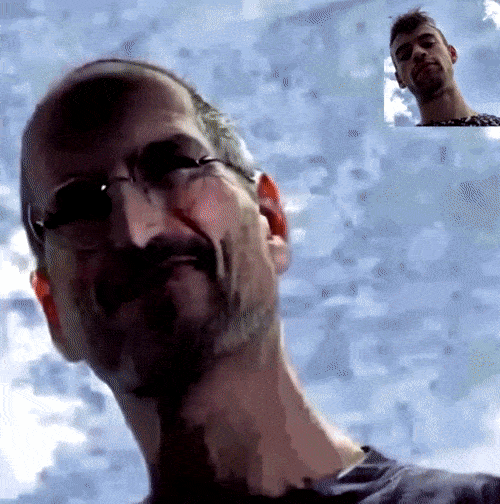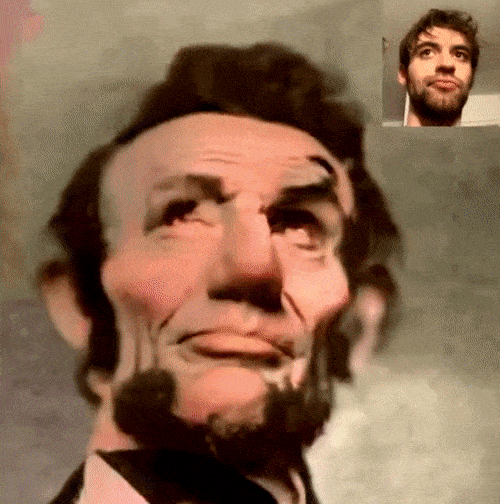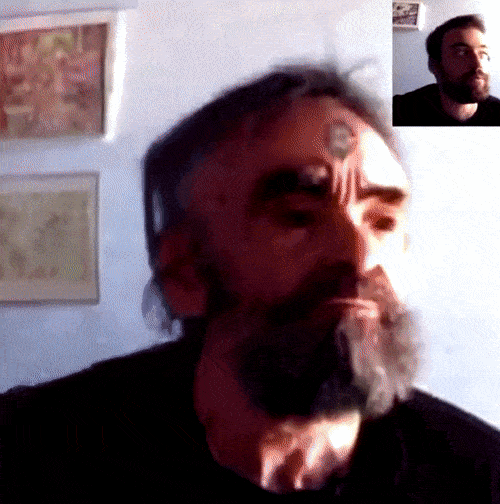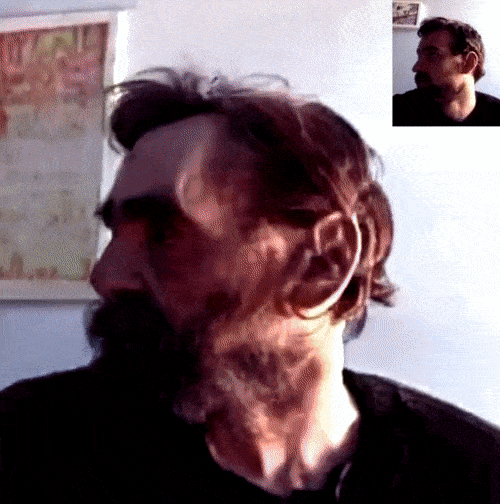
En Reddit-bruker forvandlet opptak av seg selv til ulike kjendiser ved å beholde både startverdien, som enhver implementering av Stable Diffusion kan gjøre, og samme stochastic_encode()-parameter ved hver omforming. Det krevde kodeendringer, men kunne lett bli en bryter for brukeren. Det løser likevel tydeligvis ikke alle tidsmessige problemer. Kilde: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
Skybasert tekstuell inversjon
En bedre løsning for tidsmessig konsekvente figurer og objekter er å bake dem inn i en tekstuell inversjon — en fil på 5 KB som kan trenes på noen timer med bare fem annoterte bilder og deretter hentes frem med en spesiell *-prompt. Det kan for eksempel holde utseendet til nye figurer stabilt gjennom en fortelling.

Bilder med passende merkelapper kan gjøres til egne enheter gjennom tekstuell inversjon og hentes frem entydig, i riktig sammenheng og stil, med særlige tokenord. Kilde: https://huggingface.co/docs/diffusers/training/text_inversion
Tekstuelle inversjoner er tilleggsfiler til den store, ferdigtrente modellen som Stable Diffusion bruker. De flettes inn i prosessen for fremhenting og prompter, slik at de kan delta i scener laget av modellen og utnytte dens enorme kunnskap om objekter, stiler, miljøer og samspill.
Treningen tar ikke lang tid, men krever mye grafikkminne. Dagens veiledninger oppgir et sted mellom 12, 20 og til og med 40 GB VRAM.
Vanlige brukere har trolig ikke så kraftig GPU. Derfor vokser det frem skytjenester som håndterer operasjonen, inkludert en Hugging Face-versjon. Det finnes Google Colab-implementeringer som lager tekstuelle inversjoner, men kravene til minne og tid kan være vanskelige for gratisbrukere av Colab.
For en mulig komplett og godt finansiert installert Stable Diffusion-applikasjon er det en åpenbar inntektsstrategi å flytte denne tunge oppgaven til selskapets skyservere. Det forutsetter at en billig eller gratis applikasjon inneholder slike betalte funksjoner, noe som virker sannsynlig i mange programmer som kan komme fra teknologien de neste 6–9 månedene.
Den nokså kompliserte annoteringen og formateringen av innsendte bilder og tekster kan også automatiseres i et integrert miljø. Å lage unike elementer som utforsker og samhandler med Stable Diffusions store verdener kan bli sterkt avhengighetsskapende, både for entusiaster og yngre brukere.
Fleksibel vekting av prompter
Det finnes mange nåværende implementeringer som tillater brukeren å tildele større vekt til en del av en lang tekstprompt, men instrumenteringen varierer ganske mye mellom disse, og er ofte klønete eller uoversiktlig.
Den svært populære Stable Diffusion-gren av AUTOMATIC1111 kan for eksempel senke eller heve verdien av en prompt-ord ved å omgi det med én eller flere parenteser for å redusere vekt, eller hakeparenteser for ekstra vekt.

Firkant- og/eller parenteser kan transformere din frokost i denne versjonen av Stable Diffusion-prompt-vekt, men det er en kolesterol-mareritt uansett.
Andre iterasjoner av Stable Diffusion bruker utropstegn for emfasering, mens de mest fleksible tillater brukerne å tildele vekter til hvert ord i prompten gjennom grensesnittet.
Systemet bør også tillate negative prompt-vekt – ikke bare for skrekk-fans, men fordi det kan være mindre alarmerende og mer oppbyggelige mysterier i Stable Diffusion’s latente rom enn vår begrensede bruk av språk kan fremkalle.
Bildeutvidelse (outpainting)
Kort tid etter at Stable Diffusion ble åpnet, forsøkte OpenAI å gjenvinne litt av sin DALL-E 2-glorie ved å annonsere outpainting, som tillater en bruker å utvide et bilde utover dets grenser med semantisk logikk og visuell kohærens.
Naturlig nok er dette nå implementert i forskjellige former for Stable Diffusion, samt i Krita, og bør absolutt inkluderes i en omfattende, Photoshop-lignende versjon av Stable Diffusion.
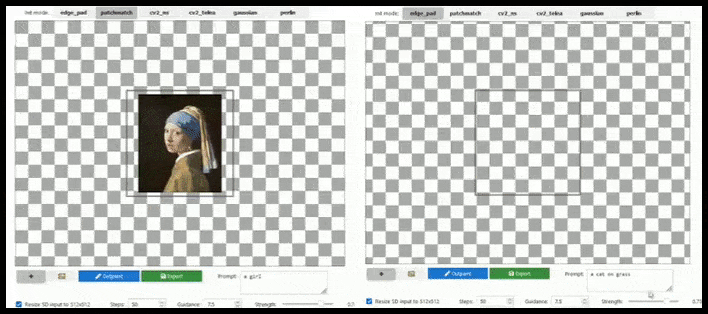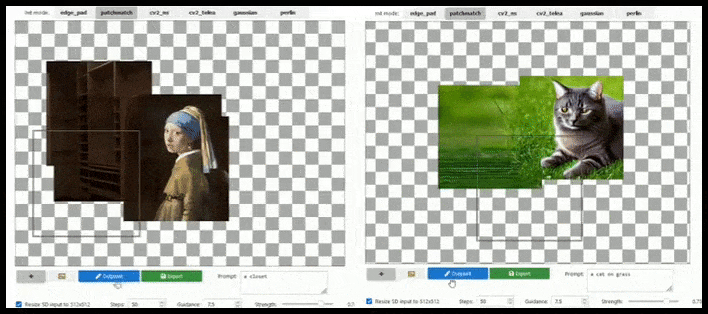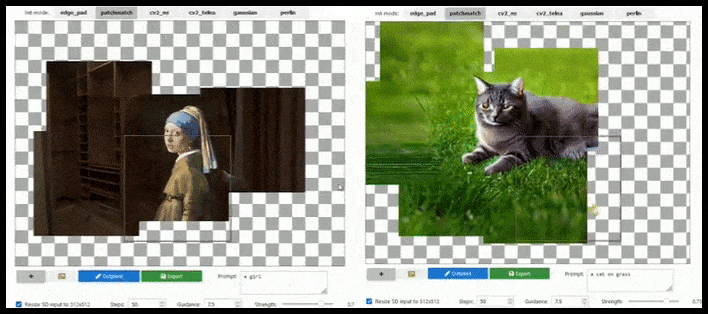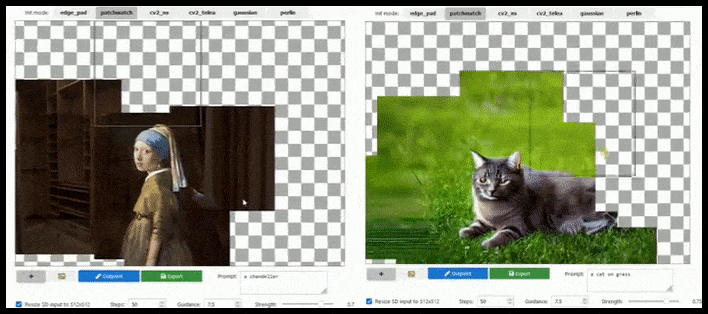
Flis-basert augmentasjon kan utvide et standard 512×512-render nesten uendelig, så lenge promptene, eksisterende bilde og semantisk logikk tillater det. Kilde: https://github.com/lkwq007/stablediffusion-infinity
Fordi Stable Diffusion er trent på 512x512px-bilder (og av en rekke andre årsaker), kutter det ofte hodene (eller andre essensielle kroppsdelene) av menneskelige subjekter, selv der prompten tydelig indikerer “hode-emfasering”, osv.

Typiske eksempler på Stable Diffusion’s “hodekutt”-problemer; men bildeutvidelse kan sette George tilbake i bildet.
En bildeutvidelse-implementering av typen vist i den animerte bildet ovenfor (som er basert eksklusivt på Unix-biblioteker, men burde være i stand til å bli replikert på Windows) burde også være verktøyet som en enkeltklikk-/prompt-løsning for dette problemet.
For tiden utvider en rekke brukere canvaset til “hodekuttede” avbildninger oppover, fyller grovt inn hodet, og bruker img2img til å fullføre den feilaktige renderingen.
Effektiv maske som forstår kontekst
Maske kan være en svært uforutsigbar prosess i Stable Diffusion, avhengig av grenen eller versjonen i spørsmål. Ofte, der det er mulig å tegne en kohærent maske, ender den angitte området med å bli malt inn med innhold som ikke tar hele bildets kontekst med i betraktningen.
På ett tidspunkt maskerte jeg ut kornea av et ansiktsbilde og ga prompten ‘blå øyne’ som en maske-maling – bare for å finne ut at jeg så ut til å se gjennom to utklippede menneskeøyne på et fjernt bilde av en overnaturlig utseende ulv. Jeg antar jeg er heldig at det ikke var Frank Sinatra.
Semantisk redigering er også mulig ved å identifisere støyen som konstruerte bildet i første omgang, noe som gjør det mulig for brukeren å bearbeide bestemte strukturelle elementer i en render uten å forstyrre resten av bildet:

Endring av ett element i et bilde uten tradisjonell maske og uten å endre tilstøtende innhold, ved å identifisere støyen som opprinnelig skapte bildet og bearbeide delene av det som bidro til målområdet. Kilde: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
Dette er basert på K-Diffusion-sampleren.
Semantiske filtre for fysiologiske feil
Som vi har tidligere notert, kan Stable Diffusion ofte legge til eller fjerne lemmer, hovedsakelig på grunn av data-problemer og mangler i annotasjonene som følger med bildene som trente det.

Lignende til den frekke gutten som stakk ut tunga i skolegruppebildet, er Stable Diffusion’s biologiske ugagninger ikke alltid umiddelbart åpenbare, og du kan ha delt din siste AI-mesterverk på Instagram før du legger merke til de ekstra hendene eller smeltede lemmer.
Det er så vanskelig å fikse slike feil at det ville være nyttig hvis en fullstendig Stable Diffusion-applikasjon inneholdt et anatomisk gjenkjennelsessystem som bruker semantisk segmentering til å beregne om det innkommende bildet har alvorlige anatomiske mangler (som i bildet ovenfor), og forkaster det til fordel for en ny render før det presenteres til brukeren.

Selvfølgelig kan du ønske å rendre gudinnen Kali, eller Doctor Octopus, eller til og med redde en uberørt del av et lem-rammet bilde, så denne funksjonen burde være en valgfri bryter.
Hvis brukerne kan tåle telemetri-aspektet, kan slike misfires bli overført anonymt i en kollektiv innsats for føderert læring for å hjelpe fremtidige modeller å forbedre sin forståelse av anatomisk logikk.
LAION-basert automatisk ansiktsforbedring
Som jeg noterte i min tidligere blikk på tre ting Stable Diffusion kan forbedre i fremtiden, bør det ikke bare overlates til noen versjon av GFPGAN å forsøke å “forbedre” rendrete ansikter i første omgang.
GFPGAN’s “forbedringer” er fryktelig generiske, ofte undergraver identiteten til den avbildede personen, og opererer bare på et ansikt som har mottatt ingen mer prosesseringstid eller oppmerksomhet enn noen annen del av bildet.
Derfor burde en profesjonell standard-program for Stable Diffusion kunne gjenkjenne et ansikt (med en standard og relativt lettvekt bibliotek som YOLO), bruke full kraft av tilgjengelig GPU-kraft til å rendre det på nytt, og enten blande det forbedrede ansiktet inn i den opprinnelige full-kontekst-renderingen, eller spare det separat for manuell gjensamling. For tiden er dette en ganske manuell operasjon.
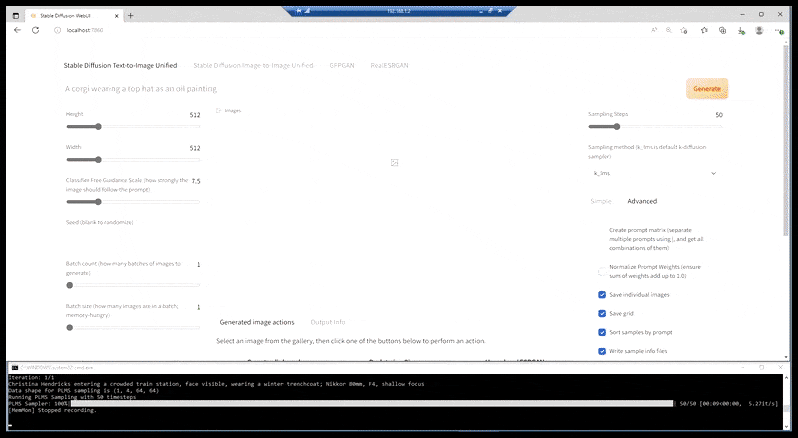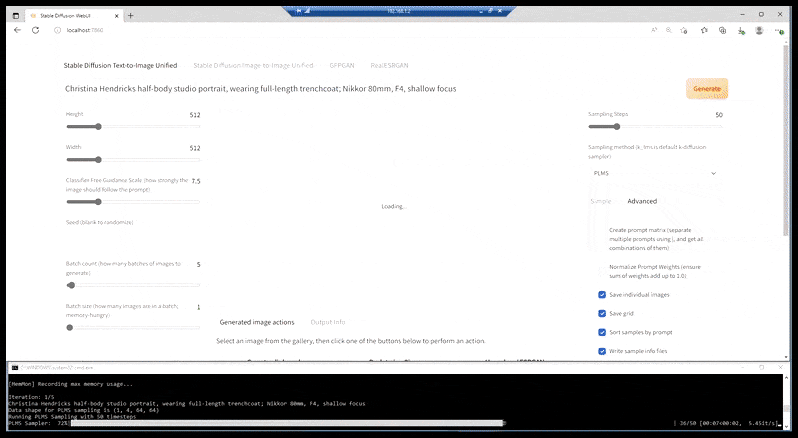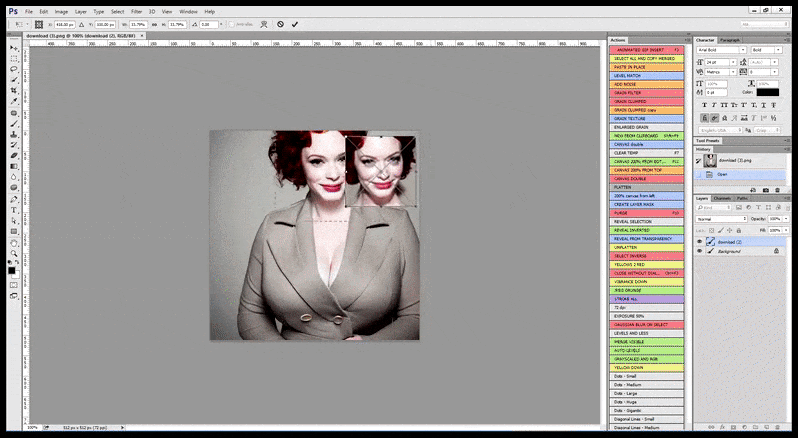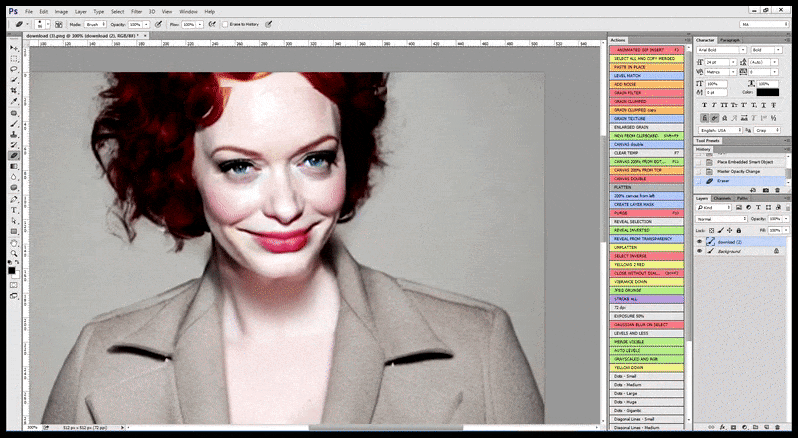
I tilfeller hvor Stable Diffusion har blitt trent på et tilstrekkelig antall bilder av en kjendis, er det mulig å fokusere hele GPU-kapasiteten på en påfølgende render bare av ansiktet på det rendrete bildet, som vanligvis er en merkbart forbedring – og, i motsetning til GFPGAN, trekker på informasjon fra LAION-trent data, i stedet for å bare justere de rendrete pikslene.
Inn-app LAION-søk
Siden brukerne begynte å innse at å søke i LAION-databasen etter konsepter, mennesker og temaer kunne være en hjelp til bedre bruk av Stable Diffusion, har flere nettbaserte LAION-utforskere blitt laget, inkludert haveibeentrained.com.

Søkefunksjonen på haveibeentrained.com lar brukerne utforske bildene som driver Stable Diffusion, og oppdage om objekter, mennesker eller ideer de kan ønske å fremkalle fra systemet, sannsynligvis inngikk i treningen. Slike systemer hjelper også å finne beslektede enheter, for eksempel hvordan kjendiser grupperes eller neste idé som springer ut av den nåværende. Kilde: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
Selv om slike webdatabaser ofte viser noen av bildenes merkelapper, gjør generaliseringen under modelltrening det usannsynlig at et bestemt bilde kan hentes frem bare ved å bruke merkelappen som prompt.
I tillegg betyr fjerningen av ‘stopp-ord’ og praksisen med stemming og lemmatisering i naturlig språkbehandling, at mange av frasene som vises ble delt opp eller utelatt før de ble trent inn i Stable Diffusion.
Likevel kan måten æstetiske grupper binder sammen i disse grensesnittene lære sluttbetrakteren mye om logikken (eller “personligheten”) til Stable Diffusion, og kan være en hjelp til bedre bildeproduksjon.
Konklusjon
Det er mange andre funksjoner jeg ville ønske å se i en fullstendig innfødt skrivebordsimplementering av Stable Diffusion, som nativ CLIP-basert bildeanalyse, som reverserer den standard Stable Diffusion-prosessen og tillater brukeren å fremkalle fraser og ord som systemet ville naturlig assosiere med kildebildet, eller renderet.
I tillegg ville ekte oppskalering basert på bildefliser være en velkommen tilføyelse, ettersom ESRGAN er nesten like grov som GFPGAN. Heldigvis er planer for å integrere txt2imghd-implementeringen av GOBIG raskt på vei til å gjøre dette en realitet over distribusjonene, og det ser ut til å være et åpenbart valg for en skrivebordsiterasjon.
Noen andre populære forespørsler fra Discord-samfunnene interesserer meg mindre, som integrerte prompt-ordlister og anvendbare lister over kunstnere og stiler, selv om en inn-app-notatbok eller en tilpassbar leksikon av fraser ville se ut til å være en logisk tilføyelse.
Liksom begrensningene til menneske-sentrert animasjon i Stable Diffusion, selv om det har blitt kick-startet av CogVideo og andre prosjekter, er fremdeles svært umodent, og prisgitt grunnforskning på tidsmessige forhåndskunnskaper relatert til ekte menneskelig bevegelse.
For nå er Stable Diffusion-video strengt psykedelisk, selv om det kan ha en mye lysere nær-fremtid i deepfake-dokke-spill, via EbSynth og andre relativt nye tekst-til-video-initiativer (og det er verdt å merke mangelen på syntetiske eller “endrede” mennesker i Runway’s siste promotivideo).
En annen verdifull funksjonalitet ville være sømløs bildeoverføring til Photoshop og tilbake, som har vært etablert i Cinema4D’s tekstur-editor, blant andre lignende implementeringer. Med dette kan du enkelt skyte bilder mellom applikasjoner og bruke hver applikasjon til å utføre transformasjonene den er best på.
Til slutt, og kanskje viktigst, burde en fullstendig Stable Diffusion-programvare kunne ikke bare bytte lett mellom kontrollpunkter (dvs. versjoner av den underliggende modellen som driver systemet), men også kunne oppdatere egentilpassede tekstuelle inversjoner som fungerte med tidligere offisielle modell-utgaver, men som kan være ødelagt av senere versjoner av modellen (som utviklere på den offisielle Discord har indikert kan være tilfelle).
Ironisk nok er organisasjonen i den aller beste posisjonen til å skape en så kraftfull og integrert matrise av verktøy for Stable Diffusion, Adobe, som har alliert seg så sterkt til Content Authenticity Initiative at det kan se ut som en retrograd PR-feil for selskapet – med mindre det ville å hogge Stable Diffusion’s generative krefter like grundig som OpenAI har gjort med DALL-E 2, og posisjonere det i stedet som en naturlig utvikling av sine betydelige beholdninger i arkivfotografi.
Først publisert 15. september 2022.


