
Andersons vinkel
Tre utfordringer foran for Stable Diffusion

 Legg til Unite.AI blant dine foretrukne kilder på Google
Utgivelsen av stability.ai’s Stable Diffusion latent diffusion bilde-syntesemodell for noen uker siden kan være en av de mest betydningsfulle teknologiske avsløringene siden DeCSS i 1999; det er uten tvil den største hendelsen i AI-generert bilde siden deepfakes-koden ble kopiert over til GitHub og forket til hva som skulle bli DeepFaceLab og FaceSwap, samt den sanntidsstrømmende deepfake-programvaren DeepFaceLive.
Med ett slag ble brukerirritasjon over innholdsbegrensninger i DALL-E 2’s bilde-syntese-API satt til side, da det viste seg at Stable Diffusions NSFW-filtre kunne deaktiveres ved å endre en enkel linje med kode. Pornocentrerte Stable Diffusion-Reddit-grupper dukket opp nesten umiddelbart, og ble like raskt fjernet, mens utvikler- og brukerleiren delte seg på Discord i offisielle og NSFW-samfunn, og Twitter begynte å fylles med fantastiske Stable Diffusion-oppfinnelser.
For øyeblikket ser det ut til at hver dag bringer noen fantastiske innovasjoner fra utviklerne som har adoptert systemet, med plugins og tredjeparts-tillegg som raskt skrives for Krita, Photoshop, Cinema4D, Blender og mange andre applikasjonsplattformer.
I mellomtiden er promptcraft – den nå profesjonelle kunsten å ‘whisper’ til AI, som kan ende med å bli den korteste karrierevalget siden ‘Filofax-binder’ – allerede i ferd med å bli kommercialisert, mens tidlig monetisering av Stable Diffusion skjer på Patreon-nivå, med sikkerheten på mer avanserte tilbud som kommer, for de som ikke ønsker å navigere Conda-basert installer av kildekoden, eller de proskriptive NSFW-filtrene i web-basert implementering.
Utviklingstakten og den frie utforskingssansen fra brukerne skjer i så rasende fart at det er vanskelig å se langt foran. I realiteten vet vi ikke helt hva vi har å gjøre med enda, eller hva alle begrensningene eller mulighetene kan være.
Likevel, la oss se på tre av hva som kan være de mest interessante og utfordrende hindringene for den raskt dannete og raskt voksende Stable Diffusion-samfunnet å møte og, håper vi, overvinne.
1: Optimisering av flisebaserte rørledninger
Presentert med begrensede maskinvareressurser og harde grenser for oppløsningen av treningbilder, ser det ut til at utviklerne vil finne løsninger for å forbedre både kvaliteten og oppløsningen av Stable Diffusions utdata. Mange av disse prosjektene er satt til å utnytte begrensningene i systemet, som dens native oppløsning på bare 512×512 piksler.
Som alltid er tilfelle med datavisualisering og bilde-syntese-initiativer, ble Stable Diffusion trent på kvadratisk forholdsbilder, i dette tilfelle omplassert til 512×512, så at kildebildene kunne regulariseres og kunne passe inn i begrensningene i GPU-ene som trente modellen.
Derfor “tenker” Stable Diffusion (hvis den tenker i det hele tatt) i 512×512-termer, og uten tvil i kvadratisk forhold. Mange brukere som nå prøver grensene for systemet, rapporterer at Stable Diffusion produserer de mest pålitelige og minst feilfylte resultater ved denne ganske begrensede aspektforholdet (se “adresse ekstremitet” nedenfor).
Selv om flere implementeringer har oppskalering via RealESRGAN (og kan fikse dårlig renderede ansikter via GFPGAN), utvikler noen metoder for å dele opp bilder i 512x512px-seksjoner og sy sammen bildene for å danne større komposittverk.

Dette 1024×576-renderet, en oppløsning som vanligvis er umulig i et enkelt Stable Diffusion-render, ble laget ved å kopiere og lime inn attention.py Python-filen fra DoggettX-forken av Stable Diffusion (en versjon som implementerer flisebasert oppskalering) inn i en annen fork. Kilde: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
Selv om noen initiativer av denne typen bruker original kode eller andre biblioteker, er txt2imghd-porten av GOBIG (en modus i den VRAM-hungry ProgRockDiffusion) satt til å gi denne funksjonaliteten til hovedgrenen snart. Mens txt2imghd er en dedikert port av GOBIG, inneholder andre anstrengelser fra samfunnsutviklere forskjellige implementeringer av GOBIG.

Et praktisk abstrakt bilde i det originale 512x512px-renderet (venstre og andre fra venstre); oppskalert av ESGRAN, som nå er mer eller mindre native over alle Stable Diffusion-distribusjoner; og gitt ‘spesiell oppmerksomhet’ via en implementering av GOBIG, som produserer detaljer som, i det minste innenfor grensene for bildeavsnittet, ser bedre oppskalert ut. Kilde: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
Dette abstrakte eksempelet har mange “lille kongeriker” av detaljer som passer denne solipsistiske tilnærmingen til oppskalering, men som kan kreve mer utfordrende kode-drevne løsninger for å produsere ikke-repetitive, sammenhengende oppskalering som ikke ser ut som om den var sammensatt av mange deler. Ikke minst i tilfelle av menneskeansikter, hvor vi er usedvanlig tilpasset avvik eller “jarring” artefakter. Derfor kan ansikter til slutt trenge en dedikert løsning.
Stable Diffusion har for øyeblikket ingen mekanisme for å fokusere oppmerksomheten på ansiktet under et render, på samme måte som mennesker prioriterer ansiktsinformasjon. Selv om noen utviklere i Discord-samfunnene vurdere metoder for å implementere denne type “forbedret oppmerksomhet”, er det for øyeblikket mye enklere å manuelt (og, til slutt, automatisk) forbedre ansiktet etter at det opprinnelige renderet har funnet sted.
Et menneskeansikt har en intern og fullstendig semantisk logikk som ikke vil finnes i en “flise” av bunnen av (for eksempel) en bygning, og derfor er det for øyeblikket mulig å veldig effektivt “zoom inn” og rendre et “skisseaktig” ansikt i Stable Diffusions utdata.

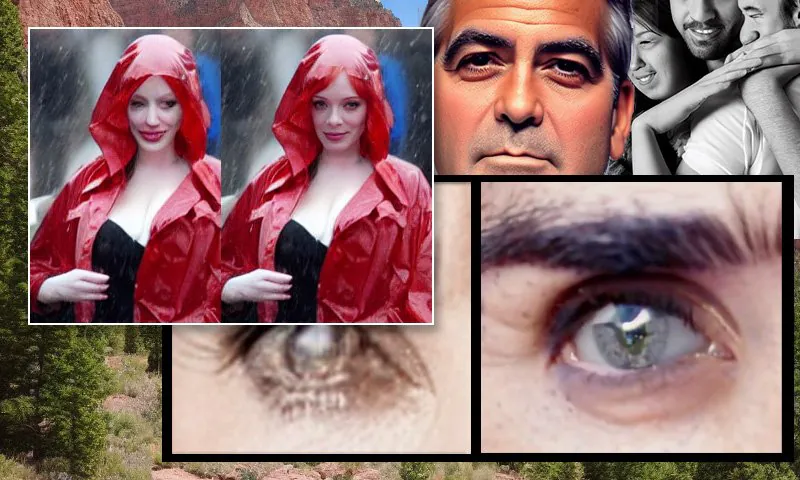
Venstre, Stable Diffusions første forsøk med prompten ‘Full-length fargefoto av Christina Hendricks som går inn i en overfyldt plass, iført en regnjakke; Canon50, øyekontakt, høy detalj, høy ansiktsdetalj’. Høyre, et forbedret ansikt som er fått ved å mata det uskarpe og skisseaktige ansiktet fra første renderet tilbake til full oppmerksomhet i Stable Diffusion ved hjelp av Img2Img (se animerte bilder nedenfor).
I fravær av en dedikert tekstuell inversjonsløsning (se nedenfor), vil dette bare fungere for kjendisbilder hvor personen i question allerede er godt representert i LAION-datasubsettene som trente Stable Diffusion. Derfor vil det fungere på personer som Tom Cruise, Brad Pitt, Jennifer Lawrence og en begrenset rekke ekte mediepersonligheter som er til stede i store mengder bilder i kilde-dataene.
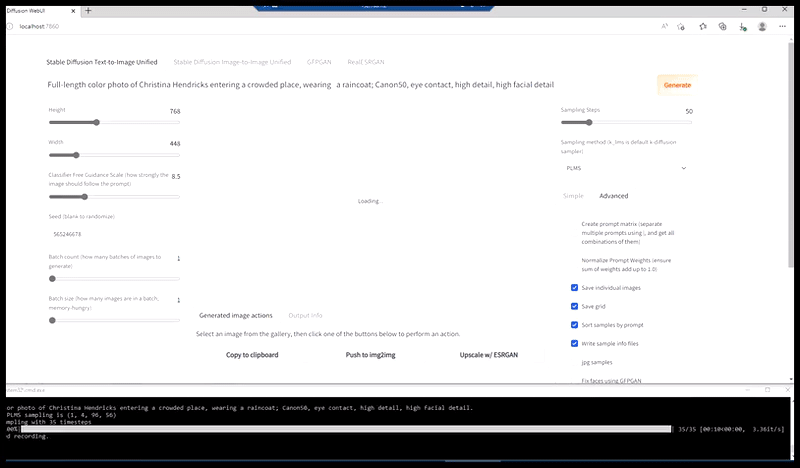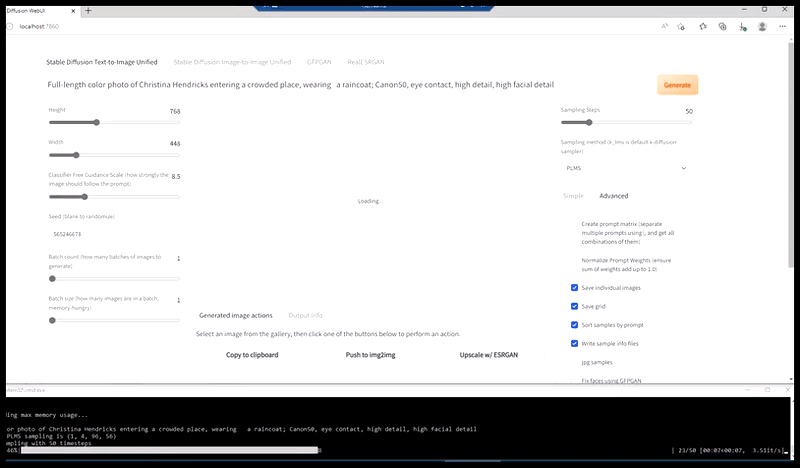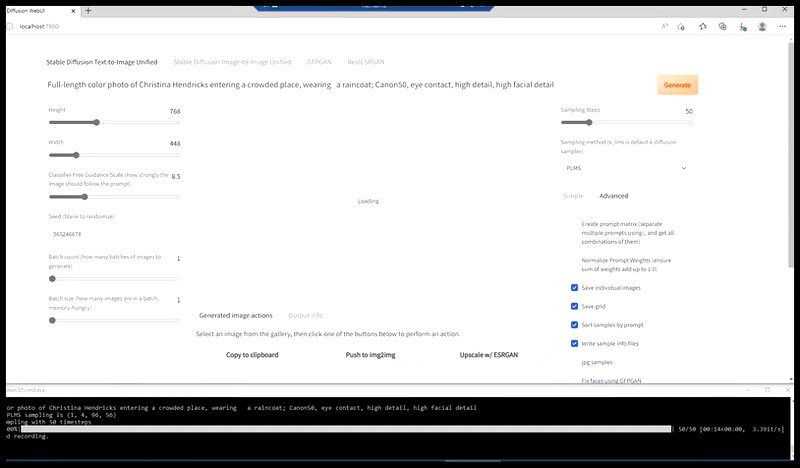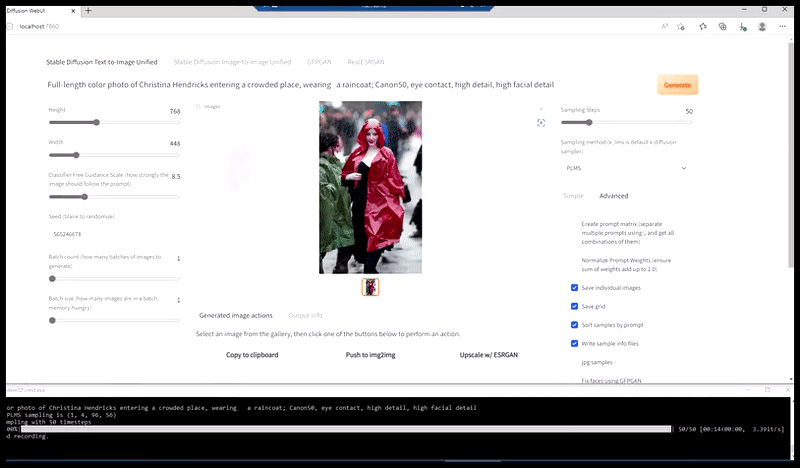
Genererer et plausibelt pressebilde med prompten ‘Full-length fargefoto av Christina Hendricks som går inn i en overfyldt plass, iført en regnjakke; Canon50, øyekontakt, høy detalj, høy ansiktsdetalj’.
For kjendiser med lange og varige karrierer, vil Stable Diffusion vanligvis generere et bilde av personen i en senere (dvs. eldre) alder, og det vil være nødvendig å legge til prompt-tillegg som ‘ung’ eller ‘i år [ÅR]’ for å produsere yngre utseende bilder.

Med en fremtredende, mye fotografert og konsekvent karriere som varer nesten 40 år, er skuespilleren Jennifer Connelly en av en håndfull kjendiser i LAION som tillater Stable Diffusion å representere en rekke aldre. Kilde: prepack Stable Diffusion, lokal, v1.4 checkpoint; aldersrelaterte promptrer.
Dette er hovedsakelig på grunn av spredningen av digital (i stedet for dyre, emulsjonsbaserte) pressefotografering fra midten av 2000-tallet og den senere veksten i volum av bildeutgang på grunn av økt bredbåndshastighet.
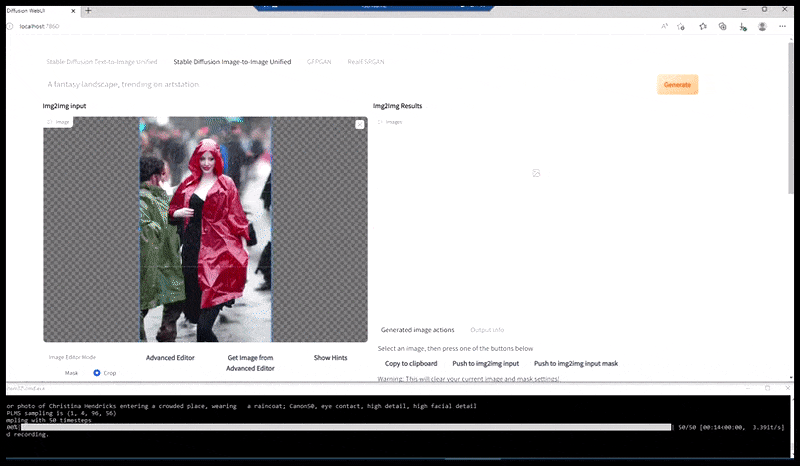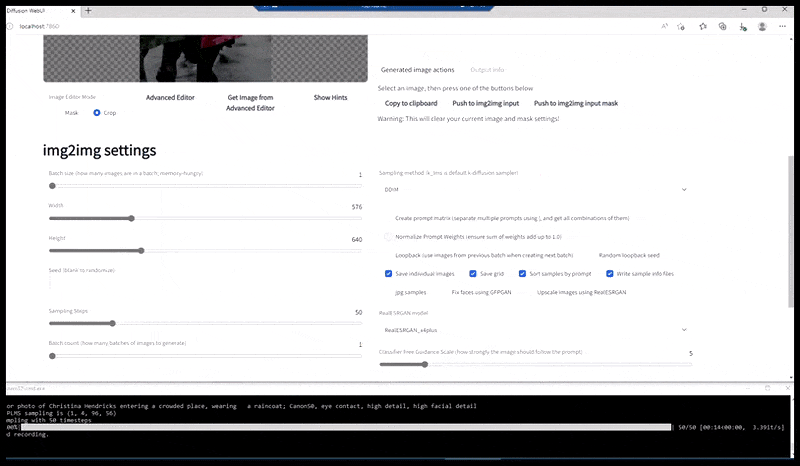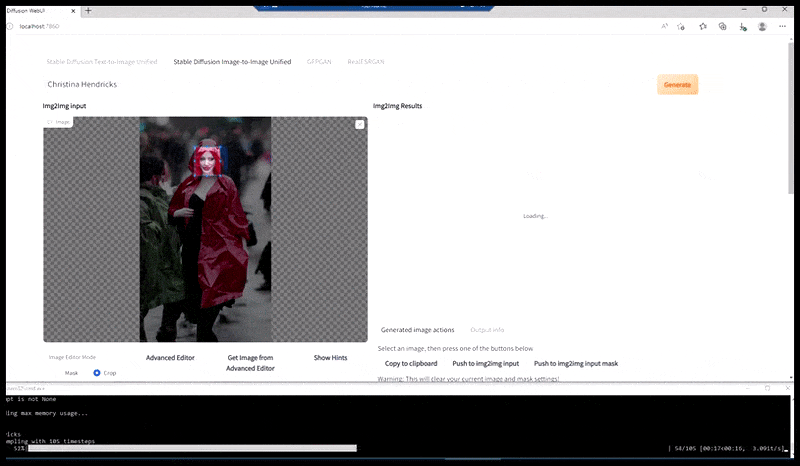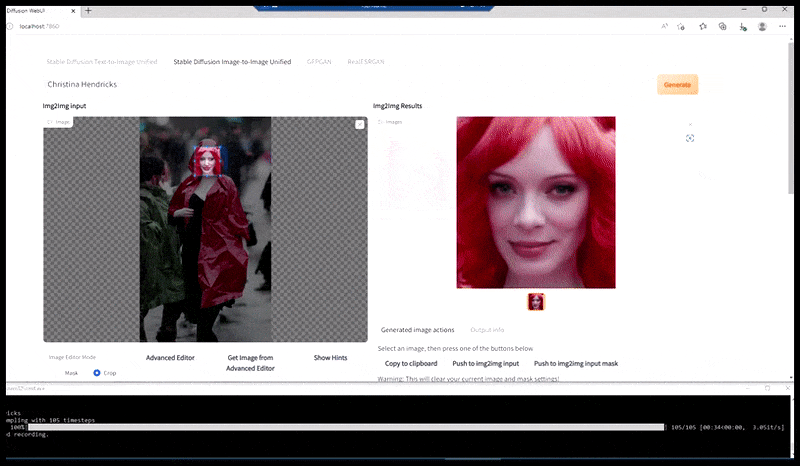
Det renderede bildet blir sendt gjennom til Img2Img i Stable Diffusion, der et ‘fokusområde’ blir valgt, og et nytt, maks-størrelse render blir gjort bare av det området, og lar Stable Diffusion konsentrere alle tilgjengelige ressurser om å gjenskape ansiktet.
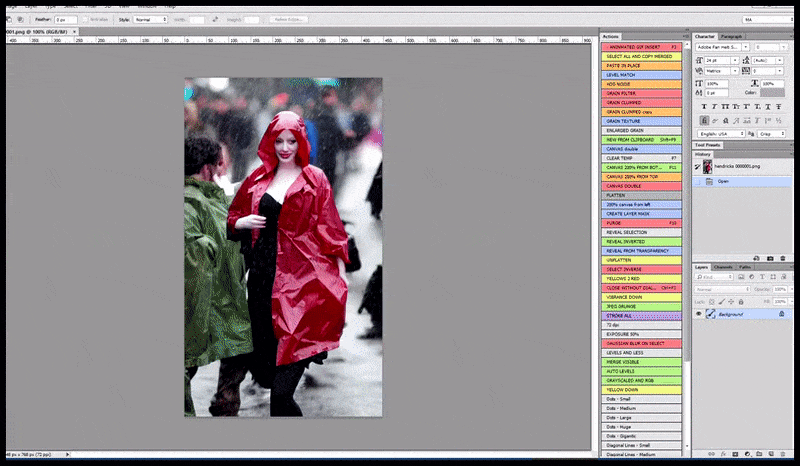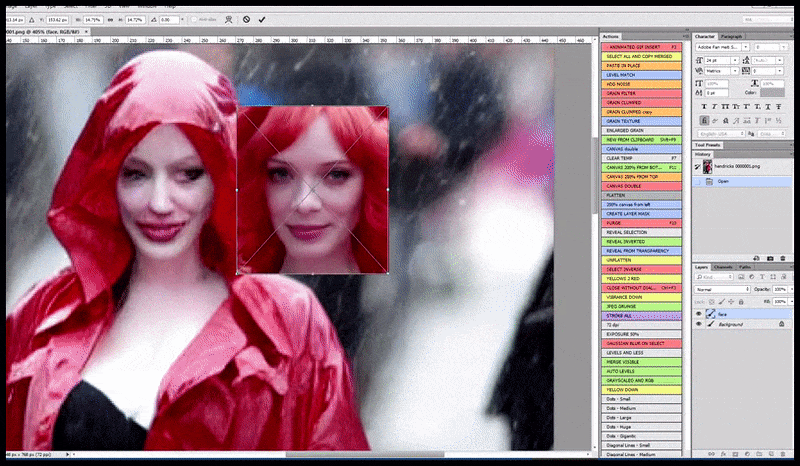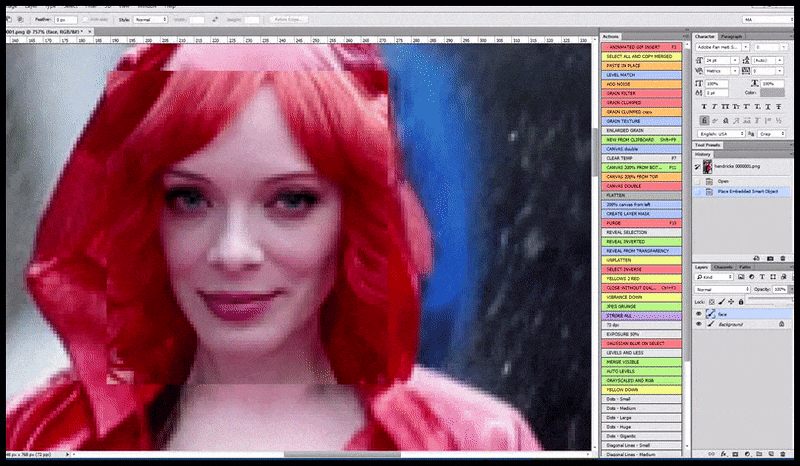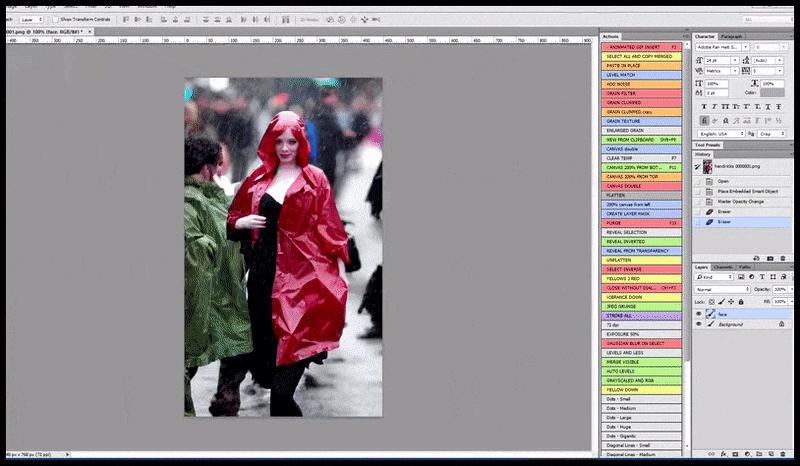
Komposisjon av ‘høy oppmerksomhet’ ansiktet tilbake i det opprinnelige renderet. Foruten ansikter, vil denne prosessen bare fungere med enheter som har en potensiell kjent, sammenhengende og integralt utseende, som en del av det opprinnelige bildet som har en distinkt gjenstand, som en klokke eller en bil. Oppskalering av et avsnitt av – for eksempel – en vegg, vil føre til et veldig merkelig utseende gjenassemblert vegg, fordi flise-renderne hadde ingen videre kontekst for denne ‘puslebrikken’ mens de renderde.
Noen kjendiser i databasen kommer ‘forhåndsfrosne’ i tid, enten fordi de døde tidlig (som Marilyn Monroe), eller steg bare til midlertidig mainstream-popularitet, og produserte et stort volum bilder i en begrenset periode. Avstemning av Stable Diffusion kan argumenteres for å gi en slags ‘nåværende’ popularitetsindeks for moderne og eldre stjerner. For noen eldre og nåværende kjendiser, finnes det ikke nok bilder i kilde-dataene til å få en veldig god likhet, mens den varige populariteten til bestemte lenge døde eller ellers fadet stjerner sikrer at deres rimelige likhet kan bli oppnådd fra systemet.

Stable Diffusion-renderinger avslører raskt hvilke berømte ansikter som er godt representert i treningsdataene. Til tross for hennes enorme popularitet som en eldre tenåring på tidspunktet for skriving, var Millie Bobby Brown yngre og mindre kjent da LAION-kilde-datasettene ble skrapt fra nettet, og gjorde en høykvalitets likhet med Stable Diffusion problematisk for øyeblikket.
Hvor dataene er tilgjengelige, kan flisebaserte oppskalingsløsninger i Stable Diffusion gå lenger enn å fokusere på ansiktet: de kan potensielt aktivere enda mer nøyaktige og detaljerte ansikter ved å bryte ned ansiktsfunksjoner og vende hele kraften av lokale GPU-resurser på saliente funksjoner individuelt, før gjenassemblage – en prosess som for øyeblikket, igjen, er manuell.

Dette er ikke begrenset til ansikter, men det er begrenset til deler av objekter som er minst like forutsigbare plassert i den videre konteksten av vert-objektet, og som konvergerer med høynivå-inklusjoner som en kunne forvente å finne i et hyperskala-dataset.
Den virkelige grensen er mengden tilgjengelig referansedata i datasettene, fordi, til slutt, dypitererte detaljer vil bli fullstendig “hallusinert” (dvs. fiktive) og mindre autentiske.
Slike høynivå, granulerte forstørrelser fungerer i tilfelle Jennifer Connelly, fordi hun er godt representert over en rekke aldre i LAION-aesthetics (den primære undermengden av LAION 5B som Stable Diffusion bruker), og generelt over LAION; i mange andre tilfeller ville nøyaktigheten lide under mangelen på data, og ville kreve enten finjustering (ytterligere trening, se ‘Tilpasning’ nedenfor) eller tekstuell inversjon (se nedenfor).
Fliser er en kraftfull og relativt billig måte for Stable Diffusion å kunne produsere hi-res utdata, men algoritme-basert flise-opp-skaleringsløsninger av denne typen, hvis de mangler en slags bredere, høyere nivå oppmerksomhetsmekanisme, kan falle kort av de håpede standarder over en rekke innholdstyper.
2: Løsning av problemer med menneskelige lemmer
Stable Diffusion holder ikke målet sitt når det gjelder å avbilde kompleksiteten av menneskelige ekstremiteter. Hender kan multiplisere tilfeldig, fingre koalescere, tredje ben dukke opp uventet, og eksisterende lemmer forsvinne uten spor. I sin forsvar, deler Stable Diffusion problemet med sine stabile medarbeidere, og mest sannsynlig med DALL-E 2.

Uredigerte resultater fra DALL-E 2 og Stable Diffusion (1.4) på slutten av august 2022, begge viser problemer med lemmer. Prompt er ‘En kvinne omfavner en mann’
Stable Diffusion-entusiaster som håper at den kommende 1.5-checkpointen (en mer intensivt trent versjon av modellen, med forbedrede parametre) ville løse lemmeproblemet, er sannsynligvis skuffet. Den nye modellen, som vil bli utgitt om to uker, er for øyeblikket premiere på den kommersielle stability.ai-portalen DreamStudio, som bruker 1.5 som standard, og hvor brukerne kan sammenligne den nye utdata med renderinger fra deres lokale eller andre 1.4-systemer:

Kilde: Lokal 1.4 prepack og https://beta.dreamstudio.ai/

Kilde: Lokal 1.4 prepack og https://beta.dreamstudio.ai/

Kilde: Lokal 1.4 prepack og https://beta.dreamstudio.ai/
Som oftest er tilfelle, kan datakvaliteten være den primære bidragende årsaken.
De åpne kildebaser som driver bilde-syntese-systemer som Stable Diffusion og DALL-E 2, kan gi mange etiketter for både enkeltmennesker og inter-menneskelig handling. Disse etikettene blir trent inn symbiotisk med deres assosierte bilder, eller segmenter av bilder.

Stable Diffusion-brukere kan utforske konseptene som er trent inn i modellen ved å spørre LAION-aesthetics-datasett, en undermengde av den større LAION 5B-datasett, som driver systemet. Bildene er ordnet ikke etter deres alfabetiske etiketter, men etter deres ‘estetisk poeng’. Kilde: https://rom1504.github.io/clip-retrieval/
En god hierarki av enkeltetiketter og klasser som bidrar til avbildningen av et menneskearm ville være noe som kropp>arm>hånd>fingre>[under-digiter + tommel]>[digit-segmenter]>Negler.

Granulær semantisk segmentering av deler av en hånd. Selv denne usedvanlig detaljerte dekonstruksjonen lar hver ‘finger’ som en enkelt enhet, uten å ta hensyn til de tre seksjonene av en finger og de to seksjonene av en tommel. Kilde: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
I virkeligheten er kildebildene usannsynlig å være så konsekvent annotert over hele datasettene, og usuperviserte etikett-algoritmer vil sannsynligvis stoppe på høyere nivå av – for eksempel – ‘hånd’, og lar de indre pikslene (som teknisk sett inneholder ‘finger’-informasjon) som en uetikettet masse av piksler, som vil bli derivert arbitrært, og som kan manifestere seg i senere renderinger som en jarring-element.

Hvordan det skal være (øverst til høyre, hvis ikke øverst-kuttet), og hvordan det tenderer å være (nederst til høyre), på grunn av begrensede ressurser for etikettering, eller arkitektonisk utnyttelse av slike etiketter hvis de eksisterer i datasettene.
Så, hvis en latent diffusjonsmodell kommer så langt som å rendre en arm, er det nesten sikkert at den vil prøve å rendre en hånd på slutten av den armen, fordi arm>hånd er den minste nødvendige hierarkiet, ganske høyt oppe i hva arkitekturen vet om ‘menneskelig anatomi’.
Etter det, kan ‘fingre’ være den minste grupperingen, selv om det er 14 flere finger/tommel-underdeler å vurdere når det gjelder å avbilde menneskehender.
Hvis denne teorien holder, er det ingen virkelig kur, på grunn av sektoren-gjennomgående mangelen på budsjett for manuell annotering, og mangelen på tilstrekkelig effektive algoritmer som kunne automatisere etikettering mens de produserer lave feilrater. I virkeligheten kan modellen for øyeblikket være avhengig av menneskelig anatomisk konsistens for å dekke over manglene i datasettene den ble trent på.
En mulig årsak til at den ikke kan stole på dette, nylig forslagt på Stable Diffusion Discord, er at modellen kan bli forvirret om det riktige antallet fingre en (realistisk) menneskehånd skal ha, fordi LAION-deriverte database som driver den, inneholder tegneseriefigurer som kan ha færre fingre (som er en laborbesparende kortvei).

To av de potensielle skyldige i ‘manglende finger’-syndromet i Stable Diffusion og lignende modeller. Under, eksempler på tegnehånd fra LAION-aesthetics-datasett som driver Stable Diffusion. Kilde: https://www.youtube.com/watch?v=0QZFQ3gbd6I
Hvis dette er sant, er den eneste åpenbare løsningen å trenere modellen på nytt, med eksklusjon av ikke-realistle menneskebasert innhold, og sikre at ekte tilfeller av utelating (dvs. amputerte personer) er tilstrekkelig etikettert som unntak. Fra et datakureringssynspunkt alene, ville dette være en ganske stor utfordring, særlig for ressurs-svake samfunnsinnsats.
Den andre tilnærmingen ville være å anvende filtre som ekskluderer slike innhold (dvs. ‘hånd med tre/fem fingre’) fra å manifestere seg ved render-tid, på samme måte som OpenAI har, til en viss grad, filtrert GPT-3 og DALL-E 2, så at deres utdata kunne reguleres uten å trenere kilodemodellene på nytt.

For Stable Diffusion, kan den semantiske distinksjonen mellom digitene og selv lemmer bli forferdelig utydelig, og minner om 1980-årenes ‘kropps-skrekk’-genre av skrekkfilmer fra likeså David Cronenberg. Kilde: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
Det kan argumenteres for at det er to gjenværende veier fremover: å kaste mer data på problemet, og å anvende tredjeparts-tolkende systemer som kan intervenere når fysiske feil av den type beskrevet her presenteres til sluttbrukeren (i det minste ville dette gi OpenAI en metode for å gi refusjoner for ‘kropps-skrekk’-renderinger, hvis selskapet var motivert til å gjøre det).
3: Tilpasning
En av de mest spennende mulighetene for fremtiden av Stable Diffusion er prospekten av at brukere eller organisasjoner utvikler reviderte systemer; modifikasjoner som tillater innhold utenfor det forhåndstrente LAION-sfæren å bli integrert i systemet – ideal sett uten den ustyrlige utgift av å trenere hele modellen på nytt, eller risikoen som er involvert når man trener i en stor volum av nye bilder til en eksisterende, moden og kapabel modell.
Ved analogi: hvis to mindre begavede studenter slutter seg til en avansert klasse på tretti studenter, vil de enten assimilere og holde tritt, eller feile som outliers; i begge tilfeller vil klasse-gjennomsnittsprestasjonen sannsynligvis ikke bli påvirket. Hvis femten mindre begavede studenter slutter seg til, er klasse-kurven for hele klassen sannsynligvis å lide.
Tilsvarende, kan den symbiotiske og ganske ømfintlige nettverket av relasjoner som bygges opp over langsiktig og kostbar modell-trening, bli kompromittert, i noen tilfeller effektivt ødelagt, av overflødig ny data, og senke utgangskvaliteten for modellen over hele linjen.
Tilfelle for å gjøre dette er primært der din interesse ligger i å fullstendig kapre modellens konseptuelle forståelse av relasjoner og ting, og å appropriere det for eksklusiv produksjon av innhold som er likt det nye materialet du la til.
Således, å trenere 500 000 Simpsons-rammer inn i en eksisterende Stable Diffusion-checkpoint, er sannsynligvis, til slutt, å få en bedre Simpsons-simulator enn den originale bygningen kunne ha tilbudt, under forutsetning av at tilstrekkelige brede semantiske relasjoner overlever prosessen (dvs. Homer Simpson spiser en hotdog, som kan kreve materiale om hotdogs som ikke var i ditt tilleggsmateriale, men som allerede eksisterte i checkpointet), og under forutsetning av at du ikke ønsker å plutselig bytte fra Simpsons-innhold til å lage fabulous landskap av Greg Rutkowski – fordi din post-trente modell har hatt sin oppmerksomhet massivt avledet, og ikke vil være like god til å gjøre den type ting som den var før.
Et bemerkelsesverdig eksempel på dette er waifu-diffusion, som har suksessfullt post-trent 56 000 anime-bilder inn i en fullstendig trent Stable Diffusion-checkpoint. Det er en tøff prospekt for en hobbyist, da modellen krever en øyeåpnende minimum på 30 GB VRAM, langt utenfor hva som sannsynligvis vil være tilgjengelig på forbrukernivå i NVIDIA’s kommende 40XX-serie utgivelser.

Treningen av tilpasset innhold inn i Stable Diffusion via waifu-diffusion: modellen tok to uker med post-trening for å produsere dette nivået av illustrasjon. De seks bildene til venstre viser fremgangen i modellen, ettersom treningen fortsatte, i å lage subjekt-kohrent utdata basert på den nye treningdataen. Kilde: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
En stor innsats kan bli brukt på slike ‘forker’ av Stable Diffusion-checkpoint, bare for å bli hindret av teknisk gjeld. Utviklere på det offisielle Discord har allerede indikert at senere checkpoint-utgivelser ikke nødvendigvis vil være bakover-kompatible, selv med prompt-logikk som kan ha fungert med en tidligere versjon, da deres primære interesse er å få den beste modellen mulig, snarere enn å støtte legacy-applikasjoner og prosesser.
Derfor har et selskap eller enkeltperson som bestemmer seg for å forkaste en checkpoint til en kommersiell produkt, ingen vei tilbake; deres versjon av modellen er, på det tidspunktet, en ‘hard fork’, og vil ikke kunne trekke inn upstream-fordeler fra senere utgivelser fra stability.ai – som er en ganske stor forpliktelse.
Den nåværende, og større håpet for tilpasning av Stable Diffusion, er tekstuell inversjon, hvor brukeren trener inn et lite antall CLIP-justerte bilder.

Et samarbeid mellom Tel Aviv Universitet og NVIDIA, tekstuell inversjon tillater trening av diskrete og nye enheter, uten å ødelegge evnene til kilodemodellen. Kilde: https://textual-inversion.github.io/
Den primære åpenbare begrensningen av tekstuell inversjon er at et svært lavt antall bilder anbefales – så få som fem. Dette produserer effektivt en begrenset enhet som kan være mer nyttig for stil-overføringsoppgaver enn for innføring av fotorealistiske objekter.
Likevel, eksperimenterer noen Stable Diffusion Discords med mye høyere antall treningbilder, og det återstår å se hvor produktiv metoden kan vise seg å være. Igjen, krever teknikken en stor mengde VRAM, tid og tålmodighet.
På grunn av disse begrensningene, kan vi måtte vente en stund for å se noen av de mer avanserte tekstuelle inversjons-eksperimentene fra Stable Diffusion-entusiaster – og om eller ikke denne tilnærmingen kan ‘sette deg i bildet’ på en måte som ser bedre ut enn en Photoshop-klipp-og-lim-inn, samtidig som den beholder den forbløffende funksjonaliteten til de offisielle checkpointene.
Først publisert 6. september 2022.


