
Andersons vinkel
GAN som verktøy for gjengivelse av ansikter i tradisjonell CGI

 Legg til Unite.AI blant dine foretrukne kilder på Google

Viktige punkterÅ skille identitet fra uttrykk i GANs latente rom forblir den sentrale uløste…
Vis mer
- Å skille identitet fra uttrykk i GANs latente rom forblir den sentrale uløste utfordringen for ansiktsvideosyntese.
- Parametriske CGI-modeller som SMPL og 3DMM-er blir i økende grad brukt for å påtvinge orden på GAN-ers uregjerlige latente koder.
- Disneys Rendering with Style hybridtilnærming ga uhyggelige resultater ved å slå sammen tradisjonelle teksturkart med GAN-generert bilder.
MeningDa Generative Adversarial Networks (GANs) først demonstrerte sin evne til å gjenskape slående realistiske 3D-ansikter, utløste dette en gullrush for det uutnyttede potensialet for GANs til å skape tidsmessig konsistente videoer med menneskeansikter.
Et sted i GANs latente rom, syntes det at det må være skjult orden og rasjonalitet – en begynnende struktur av semantisk logikk, skjult i de latente kodene, som ville tillate en GAN å generere konsistente flere visninger og tolkninger (såsom endringer i uttrykk) av det samme ansiktet – og deretter tilby en tidsmessig overbevisende deepfake-video-metode som ville utkonkurrere autoencodere.
Høyoppløselig utdata ville være trivialt sammenlignet med de lavoppløselige miljøene som GPU-begrensninger tvinger DeepFaceLab og FaceSwap til å operere i, mens “området for utveksling” av et ansikt (i autoencoder-arbeidsflyter) ville bli “skapingsområdet” for en GAN, informert av en håndfull inndatabilder eller selv bare ett enkelt bilde.
Det ville ikke være noe misforhold lenger mellom “utveksling” og “vert” ansikter, fordi hele bildet ville bli generert fra grunnen av, inkludert hår, kjevelinjer og de ytre ytterpunktene av ansiktslinjene, som ofte viser seg å være en utfordring for “tradisjonelle” autoencoder-deepfakes.
GAN-ansiktsvideo-vinteren
Det viste seg å være mye vanskeligere enn det. Til slutt viste disentanglement seg å være det sentrale problemet, og er fremdeles det primære utfordringen. Hvordan kan du holde et distinkt ansiktsidentitet, og endre posen eller uttrykket uten å samle sammen en korpus av tusenvis av referansebilder som lærer en neural nettverk hva som skjer når disse endringene blir gjennomført, på samme måte som autoencoder-systemer så møysommelig gjør?
I stedet var det påfølgende tenking i ansiktsanimasjon med GAN og syntese-forskning at en innputt-identitet kanskje kunne gjøres til et mål for teleologiske, generiske, malbaserte transformasjoner som ikke er identitetsspesifikke. Et eksempel på dette ville være å anvende et uttrykk på et GAN-ansikt som ikke var til stede i noen av bildene av personen som GAN kjenner til.

Fra 2022-studien Tensor-based Emotion Editing in the StyleGAN Latent Space, blir malbaserte uttrykk anvendt på et innputt-ansikt fra FFHQ-datasettet. Kilde: https://arxiv.org/pdf/2205.06102.pdf
Det er åpenbart at en “en størrelse passer alle”-tilnærming ikke kan dekke mangfoldet av ansiktsuttrykk som er unikt for en enkelt person. Vi må undre oss på om et smil så unikt som Jack Nicholsons eller Willem Dafoes noen gang kunne motta en trofast tolkning under påvirkning av slike “gjennomsnittlige uttrykk”-latente koder.

Hvem er denne charmerende latinske fremmede? Selv om GAN-metoden produserer et mer realistisk og høyoppløselig ansikt, er transformasjonen ikke informert av multiple virkelige bilder av skuespilleren, som er tilfelle med DeepFaceLab, som trener omfattende på en database av tusenvis av slike bilder, og derfor er likheten kompromittert. Her (bakgrunn) er et DeepFaceLab-modell importert til DeepFaceLive, en strømmingsimplementering av den populære og kontroversielle programvaren. Eksempler er fra https://www.youtube.com/watch?v=9tr35y-yQRY (2022) og https://arxiv.org/pdf/2205.06102.pdf.
Et antall GAN-ansiktsuttrykk-redigeringsverktøy har blitt fremmet over de siste årene, de fleste av dem behandler ukjente identiteter, hvor trofastheten av transformasjonene er umulig for den vanlige leseren å vite, siden disse er ikke kjente ansikter.

Ukjente identiteter transformert i 2020-tilbudet Cascade-EF-GAN. Kilde: https://arxiv.org/pdf/2003.05905.pdf
Kanskje det GAN-ansiktsredigeringsverktøyet som har mottatt mest interesse (og siteringer) de siste tre årene er InterFaceGAN, som kan utføre latente rom-gjennomløp i latente koder relatert til positur (kameraets eller ansiktets vinkel), uttrykk, alder, rase, kjønn og andre essensielle kvaliteter.
1980-årenes “morphing”-evner i InterFaceGAN og lignende rammer er hovedsakelig en måte å illustrere veien mot transformasjon som et bilde projiseres tilbake gjennom en passende latent kode (såsom “alder”). Når det gjelder å produsere videoopptak med tidsmessig kontinuitet, kvalifiserer slike skjemaer til dags dato som “imponerende katastrofer”.
Hvis du legger til det vanskeligheten med å skape tidsmessig konsistente hår, og det faktum at teknikken for latent kode-utforskning/håndtering ikke har noen innebygde tidsmessige retningslinjer å jobbe med (og det er vanskelig å vite hvordan man kan innføre slike retningslinjer i en ramme designet for å akseptere og generere stillbilder, og som ikke har noen innebygd støtte for video-utdata), kan det være logisk å konkludere at GAN ikke er All You Need™ for ansiktsvideo-syntese.
Derfor har påfølgende innsats ført til inkrementelle forbedringer i disentanglement, mens andre har boltet på andre konvensjoner i maskinsyn som en et veiledningslag, såsom bruken av semantisk segmentering som en kontrollmekanisme i studien fra slutten av 2021, papiret SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing.
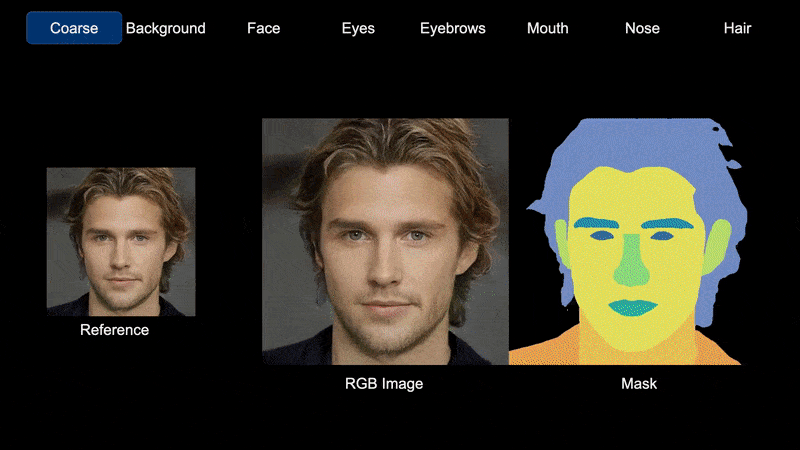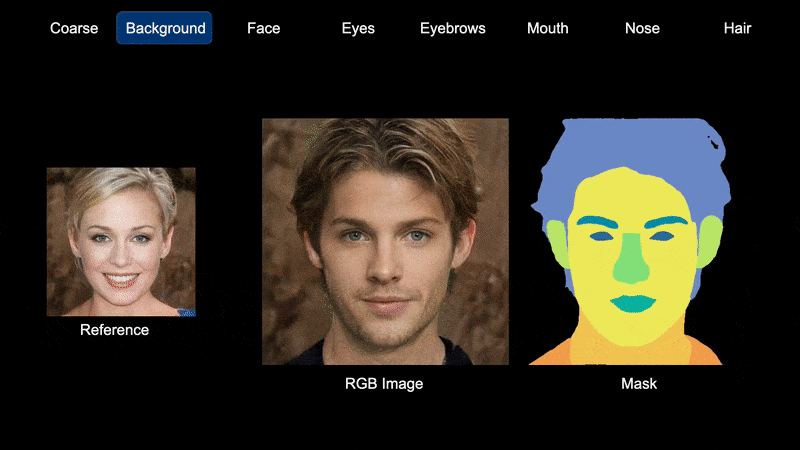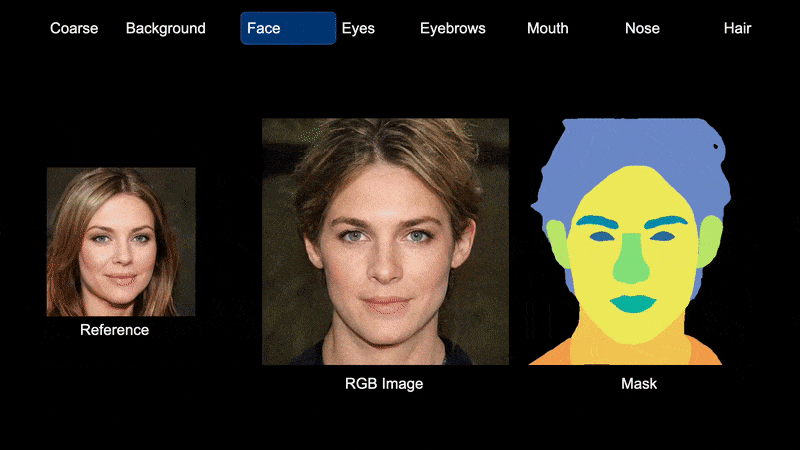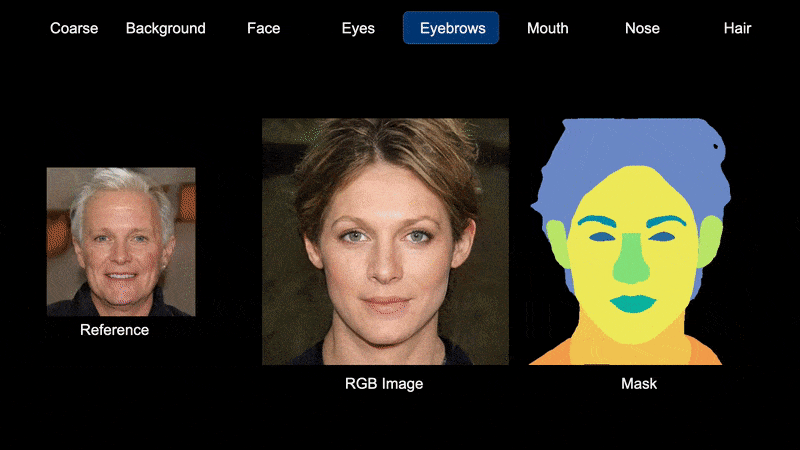
Semantisk segmentering som en metode for kontroll over det latente rommet i SemanticStyleGAN. Kilde: https://semanticstylegan.github.io/
Parametrisk veiledning
GAN-ansikts-syntese-forskningsmiljøet går stadig mer mot å bruke “tradisjonelle” parametrisk CGI-ansikter som en metode for å guide og bringe orden til de imponerende, men ustyrlige, latente kodene i et GANs latente rom.
Selv om parametrisk ansikts-primitiver har vært en standard i maskinsynsforskning i over tyve år, har interessen for denne tilnærmingen økt nylig, med økt bruk av Skinned Multi-Person Linear Model (SMPL) CGI-primitiver, en tilnærming som ble innført av Max Planck-instituttet og ILM, og siden forbedret med Sparse Trained Articulated Human Body Regressor (STAR)-rammen.

SMPL (i dette tilfellet en variant kalt SMPL-X) kan pålegge en CGI-parametrisk mesh som stemmer overens med den estimerte posen (inkludert uttrykk, hvis nødvendig) av hele menneskekroppen i et bilde, og tillate nye operasjoner å utføres på bildet ved hjelp av den parametrisk meshen som en volumetrisk eller perseptuell retningslinje. Kilde: https://arxiv.org/pdf/1904.05866.pdf
Den mest anerkjente utviklingen i denne linjen har vært Disneys 2019 Rendering med stil-initiativet, som slo sammen bruken av tradisjonelle teksturer med GAN-generert bilde, i et forsøk på å skape forbedret, “deepfake-liknende” animert utdata.

Gammelt møter nytt i Disneys hybridtilnærming til GAN-genererte deepfakes. Kilde: https://www.youtube.com/watch?v=TwpLqTmvqVk
Disneys tilnærming legger tradisjonelt gjengitte CGI-elementer inn i et StyleGAN2-nettverk for å fylle inn menneskeansikter i “problematisk” områder, hvor tidsmessig konsistens er et problem for video-generering – områder som hudtekstur.

Rendering med stil-arbeidsflyten.
Siden den parametrisk CGI-hodet som guider denne prosessen kan justeres og endres for å tilpasse brukeren, kan GAN-generert ansikt reflektere disse endringene, inkludert endringer i hodeposisjon og uttrykk.
Selv om metoden skal forene kontrollen i CGI med GAN-ansiktenes naturlige realisme, viser resultatene det verste fra begge verdener. De klarer fortsatt ikke å holde hårteksturen eller selv plasseringen av grunnleggende ansiktstrekk konsistent:
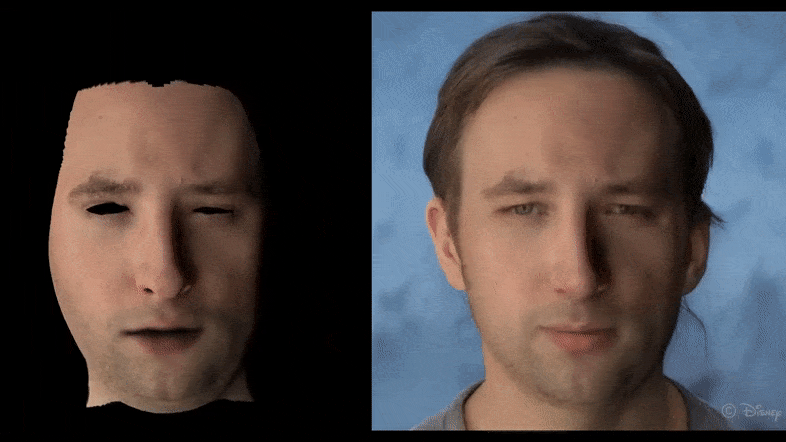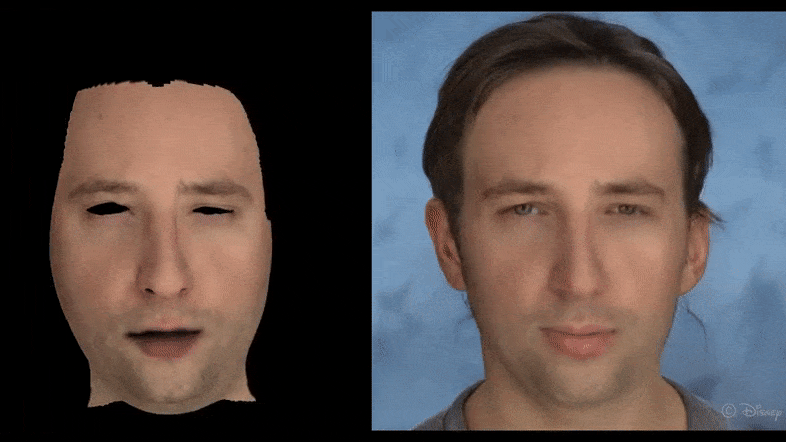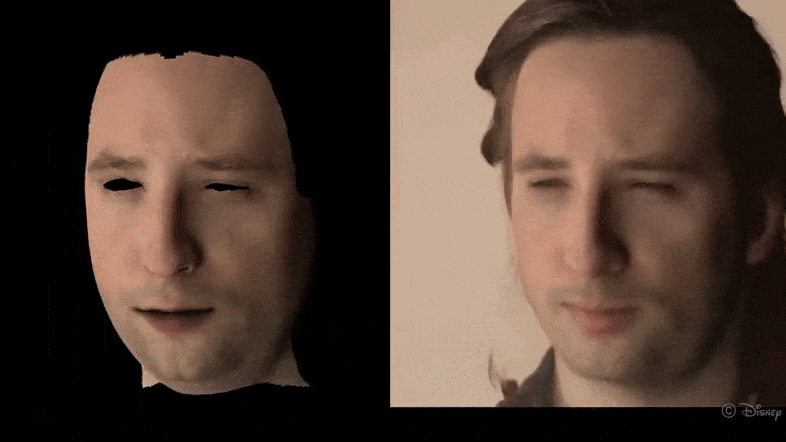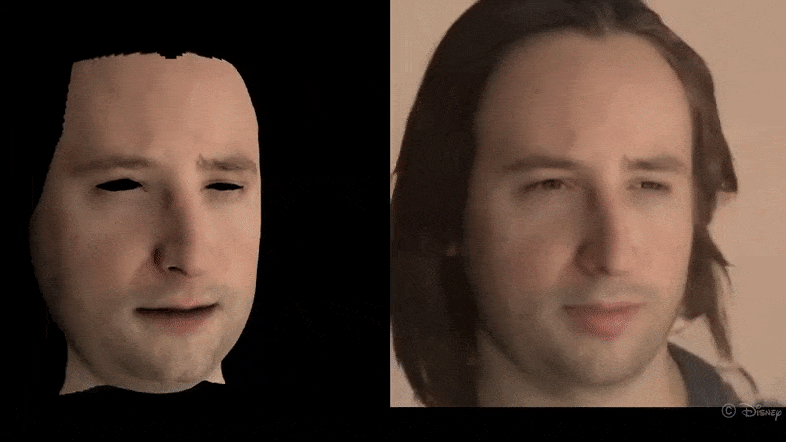
En ny type uncanny valley oppstår fra Rendering med stil, selv om prinsippet fortsatt har noen potensial.
2020-papiret StyleRig: Rigging StyleGAN for 3D Control over Portrait Images tar en stadig mer populær tilnærming, med bruk av tredimensjonale formbare ansiktsmodeller (3DMMs) som stedfortredere for å endre egenskaper i en StyleGAN-miljø, i dette tilfellet gjennom et nytt rigging-nettverk kalt RigNet:

3DMMs står som stedfortredere for latente rom-tolkninger i StyleRig. Kilde: https://arxiv.org/pdf/2004.00121.pdf
Men, som vanlig med disse initiativene, ser resultater til dags dato ut til å være begrenset til minimale pose-manipulasjoner, og “uinformerte” uttrykk/affekt-endringer.

StyleRig forbedrer kontrollnivået, selv om tidsmessig konsistent hår fortsatt er en uløst utfordring. Kilde: https://www.youtube.com/watch?v=eaW_P85wQ9k
Lignende utdata kan finnes fra Mitsubishi Researchs MOST-GAN, en 2021 papir som bruker ikke-lineære 3DMMs som en disentanglement-arkitektur, men som også kjemper for å oppnå dynamisk og konsistent bevegelse.
Den siste forskningen som forsøker å kombinere kontroll og adskillelse av faktorer er One-Shot Face Reenactment on Megapixels, som igjen bruker 3DMM-parametrisk hoder som en vennlig grensesnitt for StyleGAN.

I MegaFR-arbeidsflyten til One-Shot Face Reenactment, utfører nettverket ansikts-syntese ved å kombinere et virkelig bilde som er invertert til en latent representasjon med parametre tatt fra en rendret 3DMM-modell. Kilde: https://arxiv.org/pdf/2205.13368.pdf
OSFR tilhører en voksende klasse av GAN-ansiktsredigeringsverktøy som søker å utvikle Photoshop/After Effects-liknende lineære redigerings-arbeidsflyter hvor brukeren kan sette inn et ønsket bilde som transformasjoner kan anvendes på, i stedet for å jakte gjennom det latente rommet for latente koder relatert til en identitet.
Igjen representerer parametrisk uttrykk en overordnet og upersonlig metode for å innføre uttrykk, som fører til manipulasjoner som synes uhyggelige på deres egen, ikke alltid positive måte.

Injicerte uttrykk i OSFR.
Liksom tidligere arbeid kan OSFR inferere nære originale posisjoner fra ett enkelt bilde, og også utføre “frontalisering”, hvor et bilde av et ansikt sett fra siden omdannes til et frontalt portrett:

Originalt (øverst) og utledede frontale portretter fra en av implementeringene av OSFR detaljert i den nye papiren.
I praksis er denne type inferens lignende noen av de fotogrammetriske prinsippene som ligger til grunn for Neural Radiance Fields (NeRF), bortsett fra at geometrien her må defineres av ett enkelt bilde, i stedet for de 3-4 synspunktene som tillater NeRF å tolke de manglende interstitielle posisjonene og skape utforskbar neural 3D-scene med mennesker.
(Men NeRF er heller ikke All You Need™, siden det bærer på en nesten helt annet sett med hindringer enn GANs når det gjelder å produsere ansiktsvideo-syntese)
Har GAN en plass i ansiktsvideo-syntese?
Å oppnå dynamiske uttrykk og positurer utenfor treningsfordelingen fra ett enkelt kildebilde synes å være en alkymilignende besettelse i GAN-ansikts-syntese-forskning for øyeblikket, hovedsakelig fordi GANs er den eneste metoden som for øyeblikket kan produsere ganske høyoppløselige og relativt høykvalitets neurale ansikter: selv om autoencoder-deepfake-rammer kan trene på en mengde virkelige posisjoner og uttrykk, må de operere på VRAM-begrensede inndata/utdata-oppløsninger, og krever en “vert”; mens NeRF er lignende begrenset, og – i motsetning til de to andre tilnærmingene – har for øyeblikket ingen etablerte metoder for å endre ansiktsuttrykk, og lider av begrenset redigerbarhet generelt.
Det ser ut til at den eneste måten fremover for et nøyaktig CGI/GAN-ansikts-syntese-system er for et nytt initiativ å finne en måte å samle sammen en multi-bilde identitet-entitet innenfor det latente rommet, hvor en latent kode for en persons identitet ikke trenger å reise hele veien over det latente rommet for å utnytte urelaterte positurparametere, men kan henvise til sine egne relaterte (virkelige) bilder som referanser for transformasjoner.
Selv i et slikt tilfelle, eller selv om hele StyleGAN-nettverket ble trent på ett enkelt-identitets ansiktssett (lignende de treningssettene som autoencodere bruker), ville den manglende semantiske logikken fortsatt sannsynligvis trenge å bli supplert med hjelpeteknologier som semantisk segmentering eller parametrisk 3DMM-ansikter, som, i et slikt scenario, ville i hvert fall ha mer materiale å jobbe med.


