
Andersons vinkel
En maskinlæringsmodell for å omskrive en artikkel mens du leser den

 Legg til Unite.AI blant dine foretrukne kilder på Google
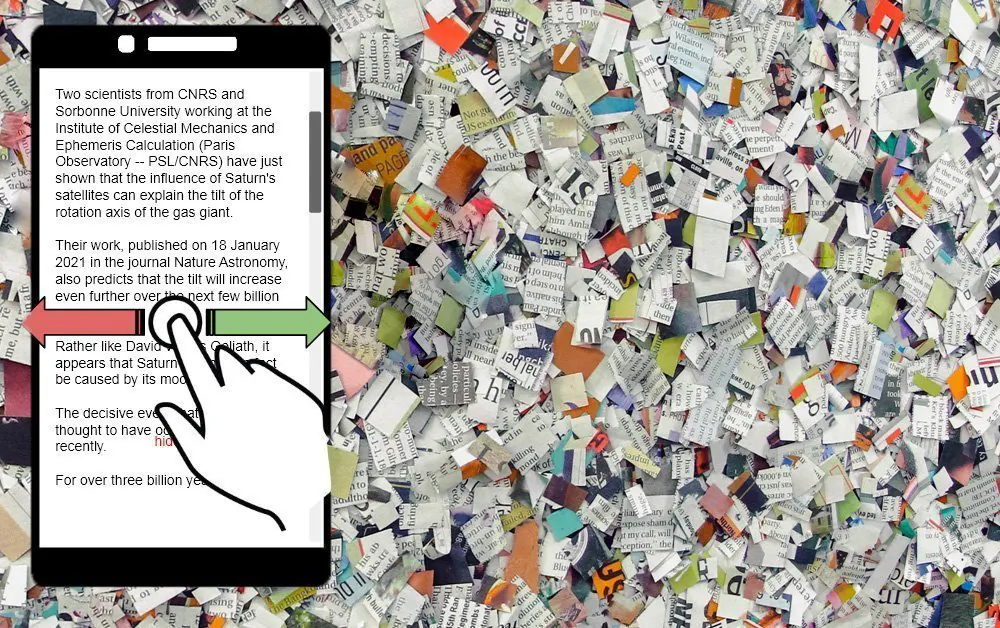
Ny forskning fra Canada foreslår en metode for å automatisk omskrive en artikkel mens du leser den, basert på Tinder-liknende “swiping” eller på passiv observasjon av lesers interaksjon med ulike typer innhold i artikkelen.
Systemet, kalt Hone As You Read (HARE), presenteres i en artikkel fra Western University i Ontario, Canada, med tilhørende Python-kode på GitHub.
Den sentrale ideen bak prosjektet er at en artikkel kan inneholde ulike typer innhold, som utvikler seg (lik som denne) fra overskriften ned til videre detaljer. Senere deler av en artikkel kan inneholde ulike typer støtteinnhold, brukstilfeller eller hypoteser eller antagelser om konsekvensene av nyheten.
Under HARE, hvis du ikke liker denne typen materiale, kan du stemme det bort på en paragraf-for-paragraf-basis mens systemet lærer dine preferanser, så at når du scroller ned, innhold som ligner materialet du “nedstemte” har allerede blitt fjernet eller omskrevet. Hvis du ikke ønsker å aktivt delta i å trene systemet, kan HARE slutte dine valg ved å observere dine passive interaksjoner med dokumentet.
Tinder-liknende avstemning for mislikte setninger
I bildet under ser vi tre mulige typer inferert kategorisering for HARE, basert på brukerens eksplisitte eller implisitte atferd. I det første tilfelle (venstre), bruker brukeren aktivt “swiper til venstre” (eller høyre), i en Tinder-liknende avstemningsgest som uttrykker godkjenning eller misnøye med innholdet i paragrafen eller setningen, eller i dens stil, kompleksitet eller tone.

Kilde: https://arxiv.org/pdf/2105.02923.pdf
I det andre tilfelle (midten), bruker systemet dwell-time som en målestokk for brukerens interesse, basert på posisjonen og varigheten av scroll-pause.
I det tredje tilfelle (høyre), bruker HARE smartphone-kameraet til å anslå banen og dwell-time for brukerens blikksted over paragrafene i det synlige dokumentet.
Forskerne hevder at økt dwell-time på en paragraf kan indikere økt brukerinteresse, selv om dette logisk sett ikke alltid er tilfelle der brukeren prøver å assimilere tekst som kan være komplisert eller bare dårlig skrevet.

Brukerfeedback redigerer, omskriver eller sletter helt usette deler av artikkelen.
Forbehandling av innhold til brukerens preferanser
Artikkelen omhandler brukeropplevelsen av HARE på en per-artikkel-basis, men det er tydelig at brukerens historiske interaksjon med dokumenter tillater for tilpasning av fremtidige leseopplevelser, ved å konsistent gjenkjenne typer innhold og anvende malte brukerpreferanser til nye artikler, så at behovet for interaksjon minsker når brukeren ser mindre og mindre “uønsket” innhold.
HARE karakteriseres som en summeringsalgoritme, som tillater at usette deler av artikkelen lenger ned på siden kan omskriveres i stil eller konsisjon før brukeren kommer til det; men artikkelen gjør det klart at det også kan forhåndsvis fjerner innhold basert på brukerfeedback.
Til testformål brukte systemet en korpus på 11 222 artikler fra UKs Daily Mail-avis, og ble evaluert via en testutgivelse på Telegram-chatappen. Artikler med mindre enn ti paragrafer ble forkastet for prøveformål.

Telegram HARE-appen i en testfase med brukere.
Forskerne sin metode bruker K-Means-clustering på SBERT-setnings-embeddings i artiklene, med tilfeldige vekter for konsepter som behandles.
Blant en rekke algoritmer og tilnærminger, har HARE tre sammenligningsmodeller, den første av disse (ORACLEGREEDY) har tilgang til tidligere brukerpreferanser, som indikerer at algoritmen kunne forhåndsgjøre artikler på lasting, i stedet for interaktivt.
De andre modellene, ORACLESORTED og ORACLEUNIFORM, velger setninger basert på interesse eller tilfeldig gjennom artikkelen.
Innholdsfjerning og omskriving
Overraskende nok overgikk ORACLEUNIFORM kontrollsettet, selv om det ikke har tilgang til tidligere brukerinteresser. Forskerne hevder at dette skyldes at det behandler hele artikkelen i ett sveip, “velger bare de mest interessante setningene”. Forskerne innrømmer at dette kan begrense det tilgjengelige innholdet til setninger som behandler kun det viktigste konseptet, logisk fjerner annet tekst som kan behandle konsekvenser eller evaluering av konseptet.
De ekstraktive summeringsalgoritmer som brukes i HARE er LexRank, SumBasic og TextRank.
HARE ble testet på 13 frivillige over en periode på 70 forsøk og varierende algoritmer, og kunne oppdatere summeringer (omskrevet/utskåret tekst) på mellom 1,3 millisekunder og 100 ms på en forbrukergrads laptop, avhengig av modellen som ble testet. Resultatene viste at modellene som fjernet mest tekst ikke fungerte bra, hovedsakelig fordi dette kan påvirke kohesjonen i den gjenværende teksten.
Etiske implikasjoner av dynamisk artikkelomskriving
Forskerne erkjenner etiske bekymringer rundt teknologier av denne typen:
‘HARE-oppdraget er ment for design av fremtidige brukerorienterte applikasjoner. Ved design har disse applikasjonene evnen til å kontrollere hva en bruker leser fra en gitt artikkel. Det er mulig at, når de deployeres uten tilstrekkelig omsorg, disse verktøyene kunne forverre “eko-kammer”-effekten som allerede produseres av automatiserte nyhetsstrømmer, søkeresultater og nett-samfunn.’
Men de noterer også at et slikt system kunne brukes i fremtidige applikasjoner til å mildne “eko-kammer”-effekten ved å injisere tekst som foreslår alternative synspunkter som kanskje ikke var til stede i artikkelen fra begynnelsen. De observerer: ‘Vektingen av denne faktoren kunne justeres for å gi både en engasjerende leseopplevelse og eksponering for en mangfoldighet av ideer.’
De som sannsynligvis vil dra nytte av et slikt system, ifølge forskerne, er lesere som ønsker å spare tid på å ta inn informasjon, og innholdspublisister.


