
AI-basisprincipes
Wat is Gefedereerd Leren?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
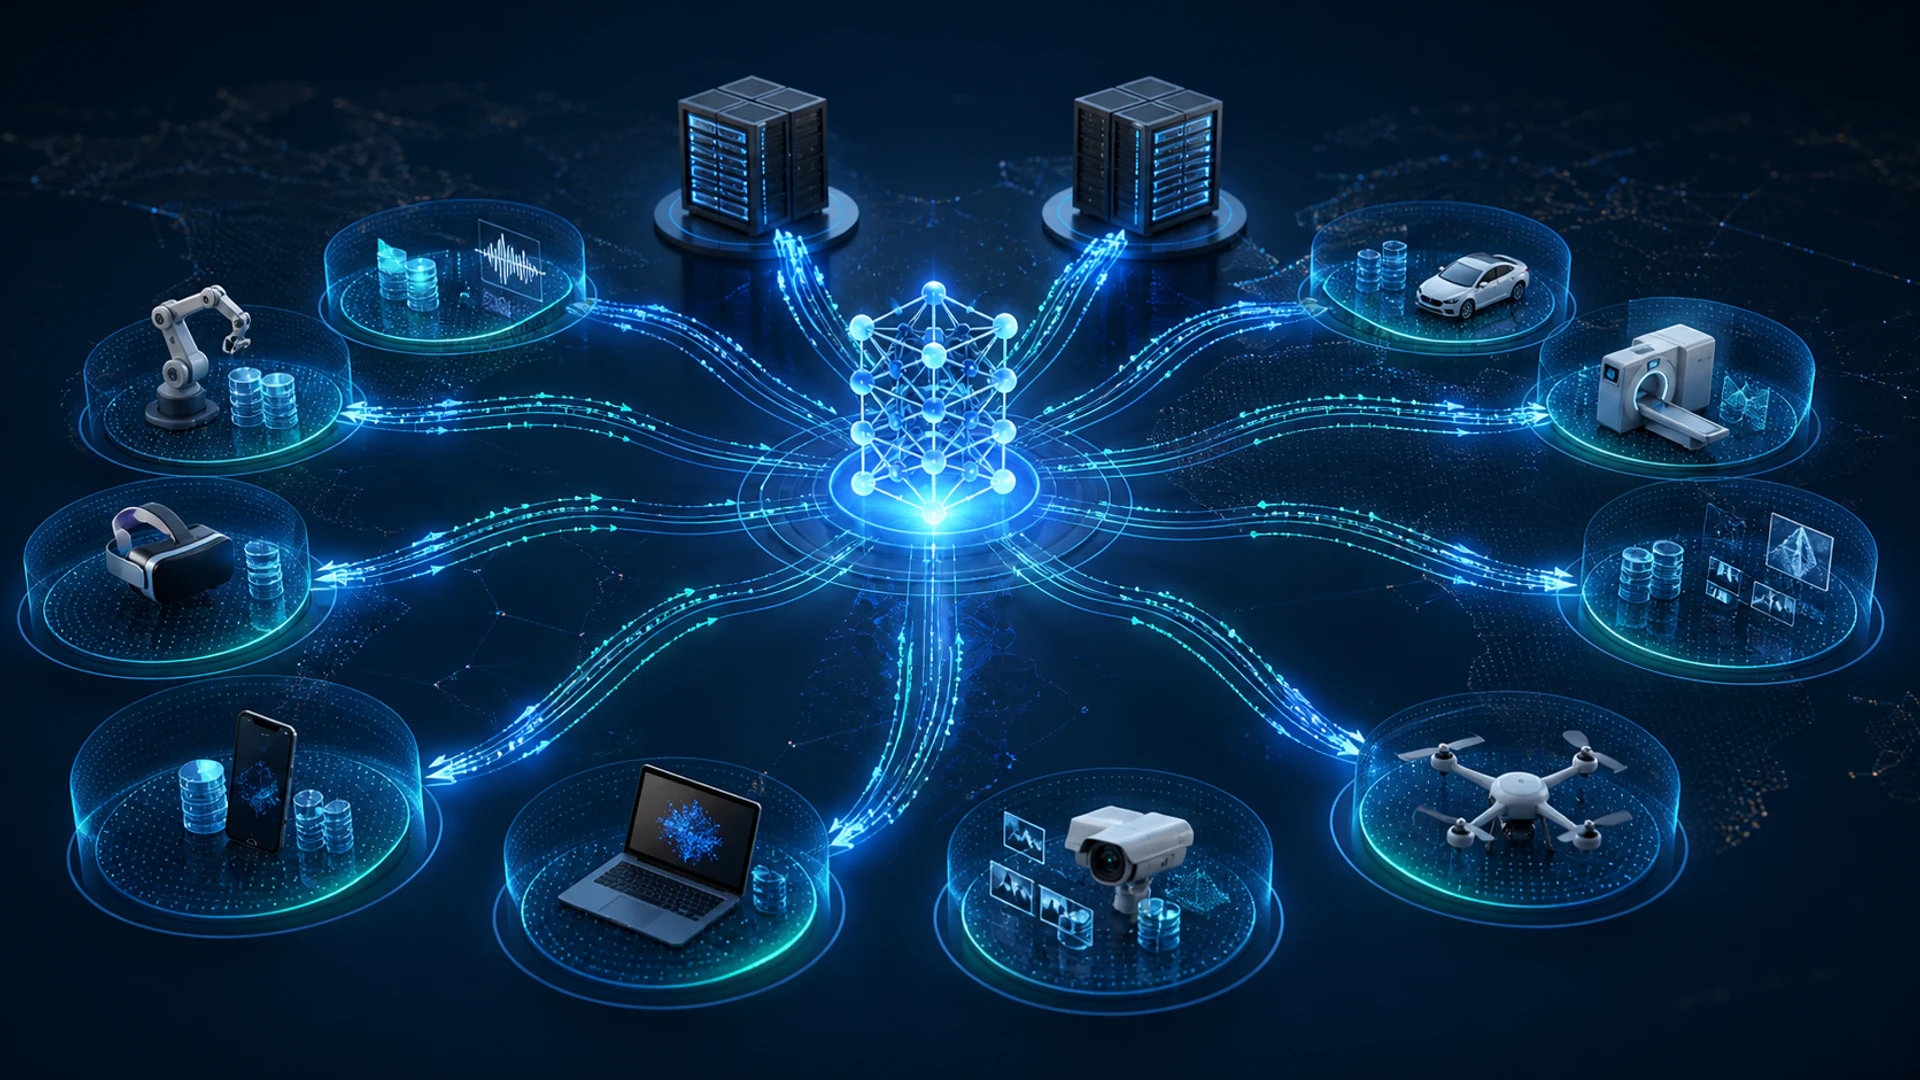
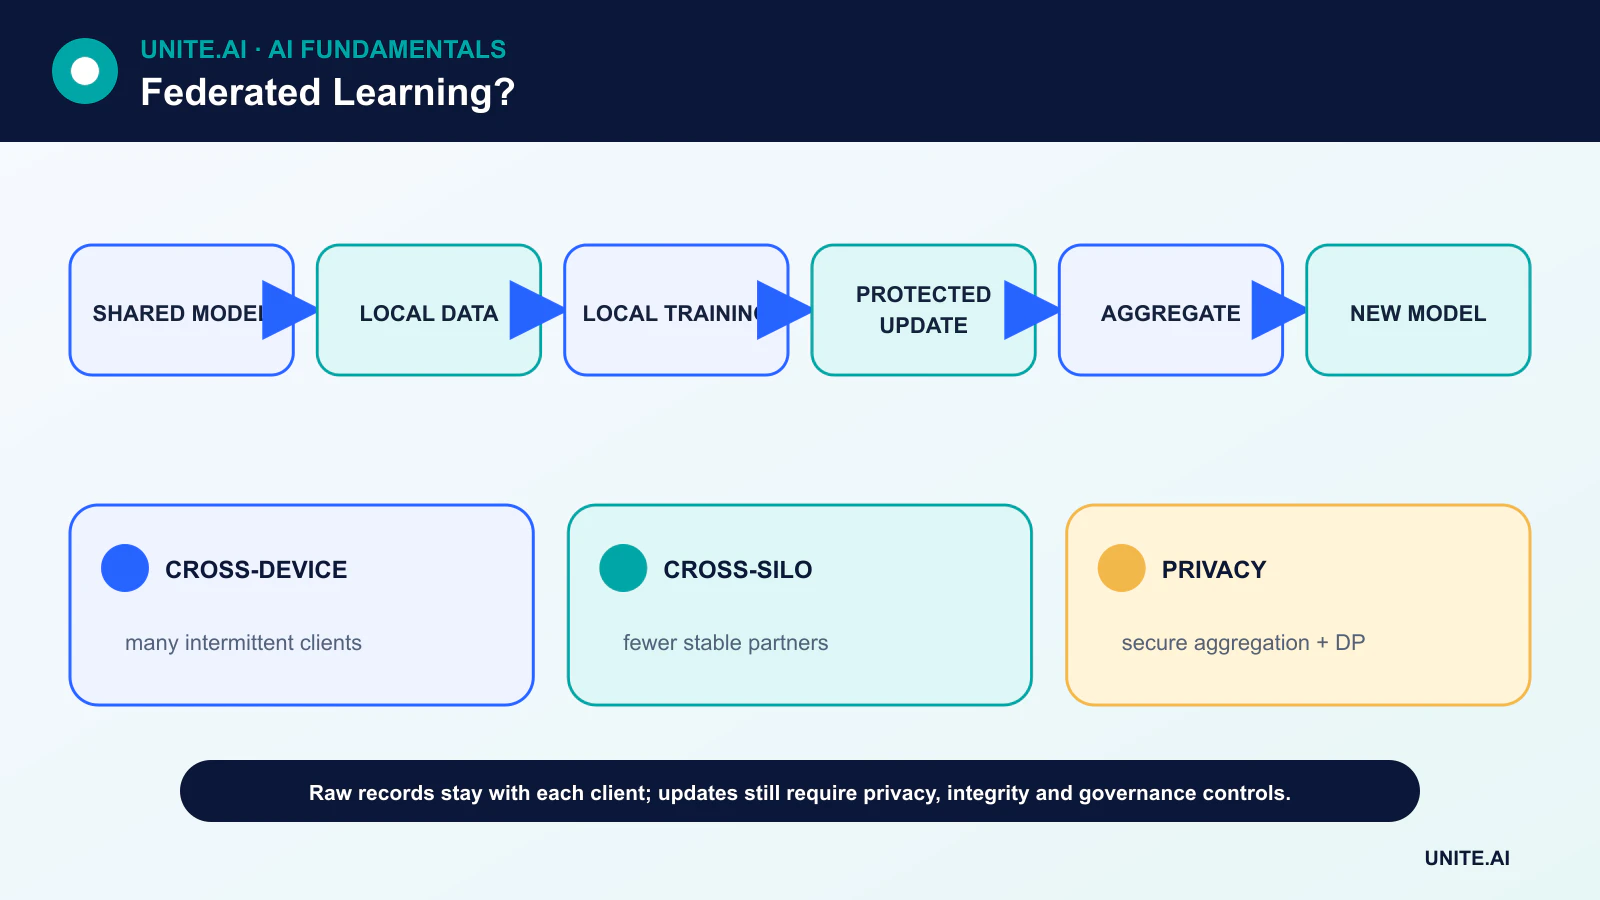
Gefedereerd leren traint een gedeeld model over meerdere apparaten of organisaties, terwijl de ruwe trainingsgegevens van elke deelnemer lokaal blijven. Een coördinator verdeelt modelparameters, clients berekenen updates op hun eigen gegevens, en een aggregatiestap combineert die updates.
Het lokaal houden van gegevens is nuttig, maar het is niet synoniem met privacy of beveiliging. Modelupdates kunnen informatie lekken, gecompromitteerde clients kunnen de training vergiftigen, en de coördinator heeft nog steeds authenticatie, transportbeveiliging, toegangscontroles en een gedefinieerd vertrouwensmodel nodig.
Belangrijkste punten
- Gefedereerd leren verplaatst de berekening naar gedistribueerde data; het verplaatst de ruwe dataset niet naar één centrale trainer.
- Cross-device systemen omvatten veel intermitterende apparaten, terwijl cross-silo systemen minder, meer stabiele organisaties omvatten.
- Veilige aggregatie en differentiële privacy pakken verschillende risico’s aan en kunnen gecombineerd worden.
- Niet‑IID data, beperkte bandbreedte, onbetrouwbare deelname en kwaadwillende updates zijn kernontwerpelementen.
De levenscyclus van gefedereerde averaging
Een typische ronde begint wanneer een coördinator in aanmerking komende clients selecteert en het huidige model verstuurt. Elke client traint lokaal voor een beperkt aantal stappen, waardoor een parameter‑ of gradient‑update ontstaat. De coördinator aggregeert de in aanmerking komende updates — vaak met gewichten op basis van het lokale aantal voorbeelden — en publiceert het nieuwe gedeelde model.
Slechts een fractie van de clients kan in elke ronde deelnemen. Het protocol moet verbroken verbindingen, versie‑mismatches en apparaten die niet kunnen trainen tijdens opladen, bezet of offline zijn, tolereren. Communicatie kan de berekening domineren, dus update‑compressie en minder rondes zijn vaak belangrijker dan de ruwe versnellersnelheid.
Cross-device versus cross-silo
Cross-device gefedereerd leren kan telefoons, sensoren of browsers omvatten die eigendom zijn van veel individuen. Clients zijn talrijk, zwak vertrouwd en slechts periodiek beschikbaar. Cross-silo gefedereerd leren verbindt meestal een kleinere groep ziekenhuizen, banken of bedrijfseenheden met stabiele infrastructuur en contractuele governance.
De twee omgevingen vereisen verschillende aannames over identiteit, audit en falen. Een cross-silo project kan een gedeeld schema en validatieproces onderhandelen; een cross-device dienst moet mogelijk miljoenen software‑versies en sterk ongelijke lokale datasets verwerken.
Veilige aggregatie, differentiële privacy en encryptie
Veilige aggregatie is een cryptografisch protocol dat de server een aggregaat laat herstellen zonder elke client‑update te lezen. Differentiële privacy beperkt hoeveel het vrijgegeven resultaat kan afhangen van één record of deelnemer door bijdragen te clippen en gekalibreerd ruis toe te voegen.
Geen van beide mechanismen lost elk risico op. Veilige aggregatie maakt het aggregaat niet onschadelijk, en differentiële privacy legt een nauwkeurigheid‑privacy‑afweging op die moet worden meegenomen met een expliciet privacybudget. Encryptie beschermt gegevens tijdens transport of opslag; het voorkomt op zichzelf geen inferentie vanuit een model.
Niet‑IID data en modelkwaliteit
Cliëntdata zijn zelden onafhankelijk en identiek verdeeld. Een toetsenbordmodel ziet de woordenschat van elke persoon; ziekenhuizen bedienen verschillende populaties; fabrieken gebruiken verschillende apparatuur. Deze verschillen kunnen de convergentie vertragen en slechte prestaties voor kleine clientgroepen verbergen.
Evaluatie moet globale metrics, per‑client of cohort‑distributies, calibratie en faalanalyse omvatten. Een centrale testset kan handig zijn, maar is onvoldoende. Dit verbindt gefedereerd leren aan machine‑learning datakwaliteit en gestructureerde en ongestructureerde data governance.
Bedreigingen en operationele controles
Kwaadwillige clients kunnen vergiftigde updates indienen, sybil‑clients kunnen aggregatie vervormen, en een gecompromitteerde server kan een gericht model distribueren. Verdedigingen omvatten geauthenticeerde inschrijving, anomaliedetectie, robuuste aggregatie, update‑validatie, snelheidslimieten en reproduceerbare software‑attestatie waar praktisch.
Gefedereerd leren maakt deel uit van een breder cybersecurity-programma. Teams moeten documenteren wie de coördinator beheert, welke metadata worden verzameld, hoe deelnemers kunnen vertrekken, hoe modellen worden teruggedraaid en wat er gebeurt wanneer privacy‑ of kwaliteitstests falen.
Gefedereerde optimalisatie en data‑heterogeniteit
Gefedereerd leren stuurt een model of update‑taak naar deelnemende clients, traint lokaal en aggregeert updates zonder ruwe voorbeelden te centraliseren. Bij gefedereerde averaging voeren geselecteerde clients meerdere lokale optimalisatiestappen uit en berekent de server een gewogen gemiddelde, meestal op basis van het aantal voorbeelden. Communicatierondes, lokale epochs, selectie en leersnelheden ruilen bandbreedte in voor convergentie. Cross-device omgevingen omvatten veel onbetrouwbare telefoons of sensoren; cross-silo omgevingen omvatten minder organisaties met sterkere rekenkracht, identiteit en governance.
Cliëntdata zijn meestal niet‑independant en ongelijk: gebruikers verschillen in gedrag, label‑distributie, volume en beschikbaarheid. Lokale training kan afdrijven in incompatibele richtingen, waardoor een simpel gemiddelde onstabiel of bevooroordeeld wordt naar actieve, hoge‑volume clients. Algoritmen kunnen proximale termen, adaptieve server‑optimalisatie, clustering, personalisatie of controlevariabelen gebruiken. Evaluatie moet globale en client‑niveau prestaties, tail‑clients, deelname‑frequentie, convergentie, communicatie en energie rapporteren. Een goed gemiddelde kan verbergen dat kleine of zeldzame clientpopulaties een slechter model ontvangen.
Privacy, beveiliging en systeem‑engineering
Data lokaal houden garandeert niet automatisch privacy. Gradients en updates kunnen lidmaatschap of kenmerken lekken, terwijl het uiteindelijke model voorbeelden kan onthouden. Veilige aggregatie verbergt individuele updates voor de server, en differentiële privacy begrenst de informatiebijdrage door te clippen en ruis toe te voegen, maar beide wijzigen bruikbaarheid en operationele complexiteit. Definieer het threat‑model, de privacy‑eenheid, het budget en vertrouwde componenten. Encryptie tijdens transport is noodzakelijk, maar voorkomt geen kwaadwillige client, vergiftigde update, gecompromitteerde coördinator of inferentie‑aanval.
Verdedigingsmaatregelen omvatten geauthenticeerde clients, robuuste aggregatie, anomalie‑controles, update‑limieten, veilige enclaves in sommige ontwerpen, en validatie tegen schone data. Sybil‑aanvallers kunnen veel clients creëren; achterdeurtjes kunnen overleven na averaging; het verwijderen van verdachte updates kan ook legitiem zeldzaam gedrag uitsluiten. Versieer clientcode, ondersteun onderbroken rondes, voorkom replay, en ontwerp voor achterblijvers en apparaat‑beperkingen. Toestemming, retentie, regionale regels en verwijdering blijven van toepassing op lokale data en afgeleide updates.
Voorbeeld van implementatie en governance
Een mobiel toetsenbord kan lokaal verbeteringen voor het volgende woord trainen, maar de uitrol moet een populatie gebruiken die in aanmerking komt op basis van apparaatcapaciteit en toestemming, beschermde updates clippen en vergelijken met een bevroren referentie. Valideer taal‑ en dialectprestaties, batterij, datagebruik en memorisatierisico vóór release. Clients hebben ondertekende trainingstaken en modelupdates nodig; de server heeft een controleerbare ronde‑configuratie en rollback nodig. Gefedereerd leren is een architectuur voor gedistribueerd leren onder beperkingen, geen vervanging voor representatieve data, privacy‑engineering of verantwoording.
Voorbeeld: gefedereerd leren tussen ziekenhuizen
Ziekenhuizen trainen een gedeeld model voor beeldkwaliteit zonder scans te bundelen. Een gemeenschappelijk protocol definieert apparaatgegevens, labels, preprocessing, client‑geschiktheid, lokale epochs, clipping en veilige aggregatie. Locaties behouden patiëntgegevens en dienen beschermde updates in, terwijl een coördinator elke ronde evalueert op lokale hold‑out sets. Resultaten rapporteren prestaties per locatie en tail‑prestaties, niet alleen een volume‑gewogen gemiddelde, omdat kleine ziekenhuizen en apparaattype anders over het hoofd worden gezien.
Het threat‑model omvat kwaadwillende updates, lidmaatschapslekken, gecompromitteerde clients en toegang van de coördinator. Differentiële privacy wordt geconfigureerd met een gedocumenteerd budget en geteste bruikbaarheid. Model‑ en taak‑pakketten zijn ondertekend; locaties kunnen zich terugtrekken en updates zijn controleerbaar. Een vergiftigde of onstabiele ronde vervangt het uitgerolde model niet automatisch. Het project behoudt lokale baselines en klinische review, en beschouwt de gefedereerde architectuur als één privacy‑controle binnen bredere toestemming, beveiliging en governance‑verplichtingen.
Implementatie‑bewijs en operationele gereedheid
Een productiebeslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare baseline en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, grenscondities, misvormde of ontbrekende invoer, distributieverandering, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan scheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet de invoerkwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheidsstatus, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarmdrempels en een verantwoordelijke, en beoordeel vervolgens bewijsmateriaal uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Evalueer opnieuw wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijder‑ en retentieprocedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Garandeert gefedereerd leren dat privé‑data niet kunnen lekken?
Nee. Het vermindert de verplaatsing van ruwe data, maar updates en uiteindelijke modellen kunnen nog steeds informatie onthullen. Privacy vereist een threat‑model en extra technische en organisatorische controles.
Wanneer is gecentraliseerde training eenvoudiger?
Wanneer data wettelijk en veilig kunnen worden gecentraliseerd, is gecentraliseerde training vaak eenvoudiger te debuggen, reproduceren en monitoren. Gefedereerd leren is gerechtvaardigd wanneer distributie een reëel vereiste is, en niet slechts een marketingdoel.
Primaire referenties












