AI-modellen en platforms
Wat is de wet van Moore, en hoe beïnvloedt deze AI?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
De wet van Moore is de historische observatie dat economisch bruikbare geïntegreerde schakelingen hun aantal componenten in een exponentieel tempo leken te vergroten. Het is geen natuurkundige wet en stelt niet dat computers automatisch twee keer zo snel worden volgens een vaste planning.
Voor AI is transistordichtheid belangrijk omdat het meer rekenunits, geheugen en interconnecties mogelijk maakt. Maar praktische vooruitgang hangt ook af van architectuur, numerieke precisie, verpakking, geheugenbandbreedte, algoritmen, software, energie, fabricageopbrengst en de hoeveelheid bruikbare data.
Belangrijkste punten
- Het oorspronkelijke artikel van Moore uit 1965 beschreef een economische en technische trend, geen fysieke garantie.
- De schaalvergroting van kloksnelheid vertraagde; moderne winsten komen steeds meer voort uit parallelisme en gespecialiseerde versnellers.
- AI-prestaties worden vaak beperkt door geheugenverplaatsing en energie, niet alleen door rekenkracht.
- Vergelijk systemen op basis van latentie, doorvoersnelheid, kwaliteit, energieverbruik en totale kosten op werkbelastingsniveau – niet op basis van het aantal transistors.
Wat Moore werkelijk observeerde
Gordon Moore plaatste het aantal componenten in toonaangevende geïntegreerde schakelingen en voorspelde een blijvende snelle groei tegen minimale kosten per component. Later werd dit vaak samengevat als een verdubbeling ongeveer elke twee jaar, maar de formuleringen en gemeten grootheden varieerden.
Kleinere structuren kunnen de dichtheid verhogen en sommige schakelkosten verlagen, maar de complexiteit en economie van de productie bepalen of de trend bruikbaar blijft. Nodennamen zijn marketinglabels en moeten niet worden gezien als een directe fysieke vergelijking tussen foundries.
Van snellere cores naar heterogene computing
Dennard-achtige spanningsschaling maakte ooit hogere kloksnelheden mogelijk zonder evenredige vermogensgroei, maar die relatie verzwakte. Ontwerpers gingen over op multicore-CPU’s, GPU’s, tensorunits, chiplets, geavanceerde verpakking en domeinspecifieke versnellers.
Die heterogeniteit staat centraal in deep learning. Dichte matrixbewerkingen kunnen efficiënt worden uitgevoerd op parallelle hardware, terwijl CPU’s onregelmatige logica en gegevensverplaatsing coördineren. Het snelste onderdeel helpt niet als de pijplijn het niet kan voorzien.
Geheugen, precisie en algoritmen
Training en inferentie verplaatsen herhaaldelijk gewichten, activaties en cache‑data door een hiërarchie van on‑chip‑ en off‑chip‑geheugen. Bandbreedte, capaciteit, localiteit en communicatie kunnen de kosten domineren. Lagere numerieke precisie en kwantisering verminderen verplaatsing wanneer de kwaliteit acceptabel blijft.
Algoritmische verbeteringen kunnen de benodigde rekencapaciteit om een doelresultaat te bereiken verlagen. Sparse modellen, transformer-efficiëntiemethoden, betere optimalisatoren en data van hogere kwaliteit beïnvloeden allemaal de effectieve vooruitgang die gebruikers ervaren.
Hoe AI‑hardware te vergelijken
Piekbewerkingen per seconde zijn theoretisch. Gebruik een representatief model, batch‑grootte, sequentielengte, precisie, software‑stack en kwaliteitsdrempel. Rapporteer end‑to‑end‑latentie, doorvoersnelheid, energieverbruik, geheugengebruik, benutting en kosten.
Edge‑systemen kunnen privacy en laag stroomverbruik belangrijker vinden dan maximale doorvoersnelheid; datacenters kunnen de totale tokens of monsters per watt prioriteren. Edge AI maakt duidelijk waarom één kopcij‑cijfer niet elk bruikbaar systeem kan beschrijven.
Waarom semiconductor‑schaalvergroting veranderde
Vroege voortgang van geïntegreerde schakelingen combineerde kleinere apparaten, betere fabricage, lagere kosten per component en ontwerpverbeteringen. Jarenlang ondersteunden verkleinde transistorafmetingen snellere schakelingen en minder energie per bewerking. Uiteindelijk verzwakten lekstrom, spanningslimieten, warmte‑dichtheid, interconnect‑vertraging en fabricagekosten de eenvoudige relatie tussen een nieuw process‑node en snellere algemene cores.
Moderne vooruitgang is daarom multidimensionaal. FinFET‑ en gate‑all‑around‑apparaten verbeteren de elektrostatische controle; extreme‑ultraviolet‑lithografie ondersteunt kleinere patronen; chiplets stellen ontwerpers in staat dies van verschillende processen te combineren; geavanceerde verpakking brengt rekencapaciteit en geheugen dichter bij elkaar. Opbrengst en verpakking bepalen of een technisch indrukwekkend ontwerp economisch is bij volumeproductie.
De vertraging van één schaalmechanisme betekent niet dat hardware niet meer verbetert. Het betekent dat architecten transistors bewuster moeten inzetten. Gespecialiseerde eenheden ruilen flexibiliteit in voor doorvoersnelheid of efficiëntie bij geselecteerde werkbelastingen, terwijl grotere caches en interconnecties proberen die eenheden te voorzien.
Hoe AI‑werkbelastingen hardware belasten
Training wisselt af tussen forward‑computatie, backpropagation, optimizer‑updates en communicatie tussen versnellers. Inferentie varieert van batch‑scoring tot interactieve token‑generatie. Matrixvermenigvuldiging is belangrijk, maar embeddings, normalisatie, activatiefuncties, attention, routing, cache‑toegang en host‑orchestratie dragen allemaal bij aan de daadwerkelijke prestaties.
Rekenintensiteit — de hoeveelheid berekening per verplaatste byte — helpt verklaren of een werkbelasting compute‑ of bandbreedte‑gebonden is. Kleine batch‑groottes en autoregressieve decodering laten rekenunits vaak onderbenut omdat gewichten of cache‑data herhaaldelijk moeten worden opgehaald. Grotere batches verbeteren de benutting maar verhogen latentie en geheugen.
Het numerieke formaat verandert de afweging. FP32, BF16, FP16, FP8 en integer‑formaten verschillen in bereik, precisie, hardware‑ondersteuning en fout. Mixed‑precision‑training behoudt gevoelige bewerkingen op hogere precisie; gekwantificeerde inferentie vereist kalibratie en kwaliteits‑testen in plaats van de belofte dat elk model dezelfde bit‑breedte aankan.
Systeem‑economie en toekomstige richtingen
De totale AI‑kosten omvatten de aankoop of huur van versnellers, stroomvoorziening, koeling, netwerk, opslag, software‑engineering, ongebruikte capaciteit en mislukte experimenten. Een snellere chip kan in totaal duurder zijn als de benutting laag is of als het model een dure gedistribueerde topologie vereist. Meet de bruikbare output bij een gedefinieerde kwaliteitsdrempel.
Schaalvergroting wordt ook beperkt door data en algoritmen. Meer rekenkracht kan verkeerd gelabelde data of een evaluatie die shortcuts beloont niet herstellen. Efficiënte attention, betere optimalisatoren, sparsiteit, retrieval, distillatie en algoritmische ontdekkingen kunnen resultaten verbeteren zonder een evenredige hardware‑toename, hoewel ze de kosten elders kunnen verplaatsen.
Toekomstige systemen zullen proces‑innovaties combineren met driedimensionale stacking, high‑bandwidth‑memory, optische of geavanceerde elektrische interconnecties, domeinspecifieke datastromen en co‑ontworpen software. De wet van Moore blijft een waardevolle historische context, maar planning moet gebruikmaken van gemeten werkbelastingscurves en realistische leverings‑, energie‑ en implementatie‑beperkingen.
Moore’s Law correct interpreteren in een AI‑systeemontwerp
Een nuttige analyse scheidt transistordichtheid, algemene CPU‑prestaties, accelerator‑doorvoersnelheid, geheugencapaciteit, geheugen‑bandbreedte, interconnect, energie, fabricage‑opbrengst en kosten. Deze verbeteren niet met dezelfde snelheid. Een AI‑werkbelasting die vooral bestaat uit het verplaatsen van modelgewichten kan weinig winnen uit meer rekenunits, terwijl een klein on‑chip model aanzienlijk kan profiteren van gespecialiseerde low‑precision‑hardware. Citeer de exacte metriek, precisie, werkbelasting en vermogens‑envelop in plaats van een process‑node als prestatie te behandelen.
Het schalen van een AI‑model verandert ook de software‑ en systeemvereisten. Grotere trainingsruns hebben parallelle algoritmen, betrouwbare checkpointing, hogesnelheidsnetwerken, opslag‑pijplijnen en voldoende data nodig om de extra capaciteit te benutten. Bij inferentie hangt de latentie af van de prompt‑lengte, gegenereerde tokens, batching, cache‑geheugen en service‑level‑doelstellingen. Algoritmische verbeteringen, sparsiteit, kwantisering, retrieval en betere data kunnen winsten opleveren die onafhankelijk zijn van transistor‑trends en soms een hardware‑generatie overtreffen.
Voor planning, benchmark representatieve modellen op kandidaat‑systemen en modelleer de totale kosten over de levensduur van de inzet: aanschaf‑ of cloud‑prijs, stroom, koeling, benutting, engineering, migratie en leveringsrisico. Gebruik scenario’s in plaats van één exponentiële prognose. De wet van Moore blijft een waardevolle historische observatie over integratie‑economie, maar garandeert niet dat AI proportioneel sneller, goedkoper, capabeler of duurzamer wordt volgens een vaste planning.
Praktische implementatie‑checklist
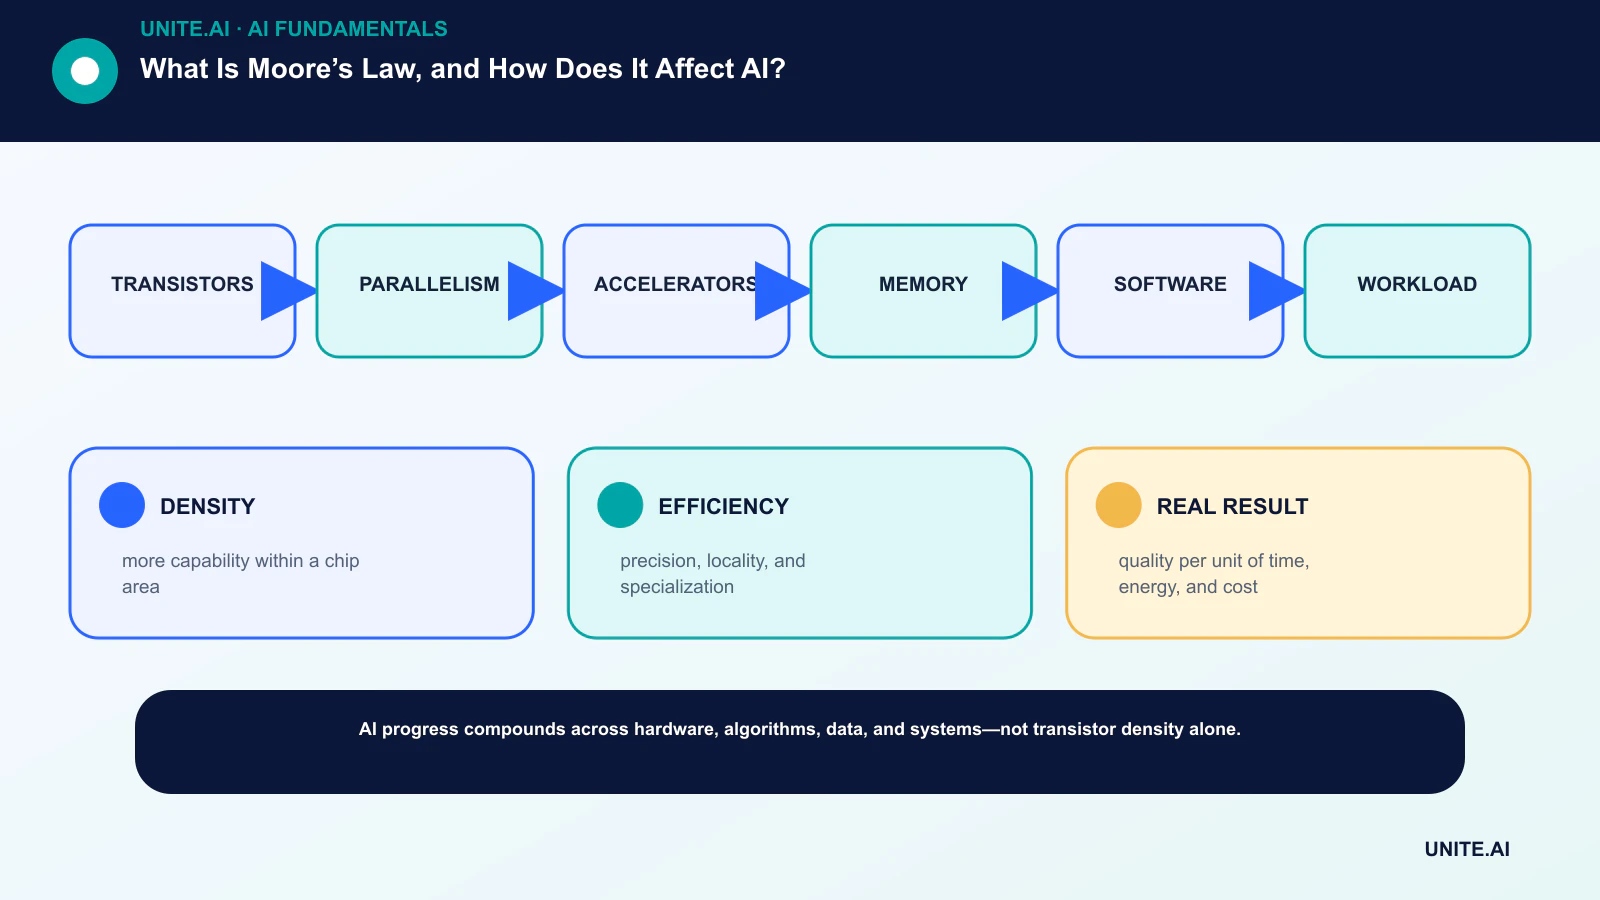
Zet het concept om in een begrensde, testbare workflow: transistors → parallelisme → versnellers → geheugen → software → werkbelasting. Benoem een verantwoordelijke eigenaar, documenteer de data en afhankelijkheden, stel een eenvoudige baseline op, definieer acceptatie‑ en stopcriteria, test representatieve fouten, en bepaal monitoring, rollback en review voordat de scope wordt uitgebreid. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpt wat er veranderd is.
Voordat je lanceert, voer een gedocumenteerde readiness‑review uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden beïnvloed. Test normale gevallen, grensvoorwaarden, afhankelijkheids‑fouten en misbruik; bewaar het bewijs en onopgeloste risico’s. Definieer wie de release kan goedkeuren, een drempel kan aanpassen, een output kan overschrijven of de werking kan stoppen. Herzie de beslissing zodra real‑world‑data beschikbaar is, want een technisch geslaagde pilot garandeert geen betrouwbare prestaties op grotere schaal.
- DENSITY: meer capaciteit binnen een chip‑oppervlak.
- EFFICIENCY: precisie, localiteit en specialisatie.
- REAL RESULT: kwaliteit per eenheid tijd, energie en kosten.
Veelgestelde vragen
Is de wet van Moore voorbij?
De eenvoudige historische trend is vertraagd en heeft van karakter veranderd, maar semiconductor‑voortgang zet zich voort via apparaten, architectuur, verpakking, geheugen en software. Of de uitdrukking nog passend is, hangt af van de metriek.
Betekent twee keer zoveel transistors twee keer de AI‑prestaties?
Nee. Prestaties hangen af van hoe transistors worden gebruikt en van bandbreedte, precisie, modelstructuur, software‑efficiëntie, vermogen en werkbelasting‑beperkingen.
Primaire referenties